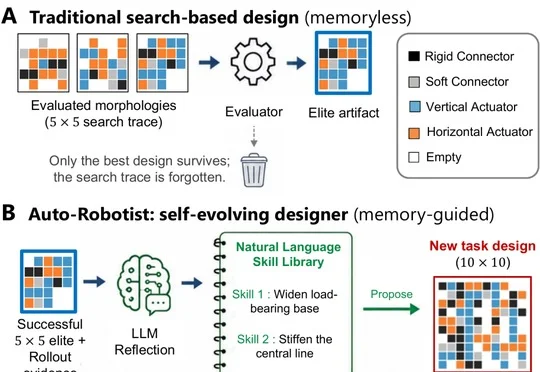
EMNLP'26|AI机器人协同设计智能体:每一次试错都留下经验
EMNLP'26|AI机器人协同设计智能体:每一次试错都留下经验密歇根大学安娜堡分校团队提出并开源AI机器人协同设计智能体Auto-Robotist,相关工作获EMNLP'26主会录用,并在EvoGym七项任务的5×5冷启动实验中以持续更新的技能库复用试错经验,平均最终最优得分高于遗传算法。
来自主题: AI技术研报
8182 点击 2026-11-07 14:46

 搜索
密歇根大学安娜堡分校团队提出并开源AI机器人协同设计智能体Auto-Robotist,相关工作获EMNLP'26主会录用,并在EvoGym七项任务的5×5冷启动实验中以持续更新的技能库复用试错经验,平均最终最优得分高于遗传算法。
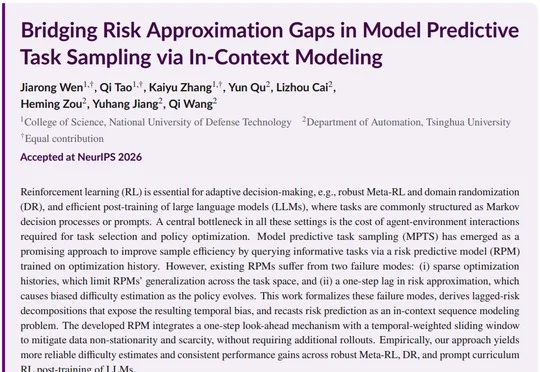
国防科技大学与清华大学团队提出ICRPM(In-Context Risk Predictive Model),利用近期任务—风险记录预测策略更新后的风险,在无需额外rollout或环境交互的情况下提升大模型RLVR、Meta-RL及鲁棒控制中的任务排序与训练效果。
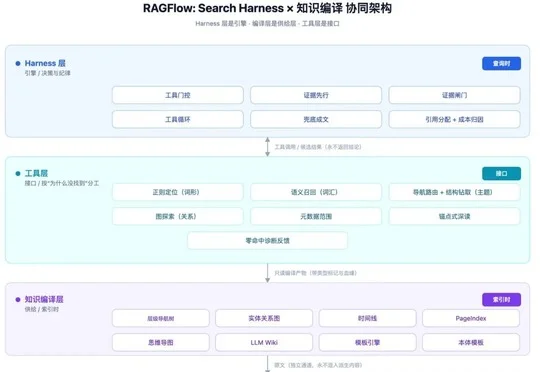
RAGFlow 1.0 以 Go 重写并公开知识编译层与 Retrieval Harness,将产品定位升级为 Agent Native 数据库,通过证据链等编译产物降低 Token 消耗并提升上下文可追溯性。
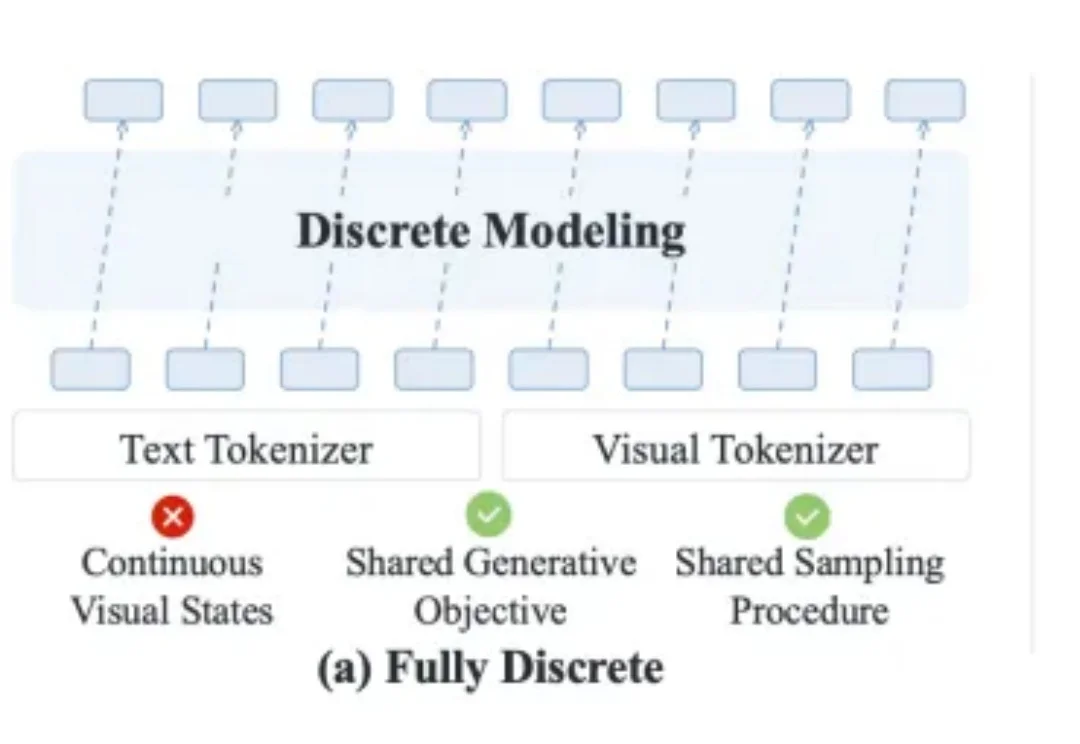
走向物理 AI 时代,构建一个能真正统一语言与视觉的多模态基座模型是关键一步。然而,语言本质上是有序的 Token 序列,视觉则是连续的高维像素分布,两者在信息结构上存在天然的鸿沟。如何在一个模型内统一这两种截然不同的分布,一直是一个备受争论的话题。
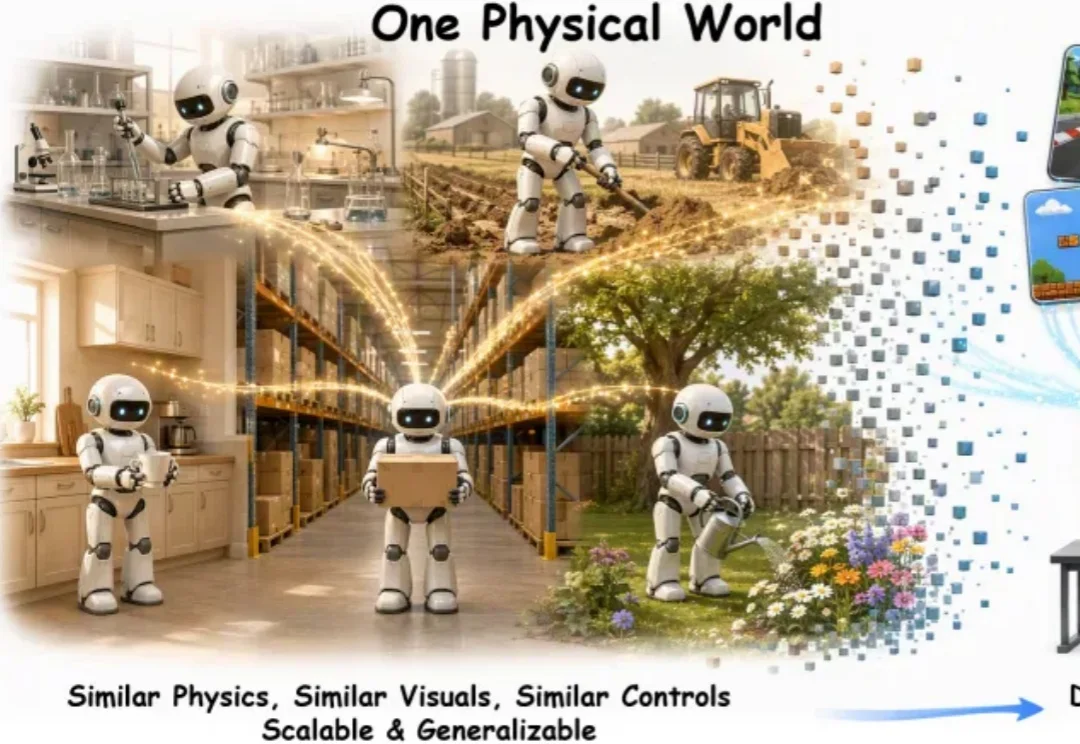
近日,米哈游联合清华大学、香港大学、新加坡国立大学等学术机构,开源首个通用游戏模型 GameScaling 系列:覆盖 0.8B、2B、9B、27B 四档规模,共八个模型,权重与推理代码均以 Apache 2.0 协议发布。
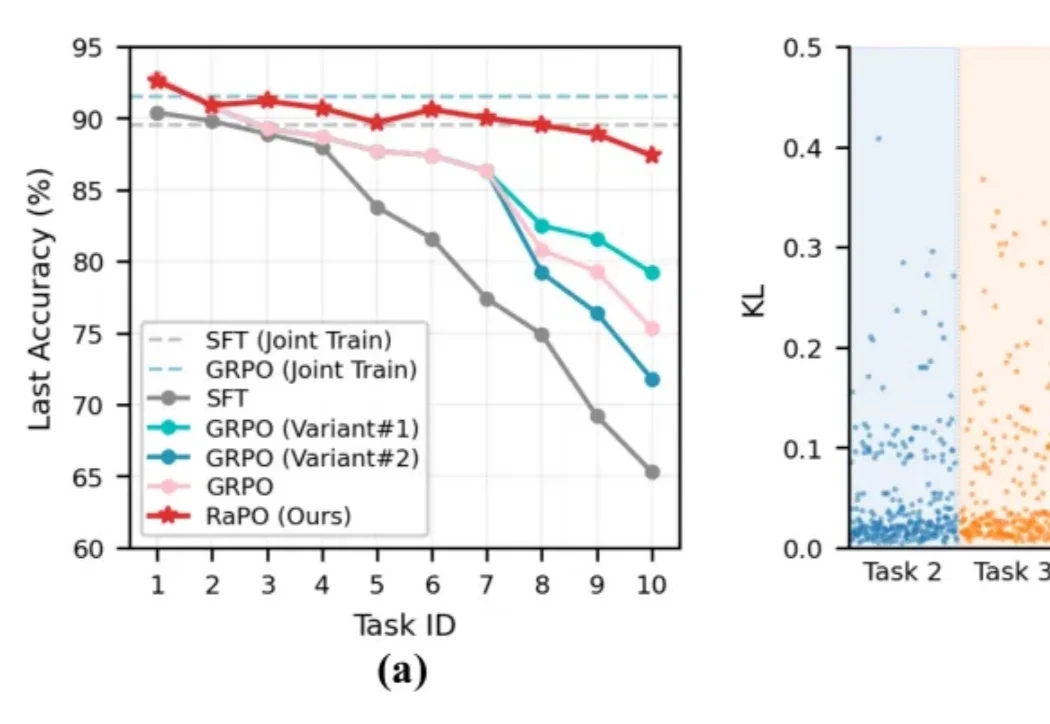
在 LLM/MLLM 领域,基于 verifier 奖励的强化微调(Reinforcement Fine-Tuning, RFT,如 GRPO)在激发复杂推理能力方面展现出显著优势。由于 On-policy 优化的特性,很多研究指出 RFT 相比传统的监督微调(SFT)天然具备更强的抗遗忘能力。
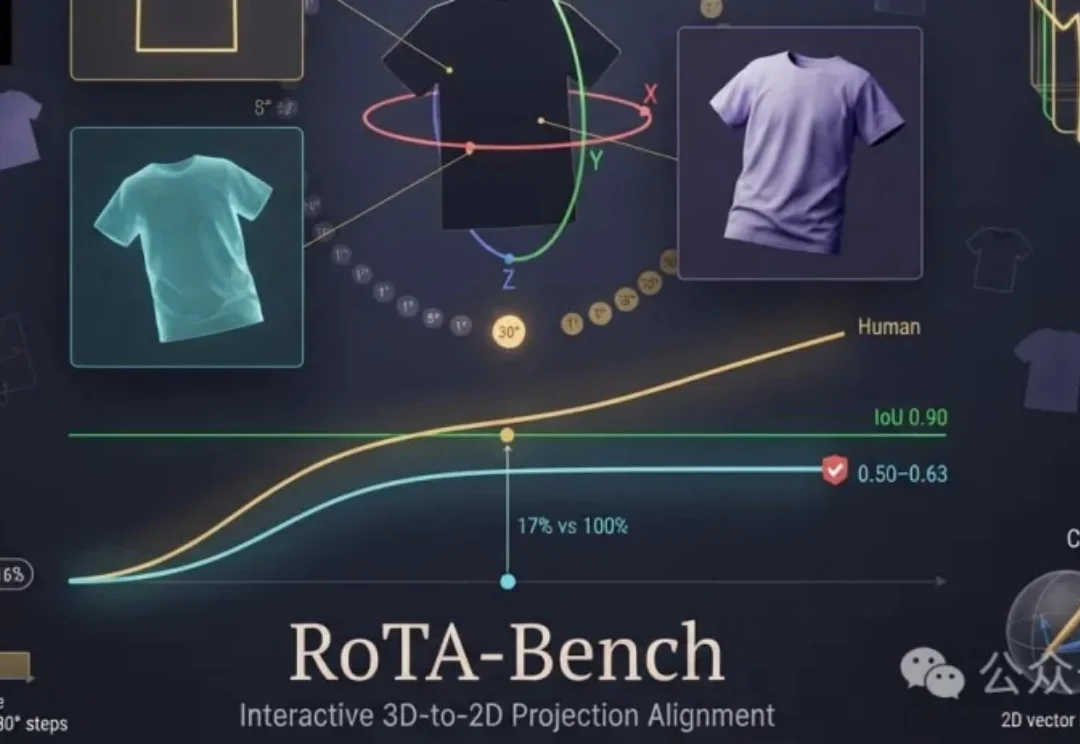
认出一个物体之后,换个角度还能认出来,进一步想象它转动后的样子,这些都涉及空间感知。人类需要在头脑中表示物体的形状与方向,理解不同视角之间的关系,并从二维投影中推断三维几何。
Sören Mindermann与Alan Chan牵头、包括Geoffrey Hinton在内的22位学者共同署名的RSI论文提出,在AI研发完全自动化等假设下,研发速度可能在约一年半内提高十倍,但这并非现实时间预测。
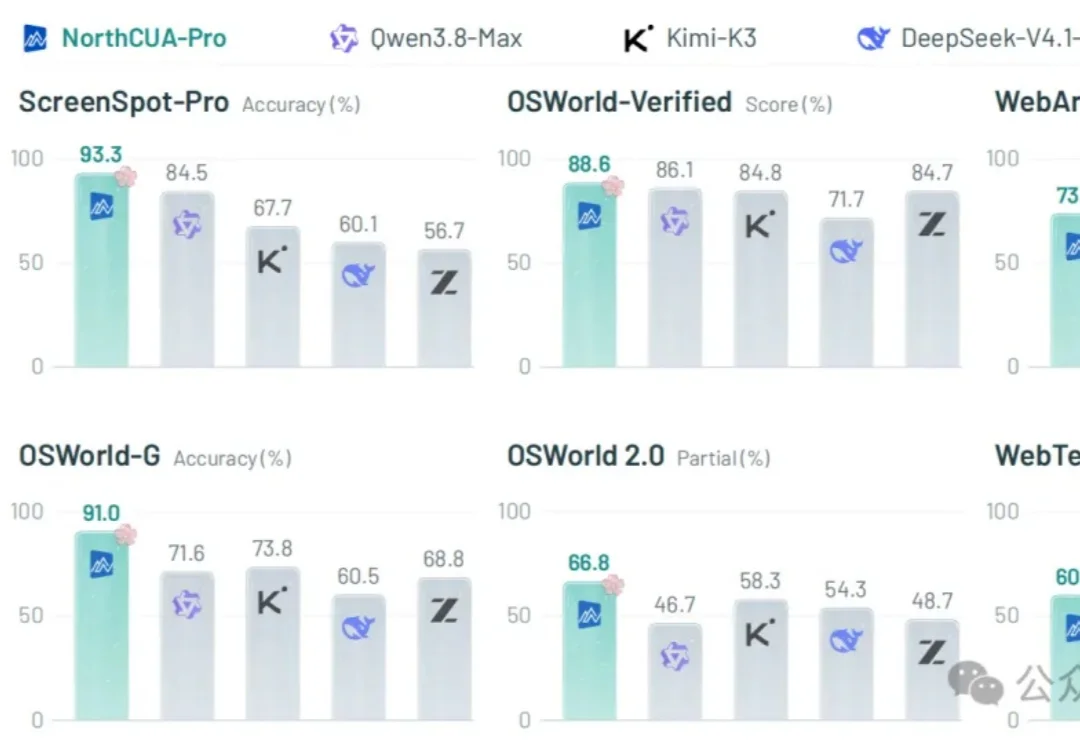
周二,北坡的 NorthCUA 团队,突然带来了一套相当完整的电脑智能体开源成果。
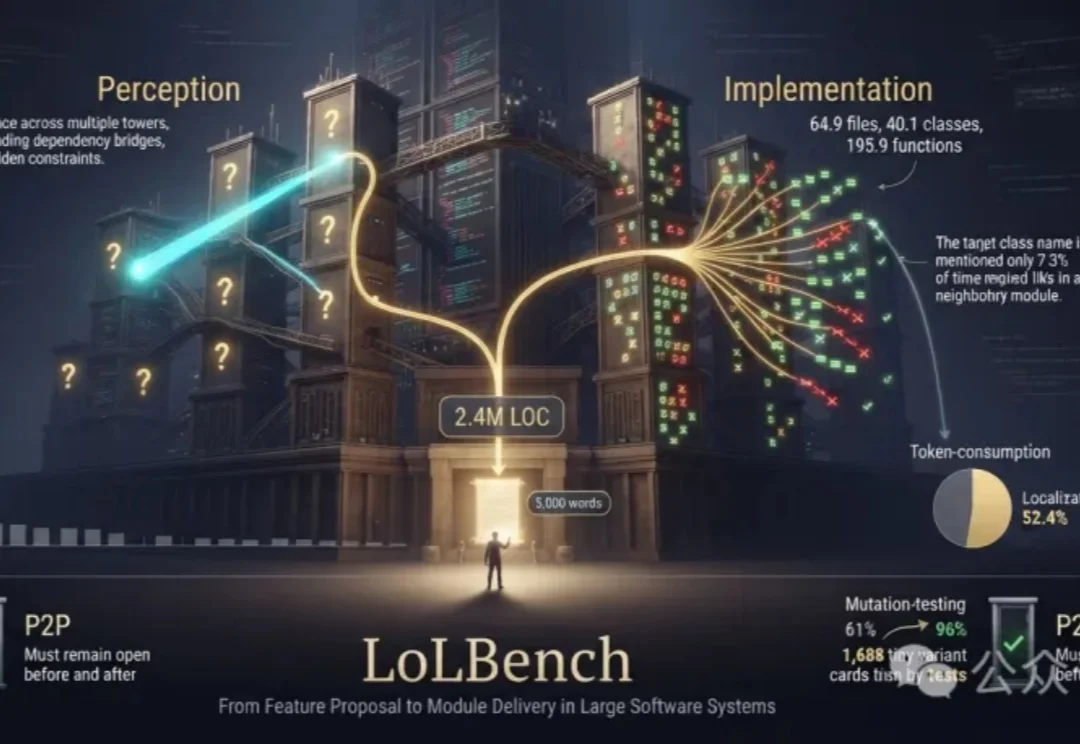
如今Agent已经能熟练调用工具、修改文件、运行测试,但面对一个长期演进的大型软件系统,它能否从一份新需求出发,交付完整功能?