不用训练!Opus 5.5直接手写Transformer权重,13类任务全拿100%
不用训练!Opus 5.5直接手写Transformer权重,13类任务全拿100%在13类复杂的算法任务、26次独立运行中,一个全新的神经网络在隐藏测试集上全部达到了100%的准确率。
来自主题: AI技术研报
10232 点击 2026-11-19 14:48

 搜索
在13类复杂的算法任务、26次独立运行中,一个全新的神经网络在隐藏测试集上全部达到了100%的准确率。
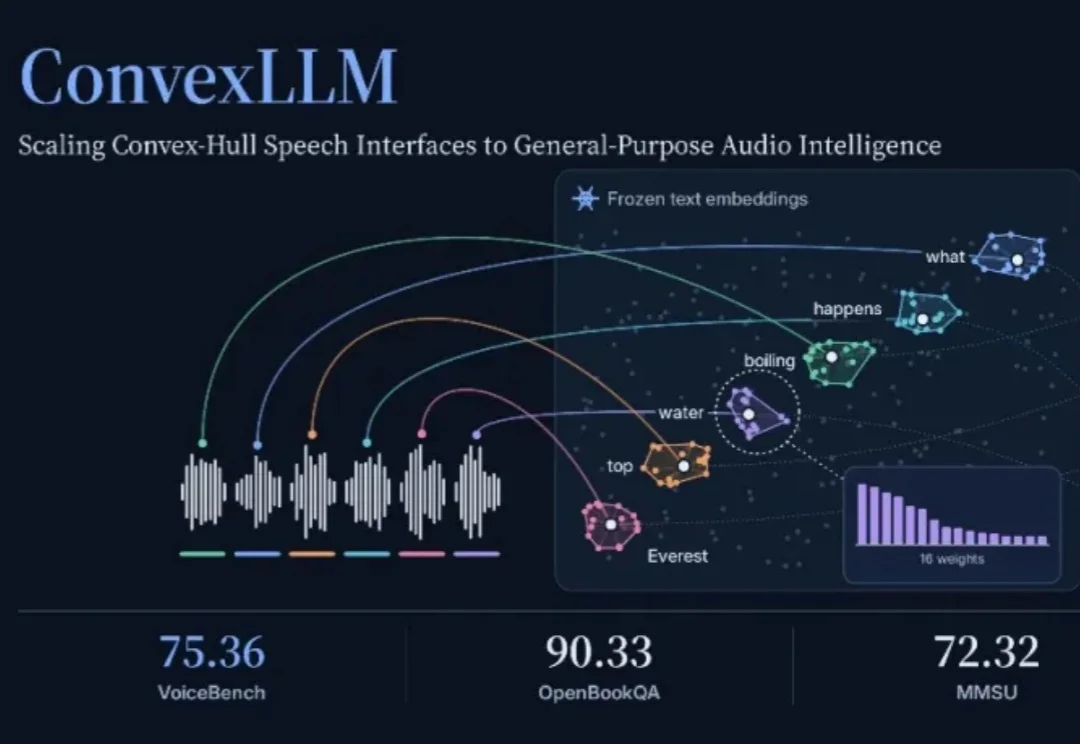
此次提出的 ConvexLLM,通过创新的 C-Gate 架构,将语音信息映射至大语言模型原有文本词向量的凸包中,使模型能够充分发挥已有的知识储备与推理能力。在 VoiceBench 等多项基准测试中,ConvexLLM 取得了同量级开源模型中的领先表现,为语音与语言的统一建模提供了新的技术路径。
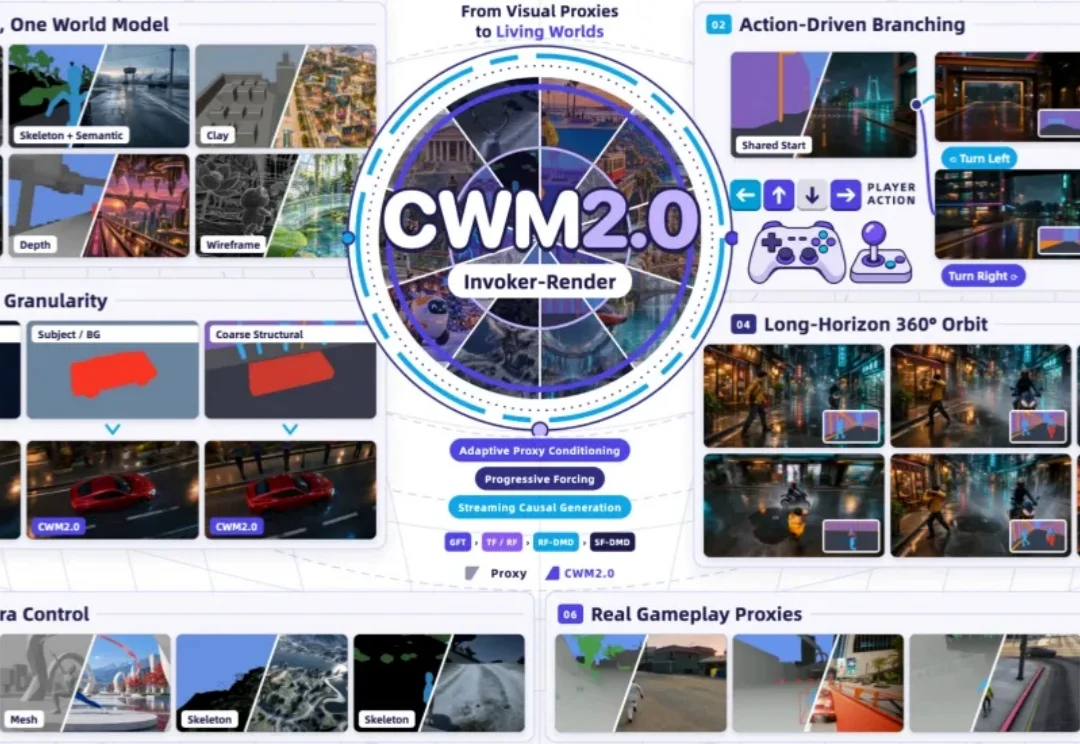
创造一个世界不难,难的是让这个世界「听话」。
开发一个新应用时,能不能直接用上 Agent,让它读取业务状态、调用工具,甚至和其他 Agent 一起完成任务?
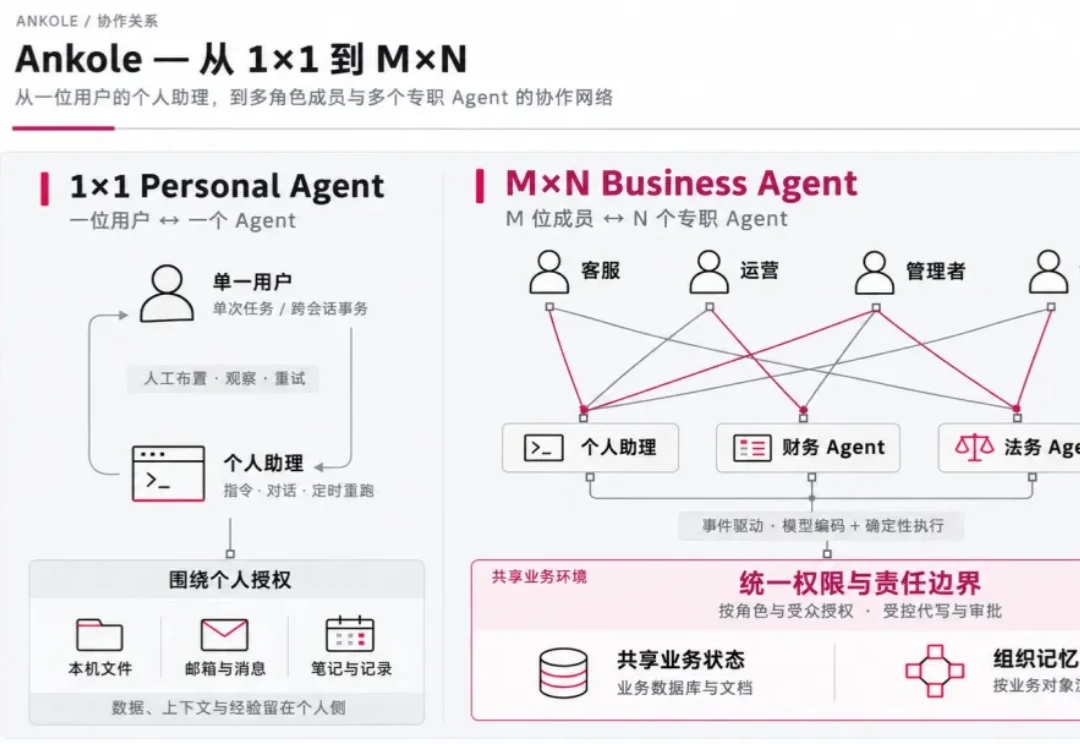
继 Coding Agent 之后,Muse、Grok Bot 等 Personal Agent 产品也快速成熟。不少团队尝试把它们引入组织:要么给每位成员部署一套,要么把同一个 Agent 接进部门群聊。但单人使用表现稳定的 Agent,一旦放到多人协同场景总是表现得非常不及预期。
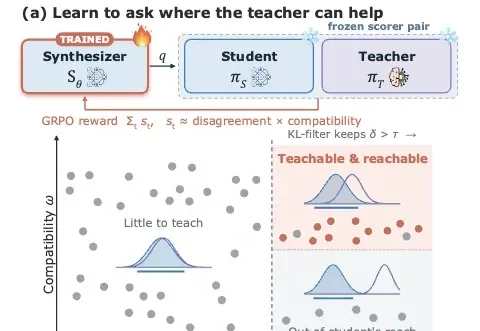
一道好问题,可能比一千道普通问题更有价值。
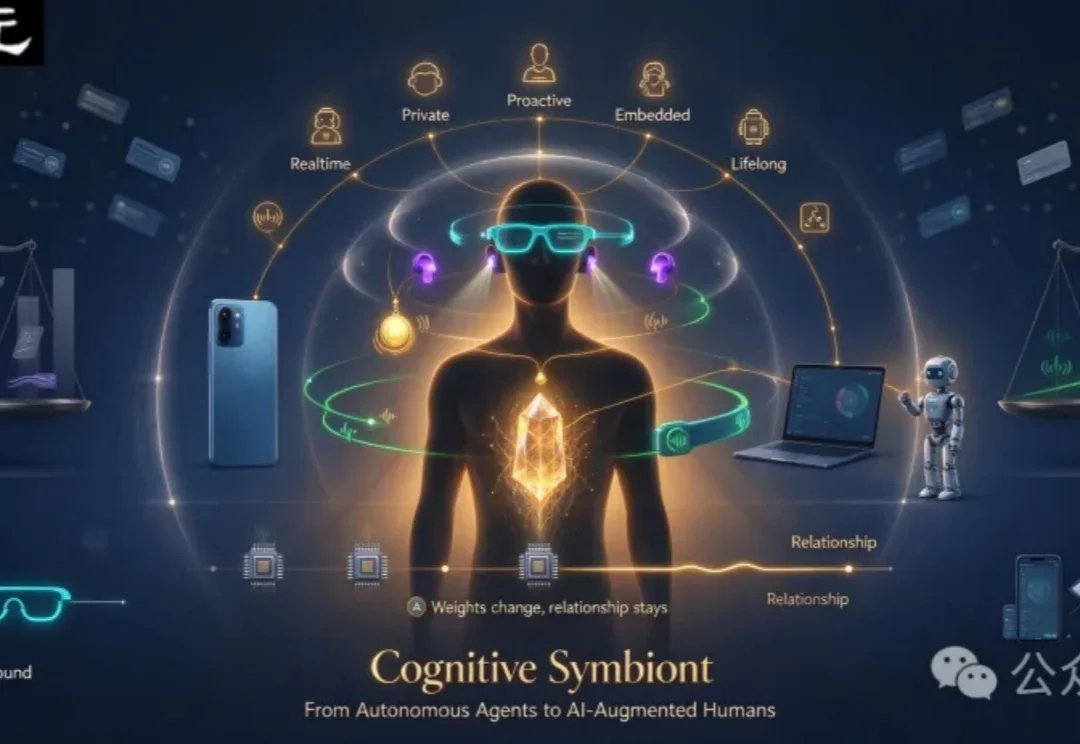
2008年,《钢铁侠》第一部上映。
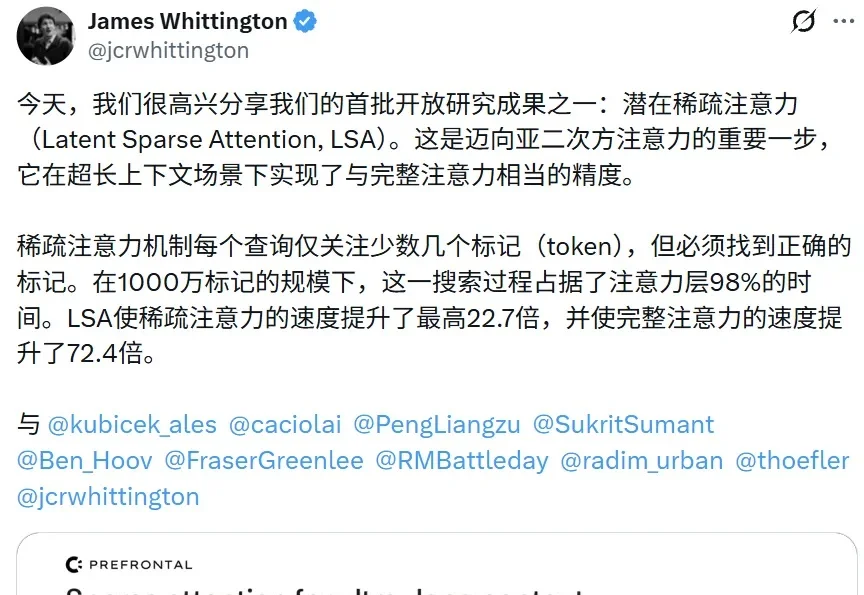
如今,百万 token 上下文已经从卖点变成了标配。4 月,DeepSeek-V4 把 1M 上下文定为所有官方服务的默认规格;8 月,智谱发布的 GLM-5.3-Flash 同样支持 1M 上下文,并首次在 GLM 系列中引入稀疏注意力与线性注意力的混合架构。这些模型背后有一个共同的选择:让每个 query 不再看遍所有历史 token,只挑出少数最相关的去「看」。
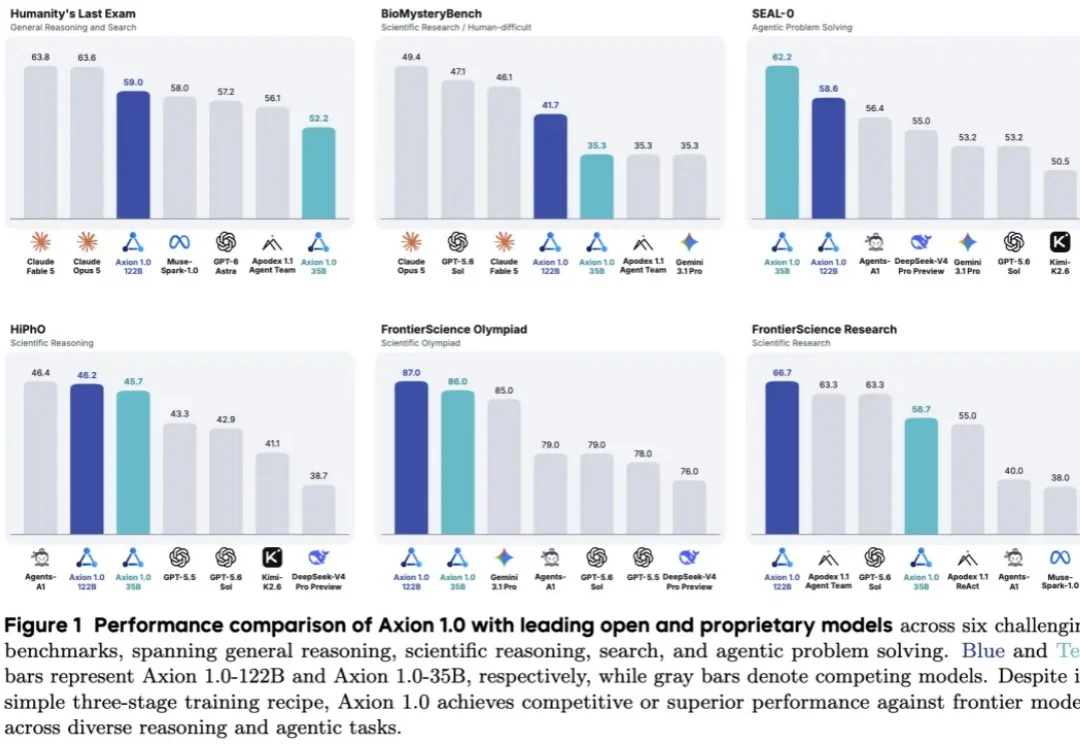
能搜索资料、运行代码,还能完成多步科学研究任务——训练这样的智能体,究竟需要多少道工序?
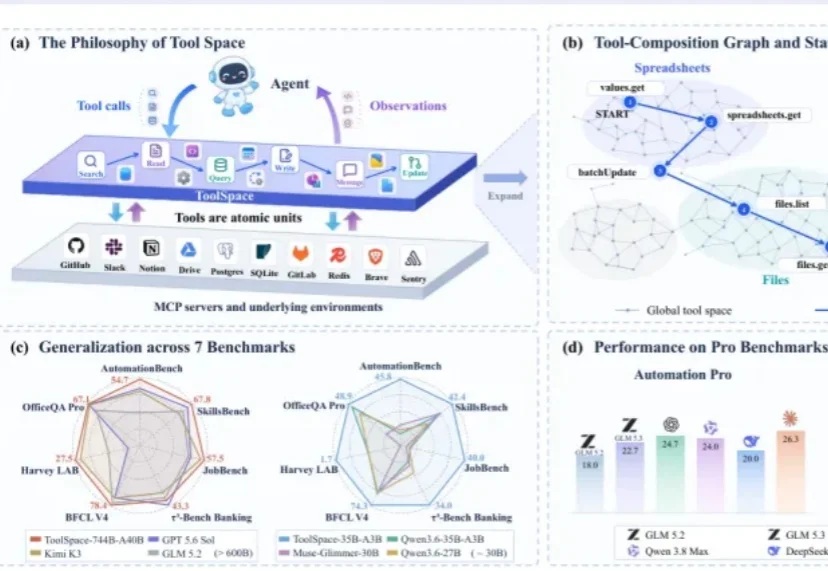
给智能体造训练环境,一定要先从数据库开始吗?现有的环境合成方法通常以数据为中心,先生成数据库和业务场景,再据此构造工具与任务。但沿着这条路线,工具接口和参数逻辑可能偏离真实定义,工具组合也可能缺少执行依据,任务往往局限于单个环境。