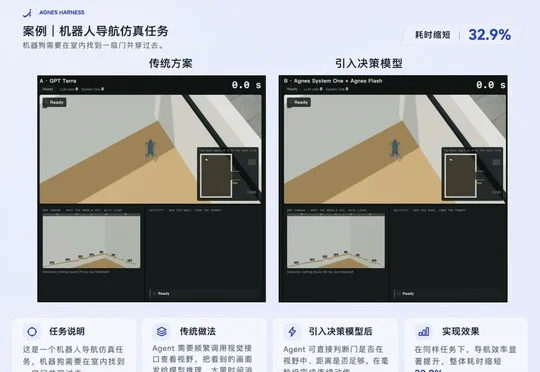
支撑Anthropic市值的RSI!Agnes亮出TTT×Harness双RSI进化架构
支撑Anthropic市值的RSI!Agnes亮出TTT×Harness双RSI进化架构Agnes AI开源智能体框架Agnes Harness,以Agnes Sys1 1.0、TTT和RSI实现快速决策、现场适应与持续复盘,并在九项公开基准自评中取得多项领先成绩。
来自主题: AI资讯
7387 点击 2026-11-20 15:13

 搜索
Agnes AI开源智能体框架Agnes Harness,以Agnes Sys1 1.0、TTT和RSI实现快速决策、现场适应与持续复盘,并在九项公开基准自评中取得多项领先成绩。
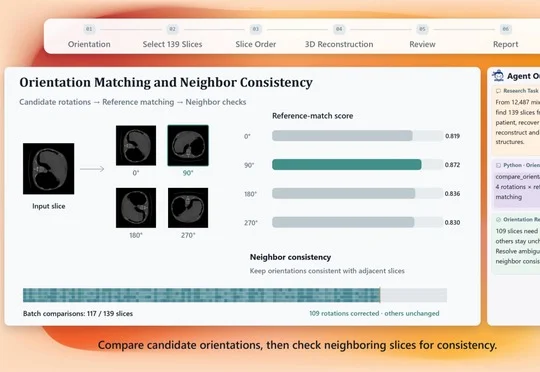
上海人工智能实验室联合多家科研机构与高校发布Sage S2.1 Flash技术报告,披露320B混合专家模型的科学多模态感知与智能体后训练流程,并在四项基准评测中取得第一。
你让AI帮忙修一个登录报错。
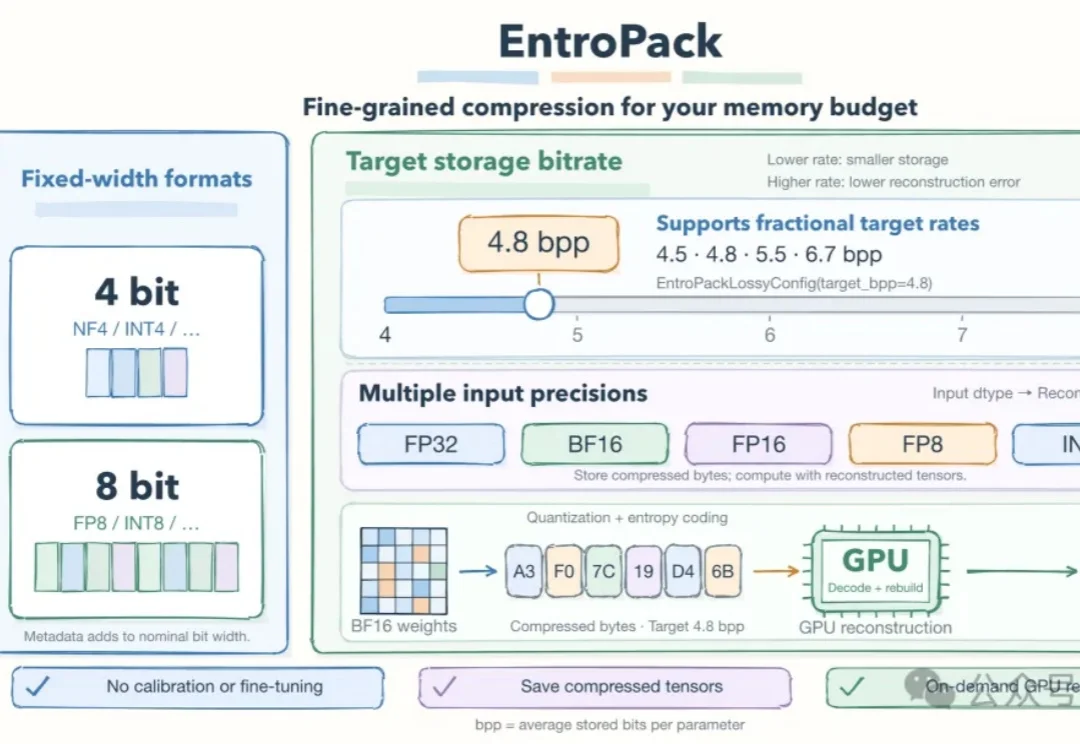
模型的量化,是降低大模型实际运行和部署门槛的重要手段。
过去十年,AI 的进步只被一把尺子衡量:机器自己能做成多少事。
大模型军备竞赛打到今天,训练成本成了一个停不下来的无底洞。国外已经在讲 10 万亿参数,国内大厂也纷纷设想 2 万亿、5 万亿。
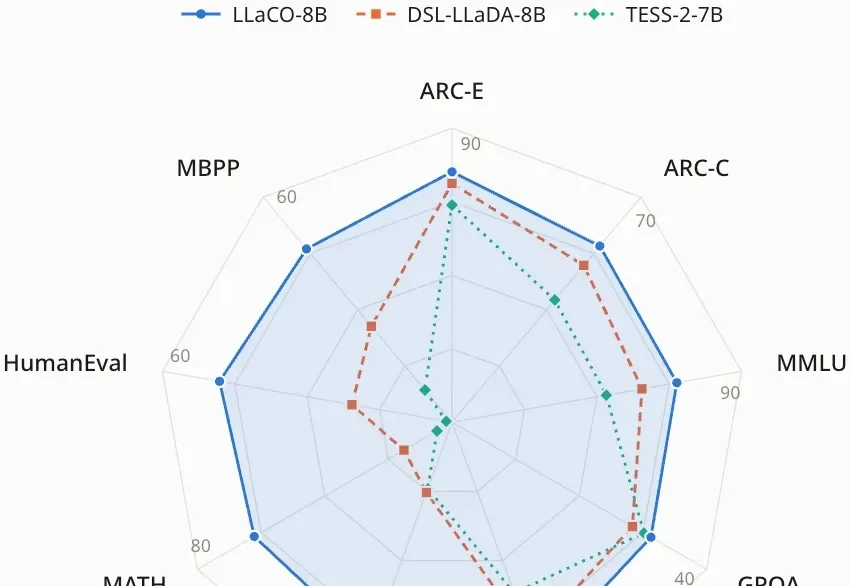
大语言模型生成文本,并不只有“从左往右单向蹦字”这一条路。
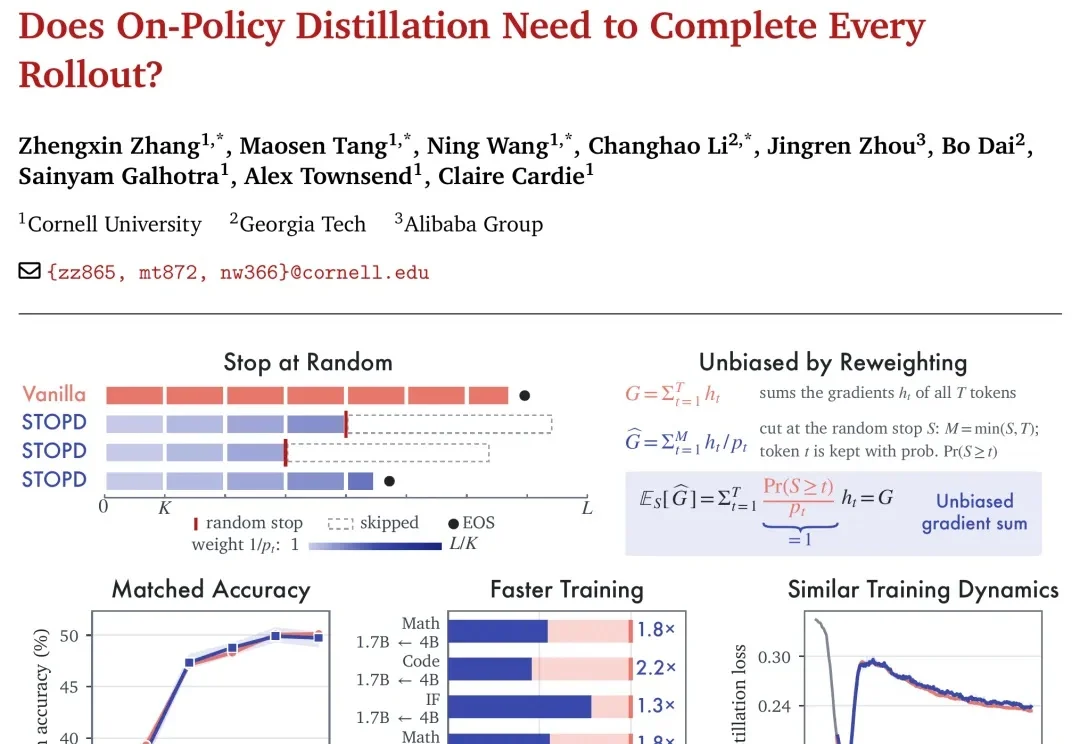
On-policy distillation(OPD)的做法很简单:先让学生自己生成回答,再由教师逐 token 提供反馈,指导学生更新。这样教师就能直接针对学生实际生成的内容进行指导,而不必依赖预先准备好的答案。问题在于,每一轮训练都需要学生生成完整的回答,之后教师还要对每个位置进行评估。随着回答变长,训练成本也会越来越大。
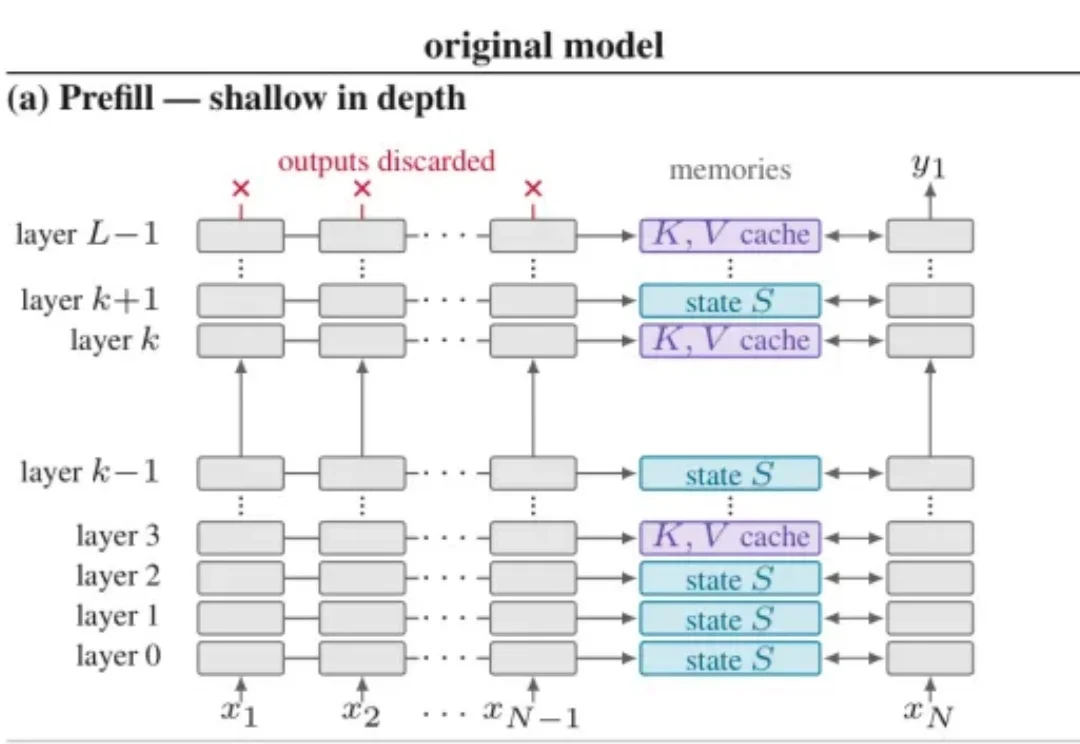
Qwen3.8-Flash-Next 有 48 层。处理一段输入时,SEED 让除最后一个以外的 token 只运行前 31 层,再由轻量的记忆写入组件,为后续 17 层生成 KV Cache 和循环状态。到了生成阶段,每个 token 仍然运行完整的 48 层。
编程智能体已经能在数字世界完成复杂任务。