AI资讯新闻榜单内容搜索-模型训练

AITNT-国内领先的一站式人工智能新闻资讯网站
# 热门搜索 #
搜索: 模型训练
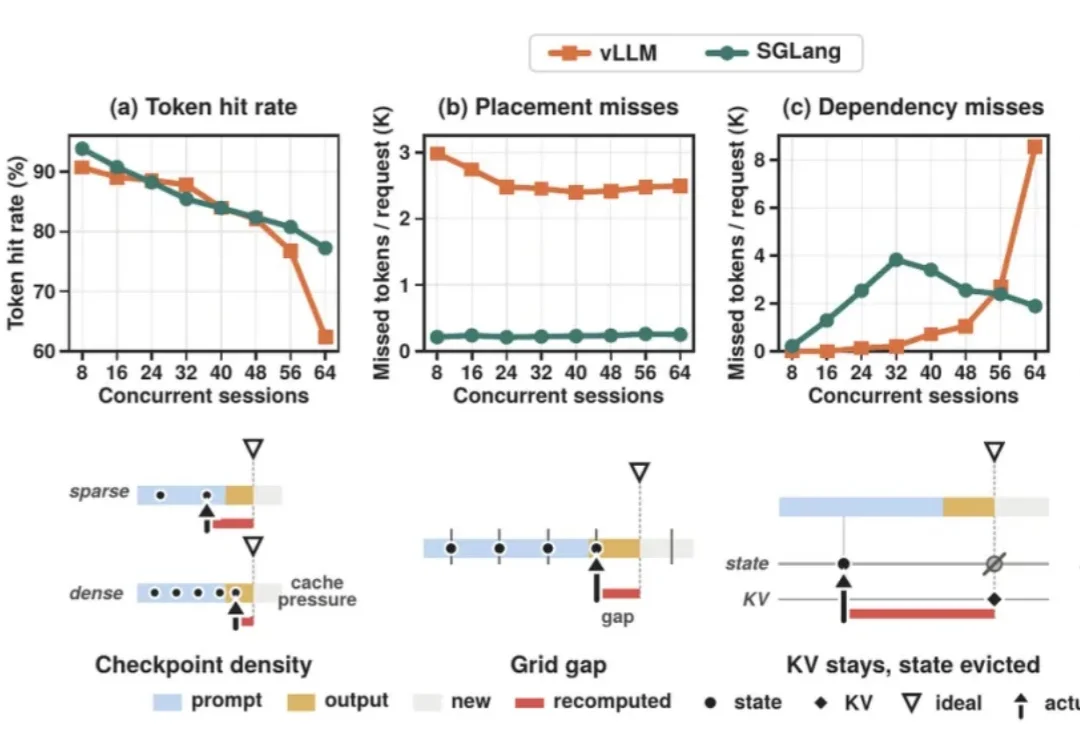
混合架构模型跑Agent,预填充吞吐再提升3倍!FlashStates重新设计混合状态缓存

混合架构模型跑Agent,预填充吞吐再提升3倍!FlashStates重新设计混合状态缓存

混合架构模型跑Agent,预填充吞吐再提升3倍!FlashStates重新设计混合状态缓存

Kimi Delta Attention(KDA)、Gated DeltaNet(GDN)、Mamba-2 等线性注意力与状态空间层,正在成为开源大模型的常见组件。Kimi K3.1 Pro、GLM-5.3-Flash、Qwen3.8-Flash-Next、Nemotron 3 Super 都采用了「全注意力 + 线性层」的混合架构,以换取更快的解码和更小的 KV Cache。

来自主题: AI技术研报
8904 点击    2026-11-17 10:05
Weitu AI打造能记忆会思考的流式多模态大脑

Weitu AI打造能记忆会思考的流式多模态大脑

Weitu AI打造能记忆会思考的流式多模态大脑

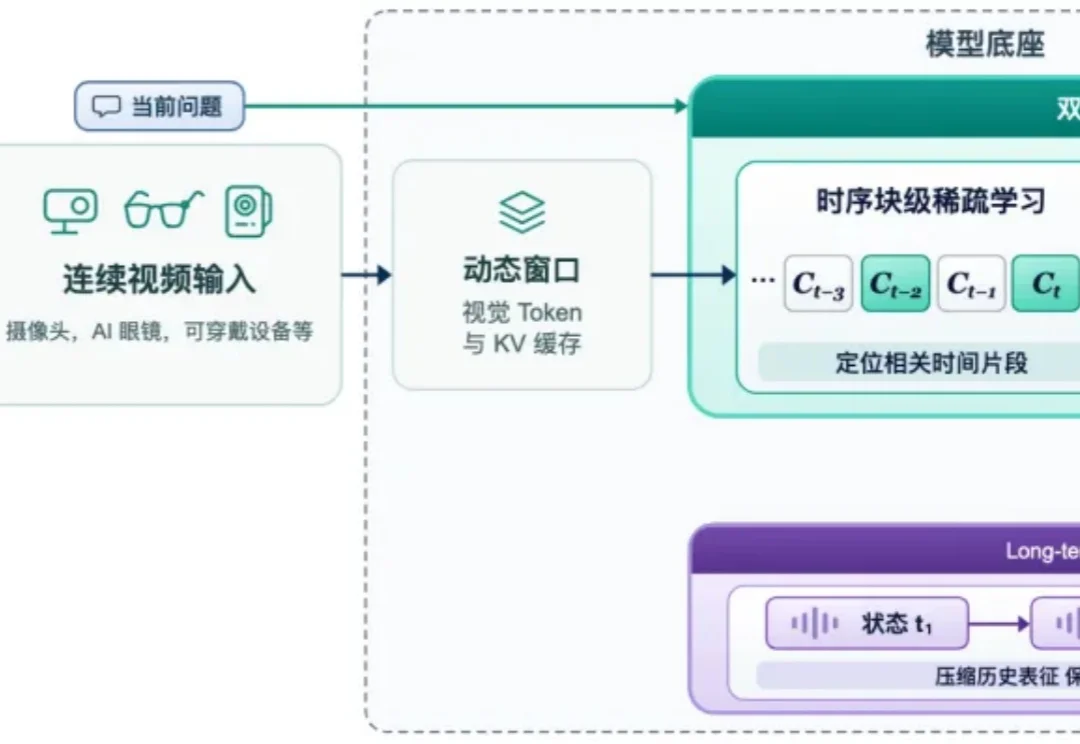
戴着 AI 眼镜出门前,问 AI 一句 “刚才把钥匙放在哪里了”;一场会议结束后,让 AI 助手回顾 “白板上的方案和最开始相比改了哪些地方”;戴着可穿戴摄像头设备的维修师傅正在进行检修的时候,被视频大脑提醒到 “刚才关闭阀门的动作没有完成,请重新检测一遍”。

来自主题: AI资讯
8716 点击    2026-11-16 15:45
自研Agent两场实测均分超过GPT-6,NovaSilicon首提CDK,Fabless之后是Designless?

自研Agent两场实测均分超过GPT-6,NovaSilicon首提CDK,Fabless之后是Designless?

自研Agent两场实测均分超过GPT-6,NovaSilicon首提CDK,Fabless之后是Designless?

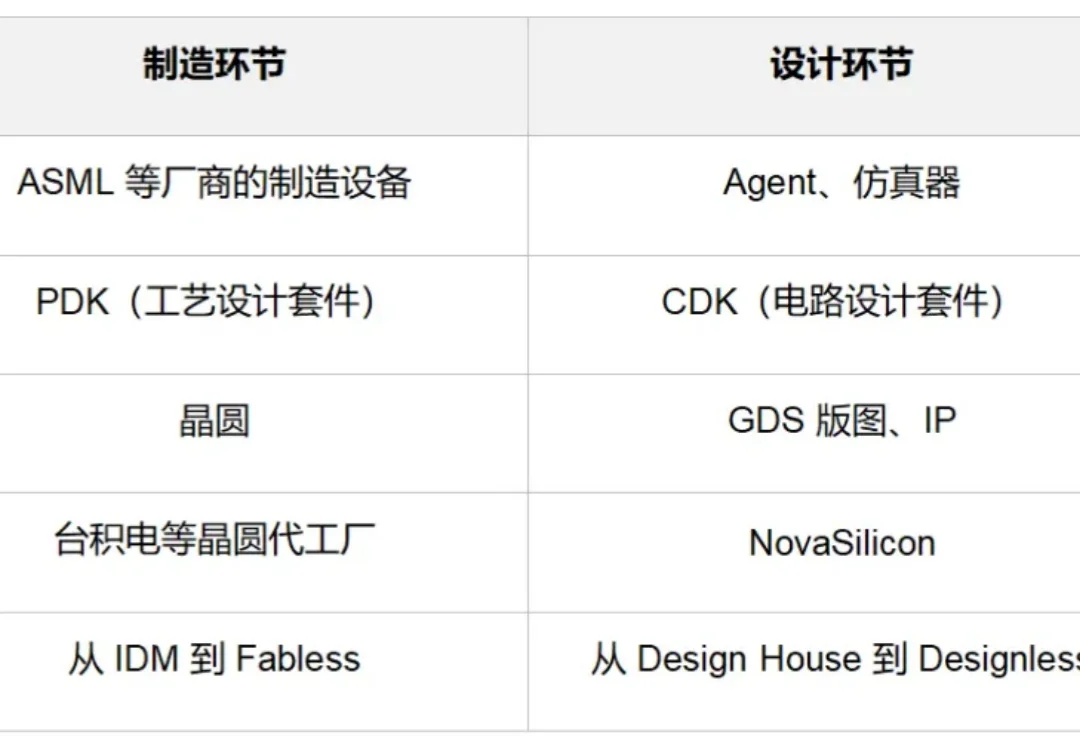
1987 年成立的台积电只做代工。晶圆厂把制造工艺封装成 PDK(Process Design Kit,工艺设计套件)交给客户,PDK 是晶圆厂的核心技术,通过有限接口分享给芯片公司 ,保留核心的制造配方。通过使用 PDK,芯片公司可以把制造交出去,自己专心做设计,这类公司被叫作 Fabless。

来自主题: AI技术研报
6023 点击    2026-11-16 15:43
NeurIPS 2026|不再依赖外挂:清华把「自我进化技能」训进Agent大脑

NeurIPS 2026|不再依赖外挂:清华把「自我进化技能」训进Agent大脑

NeurIPS 2026|不再依赖外挂:清华把「自我进化技能」训进Agent大脑

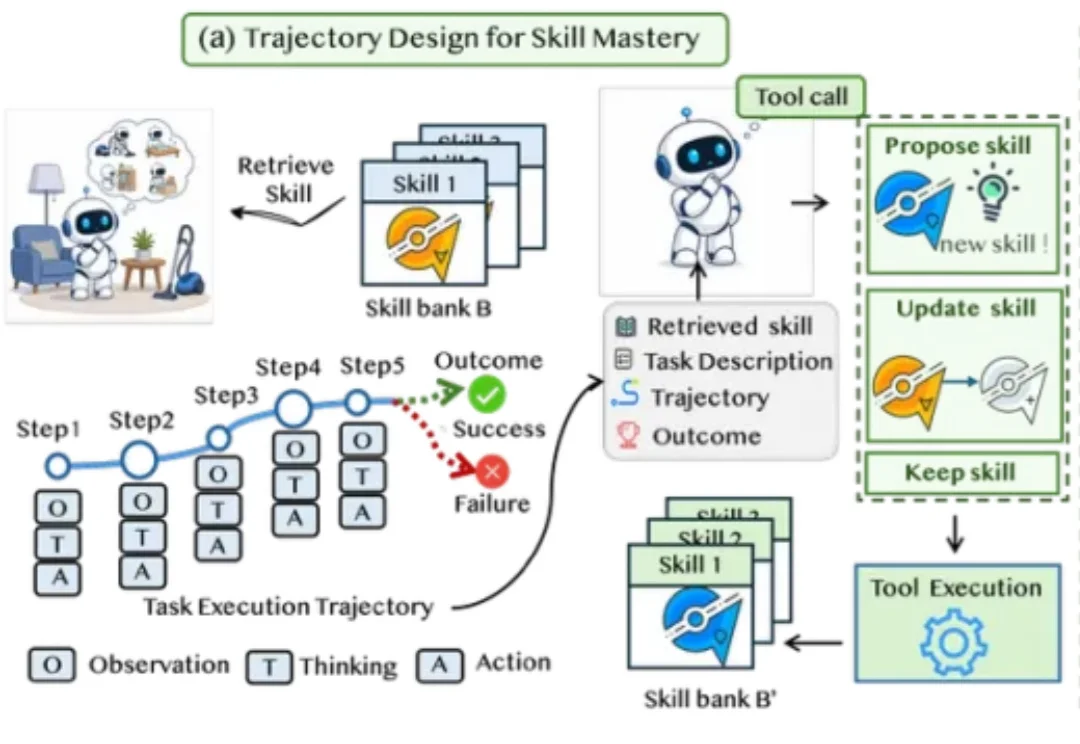
随着递归自我改进(Recursive Self-Improvement,RSI)研究的兴起,智能体的长期能力演进受到更多关注。技能(Skill)能够将交互经验提炼为可复用的操作流程与任务策略,使一次任务的收获服务于后续任务。让智能体学会自主创建和改进这些技能,为其持续进化提供了一条具体路径。

来自主题: AI技术研报
9024 点击    2026-11-16 15:13
VLM记忆机制最新综述,从When, Where, What, How四个维度看懂记忆

VLM记忆机制最新综述,从When, Where, What, How四个维度看懂记忆

VLM记忆机制最新综述,从When, Where, What, How四个维度看懂记忆

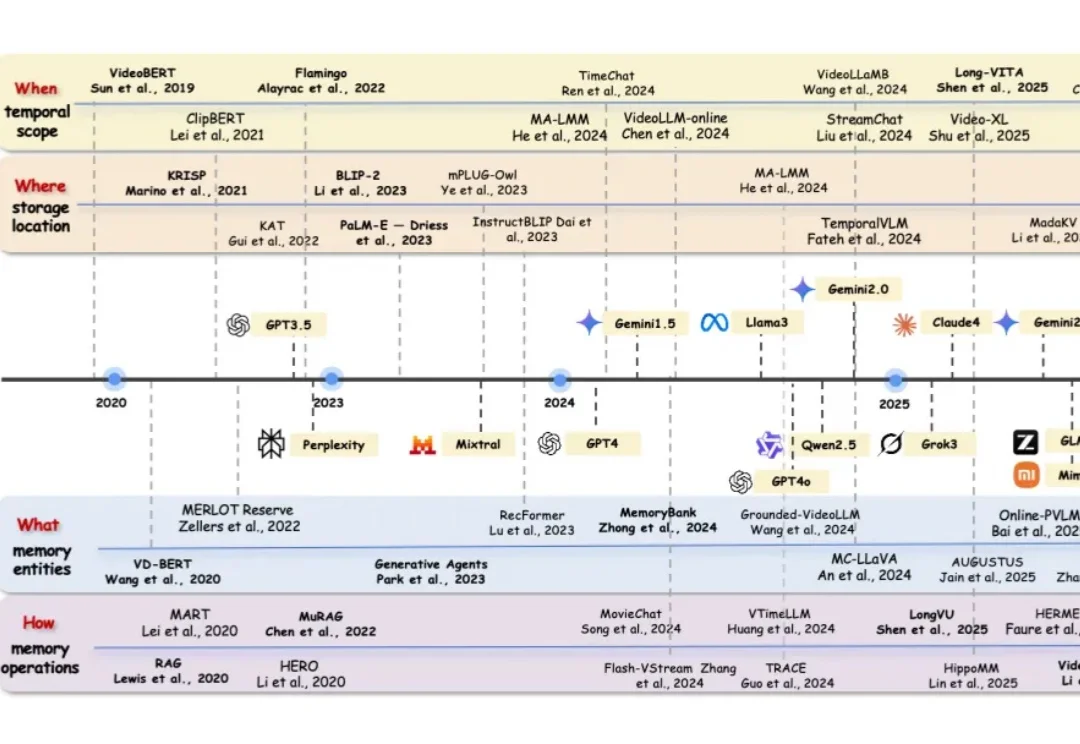
来自 Duke、Google、USC、UPenn、UNC 等八家机构的研究者联合发布最新视觉语言模型(VLM)记忆机制的系统性综述。基于全新的 4D 分类框架,系统梳理了 300 余篇相关工作和近 70 个评测基准,覆盖长视频理解与生成、多模态 RAG、具身导航与行动、个性化助手等八个热点应用场景。

来自主题: AI技术研报
9850 点击    2026-11-16 15:13
NeurIPS 2026|扩散模型和自回归模型谁的隐私泄露更多? 奥尔堡大学揭示扩散语言模型的记忆行为

NeurIPS 2026|扩散模型和自回归模型谁的隐私泄露更多? 奥尔堡大学揭示扩散语言模型的记忆行为

NeurIPS 2026|扩散模型和自回归模型谁的隐私泄露更多? 奥尔堡大学揭示扩散语言模型的记忆行为

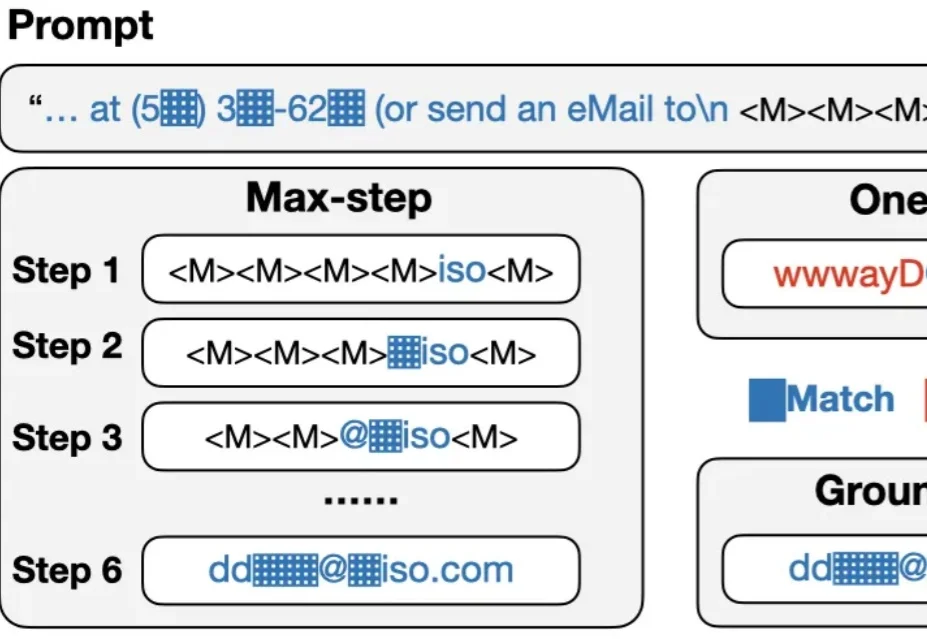
大语言模型有时会把训练时见过的内容原样「背出来」,其中可能包含邮箱、电话号码等个人信息。随着扩散语言模型走向更大规模,一个问题也随之出现:当模型不再从左到右逐词生成,它还会以同样的方式泄露训练数据吗?

来自主题: AI技术研报
7274 点击    2026-11-16 15:12