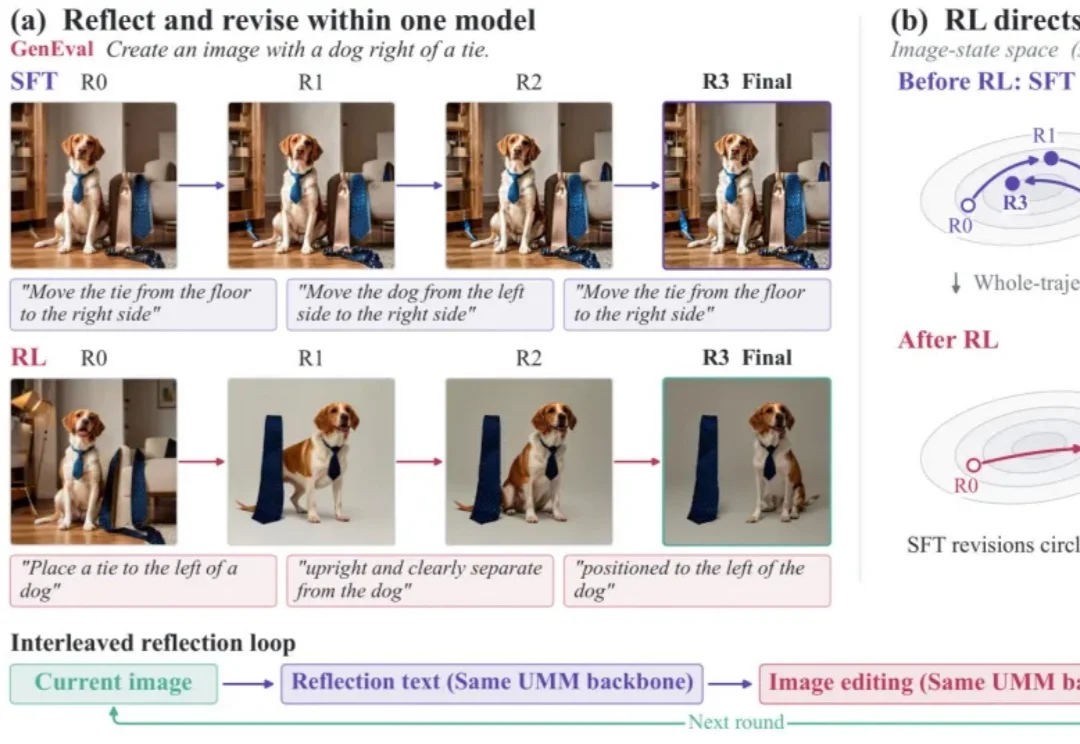
不靠外部裁判,统一多模态模型学会自己「看图改图」:修复成功率提升到3倍,GenEval 0.72→0.84
不靠外部裁判,统一多模态模型学会自己「看图改图」:修复成功率提升到3倍,GenEval 0.72→0.84统一多模态模型既能看图,也能画图,那么它能不能像人一样,画完之后自己检查、发现问题、再动手改?
来自主题: AI技术研报
6415 点击 2026-11-11 14:43

 搜索
统一多模态模型既能看图,也能画图,那么它能不能像人一样,画完之后自己检查、发现问题、再动手改?
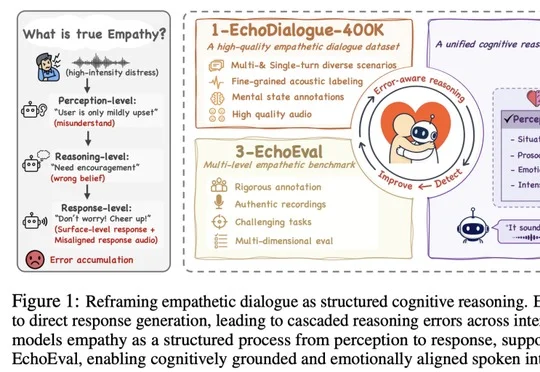
香港中文大学与微软团队提出EchoChat,将感知、心理状态推断与语音回复生成纳入统一优化框架,通过级联门控、SDCA步骤级信用分配和AAA声学注意力约束减少共情推理中的错误传播,相关成果发表于NeurIPS 2026,并发布EchoDialogue-400K数据集与EchoEval评测。
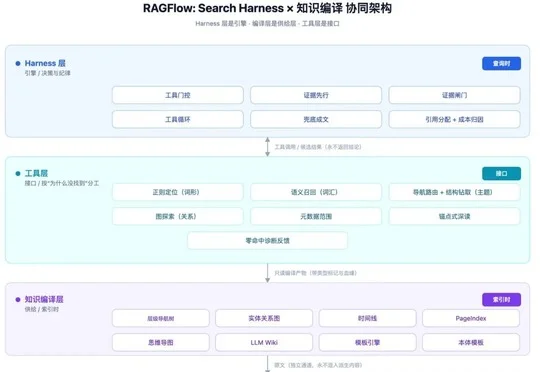
RAGFlow 1.0 以 Go 重写并公开知识编译层与 Retrieval Harness,将产品定位升级为 Agent Native 数据库,通过证据链等编译产物降低 Token 消耗并提升上下文可追溯性。
就在今天,OpenAI推出了AGI新标准。
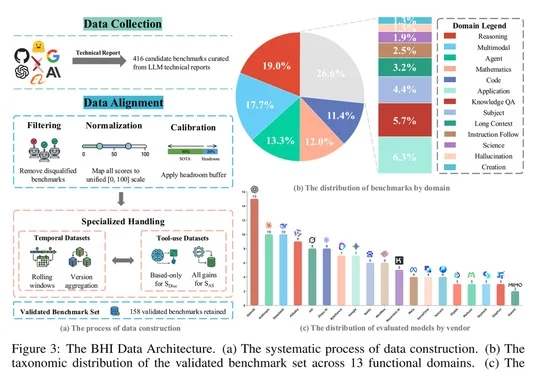
阿里数据团队基于117个模型技术报告筛选158个评测基准,提出基准健康指数(BHI),按能力区分度、抗饱和度和影响力诊断基准,论文获NeurIPS 2026 Evaluations and Datasets Track(Oral)录用,Humanity's Last Exam(HLE)综合第一。
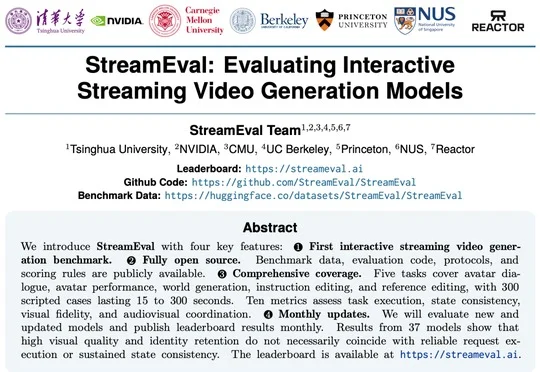
清华大学、英伟达等机构联合推出全球首个流式交互视频生成评测榜单StreamEval,以300个用例评测38个模型,揭示当前模型在连续指令执行和状态一致性方面仍存明显短板。
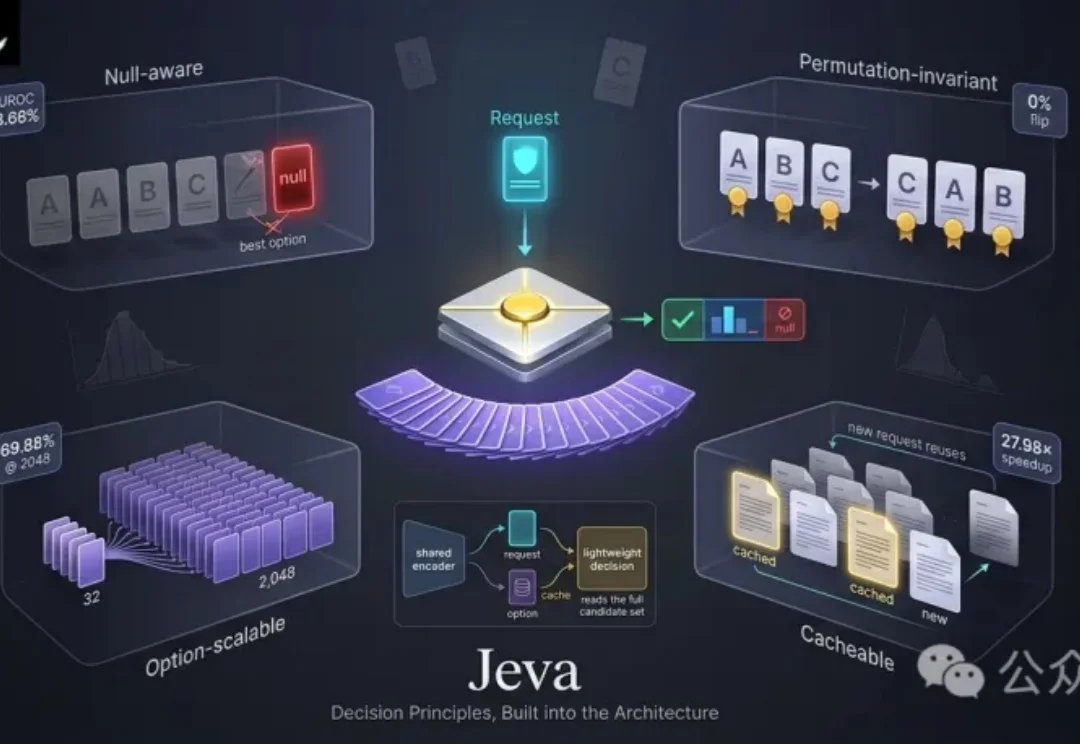
当任务的终点是决策,模型是否应该从决策本身出发?
家人们,上次我写摄像头体感交互应用,评论区有位家人问:“测试视频怎么是个男的?”
太震撼了。 就在刚刚,一项研究显示,GPT-6 Astra 已经解决了 98% 的全新理论物理难题!
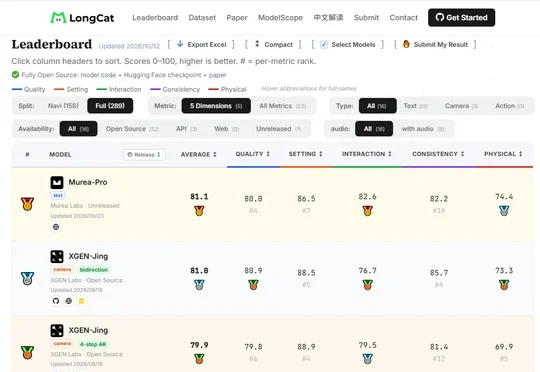
Murea Labs的Murea-InWorld通过Murea-Mind协同Murea-Pro和Murea-Fast生成实时互动音视频,Murea-Pro以81.13分位列WBench Full-289第一,Murea-Fast以64.98分居OpenS2V-Eval参评开源模型第一。