答对了却没看图?EASE给多模态RLVR装上「视线校正器」
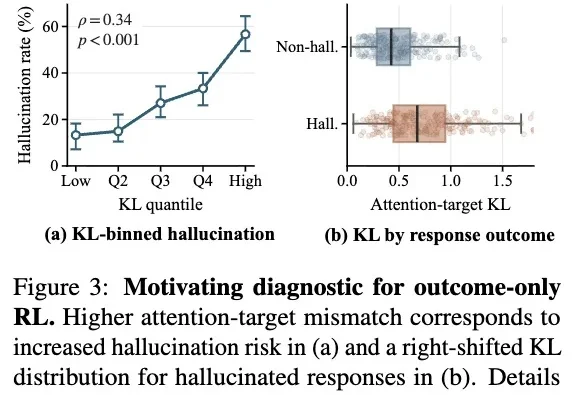
答对了却没看图?EASE给多模态RLVR装上「视线校正器」强化学习与可验证奖励(RLVR)已成为提升视觉语言模型(VLM)推理能力的标配手段。但一个隐蔽的问题始终存在:最终答案的奖励信号,只告诉模型「答对了没有」,却从不告诉它「答案应该从图像的哪个区域得出」。答对,可能是因为真的看懂了图,也可能只是语言先验的捷径、数据集的偏差,甚至是一次幸运的瞎猜。
搜索
强化学习与可验证奖励(RLVR)已成为提升视觉语言模型(VLM)推理能力的标配手段。但一个隐蔽的问题始终存在:最终答案的奖励信号,只告诉模型「答对了没有」,却从不告诉它「答案应该从图像的哪个区域得出」。答对,可能是因为真的看懂了图,也可能只是语言先验的捷径、数据集的偏差,甚至是一次幸运的瞎猜。
Agent 经常遇到这样一种幻觉:你给模型接入了终端,下发了一个复杂的 debug 任务,看着它顺藤摸瓜排查了几个小时,最终完美修复了依赖冲突,甚至连测试用例都帮你补齐了。
继 Anthropic 和 Google 接连更新模型之后,Meta 也加入了本周这场大模型密集发布潮。
就在最近,一台彻底断网的普通笔记本,靠着一个仅有4B参数的小模型,硬是干完了一件过去只有大模型才兜得住的活。
Astra还没发,外媒把OpenAI的王牌技术曝光了。
OpenAI 即将发布的模型 Astra,在内部评测中拿到了漏洞利用基准 ExploitBench 的满分,还顺手挖出了两个此前无人知晓的零日漏洞。
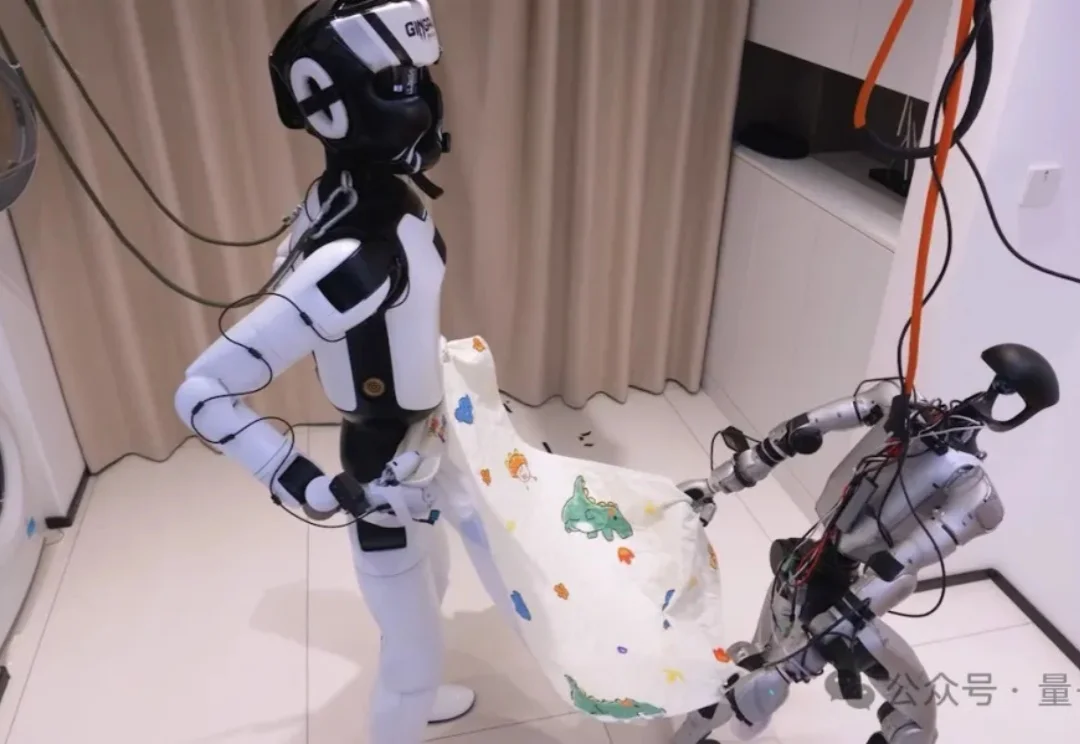
还记得上周具身圈流传的那个神秘10分钟一镜到底视频吗?
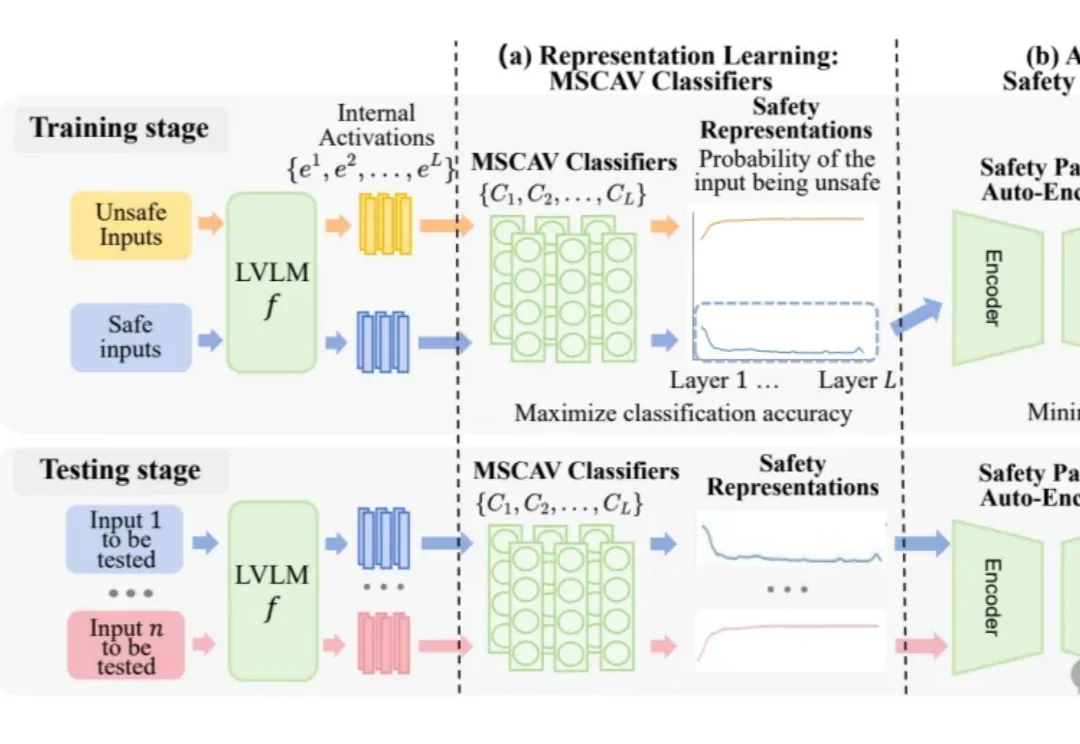
大视觉语言模型(LVLM)把语言理解扩展到了图像等多模态输入,同时,也带来了更隐蔽的攻击面。
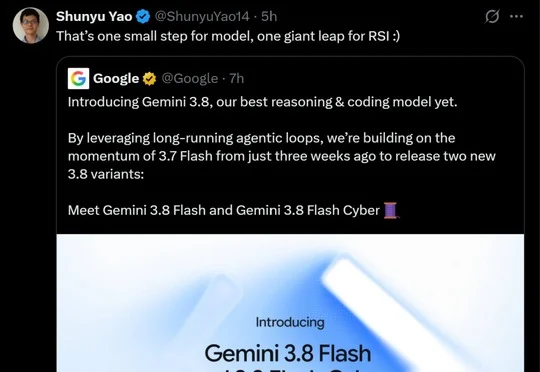
谷歌正式发布Gemini 3.8 Flash及网络安全专用版Gemini 3.8 Flash Cyber,前者以极低单任务成本在多项基准测试中逼近GPT-5.6 Sol、Grok 4.6等顶级模型,并在软件工程和速度上实现大幅跃升,后者则在漏洞发现基准CyberGym上以86.2%的成绩屠榜,谷歌DeepMind称这标志着RSI(递归自我进化)迈出了一大步。
由两名00后大学生创办的美国AI训练数据公司AfterQuery五个月内估值从3亿美元升至32亿美元,其数据已用于英伟达Nemotron 3 Ultra模型训练,并与Thinking Machines Lab、Legora及部分中国AI实验室合作。