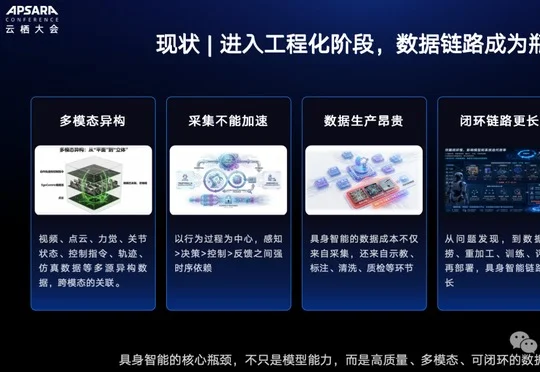
从真机到世界模型,具身智能正在补一条看不见的数据产线
从真机到世界模型,具身智能正在补一条看不见的数据产线在2026云栖大会具身智能论坛上,阿里云展示了覆盖采、存、洗、标、质检增广、训练评测到数据管理的全栈数据产线能力,通过Qwen标注、HappyHorse增广、PAI训练与平头哥真武芯片协同,将具身智能企业的反馈迭代周期从周级压缩至日级,穹彻智能、苏度科技、莫刻机器人等企业已率先跑通这条数据飞轮。
来自主题: AI资讯
8214 点击 2026-09-25 10:09

 搜索
在2026云栖大会具身智能论坛上,阿里云展示了覆盖采、存、洗、标、质检增广、训练评测到数据管理的全栈数据产线能力,通过Qwen标注、HappyHorse增广、PAI训练与平头哥真武芯片协同,将具身智能企业的反馈迭代周期从周级压缩至日级,穹彻智能、苏度科技、莫刻机器人等企业已率先跑通这条数据飞轮。
这个问题正随着推理模型和 RLVR 的发展变得更加重要。随着强化学习在大模型后训练中的作用不断增强,模型练什么、怎么练,也需要更仔细地安排。为了解决数据策略接入和效果比较中的麻烦问题,北大DCAI团队联合UCAS、上海算法创新研究院、中关村学院最新发布DataFlex-RL。
Z Potentials获悉,Physical AI公司息壤开物近日连续完成数亿元种子轮及天使轮融资,目前估值达5亿美元。本轮融资由敦鸿资产领投,华控基金、三花控股、银杏谷资本、泽然资本、本坚基金、天使基石、标朴投资等机构跟投。募集资金将主要用于原生物理AI模型的规模预训练、真实物理交互数据建设、核心研发人才引入及场景验证。
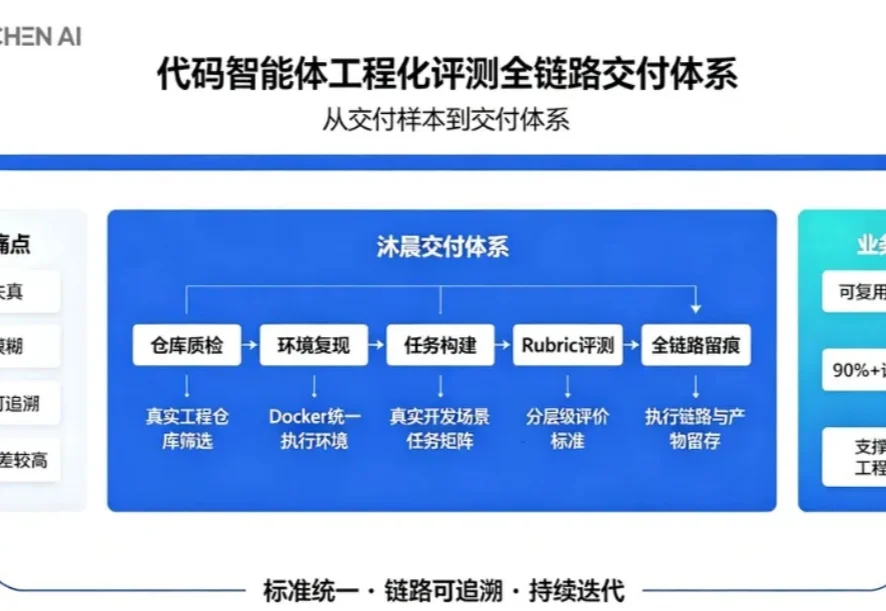
近期 2026 外滩大会上,北大助理教授杨灵关于「长程任务学习」的分享引发行业关注 —— 当 AI 从单次问答走向长周期复杂任务,模型如何从持续交互中积累进化。而在这份分享的合作研究标识中,Muchen AI 的名字赫然在列。
BAI资本成员企业Humanlaya(原壤智能)宣布完成由鼎晖香港基金领投的数亿元Pre-A轮融资,公司聚焦大模型后训练数据与评测,通过专家网络、高质量数据生产与Benchmark体系帮助模型提升在金融、法律、医疗等复杂专业任务中的能力。
过去评价一座数据中心,行业习惯看三个指标: 卡数、算力规模和PUE(电能利用效率)。
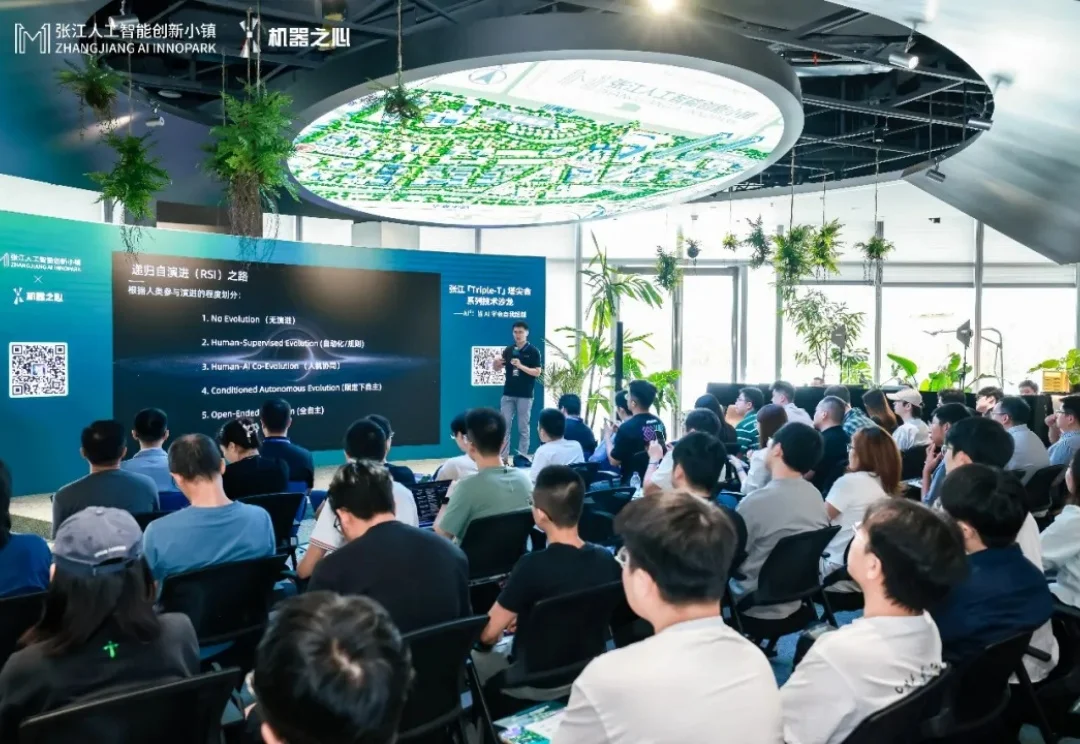
AI 距离真正的递归自我改进(RSI)还有多远?当前,AI 已开始参与数据生成、训练优化、工具迭代与结果验证,但参与研发,并不意味着已经具备持续改进自身的能力。它能够自主完成哪些环节,又如何将局部优化连接成持续、可靠的改进闭环?回答这些问题,需要回到具体的研究与实践,审视已有进展与尚待突破的瓶颈。
Anthropic宣布Claude在人类科学家仅提供高层次研究方向的情况下,自主搜索海量基因组数据库并发现了此前未被表征的酶系统ART(阵列关联逆转录酶),该系统具有类似CRISPR的重复DNA序列结构,可能成为新的基因编辑工具。
过去一年,AI数据市场经历了几轮剧烈的主题切换:从标准Coding到垂直行业,从合成蒸馏到真实场景,从任务够长就是好数据到什么任务值得解。需求每两个月刷新一次,供给侧的生存法则也在同步重写。在这个过程中,一些原本隐身于产业链深处的角色开始浮出水面——数商,就是其中之一。
AI数据创企Snorkel AI完成3.5亿美元E轮融资,估值达35亿美元,由Insight Partners和S32领投,其年化收入运行率已达3.75亿美元,较过去12个月增长18倍。