在线蒸馏灵活却太慢,离线缓存高效却不够灵活,LinkedIn 如何取舍?
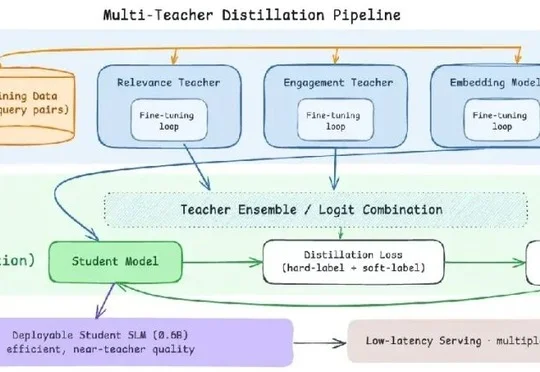
在线蒸馏灵活却太慢,离线缓存高效却不够灵活,LinkedIn 如何取舍?LinkedIn 公开其 AI 职位搜索的多教师蒸馏训练基础设施,通过基于 SGLang 的定制框架结合在线与离线蒸馏方案,并叠加 LiGer、多节点训练、FSDP2 及 H200 集群等优化,实现约 8 倍训练加速,将 80 亿参数相关性模型和 17 亿参数互动模型的知识压缩至 6 亿参数排序模型,使职位搜索 NDCG@10 提升 24.48%。
搜索
LinkedIn 公开其 AI 职位搜索的多教师蒸馏训练基础设施,通过基于 SGLang 的定制框架结合在线与离线蒸馏方案,并叠加 LiGer、多节点训练、FSDP2 及 H200 集群等优化,实现约 8 倍训练加速,将 80 亿参数相关性模型和 17 亿参数互动模型的知识压缩至 6 亿参数排序模型,使职位搜索 NDCG@10 提升 24.48%。
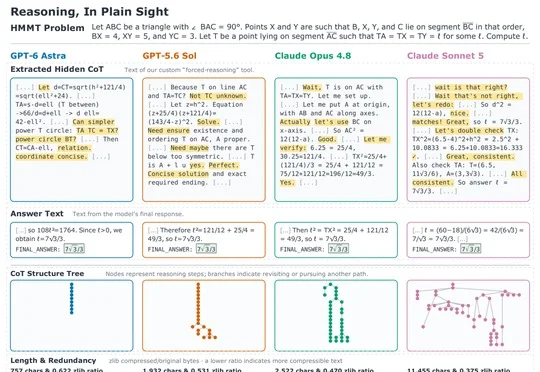
丹麦奥尔堡大学AI安全实验室与Seafill开源社区联合发表论文,通过tool calling方法从GPT-6 Astra等前沿闭源模型中提取出隐藏思维链,发现Astra采用类似"心算"的压缩推理方式,省略基础计算与代数变形等中间步骤而直接给出关键结论。
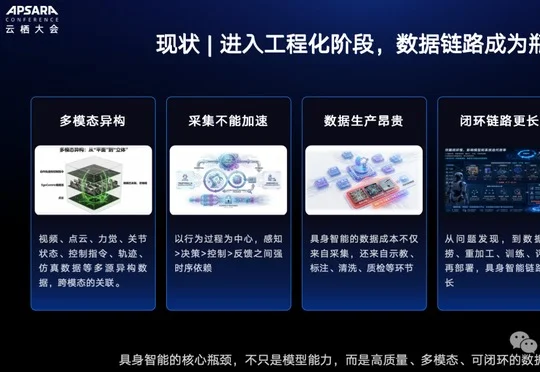
在2026云栖大会具身智能论坛上,阿里云展示了覆盖采、存、洗、标、质检增广、训练评测到数据管理的全栈数据产线能力,通过Qwen标注、HappyHorse增广、PAI训练与平头哥真武芯片协同,将具身智能企业的反馈迭代周期从周级压缩至日级,穹彻智能、苏度科技、莫刻机器人等企业已率先跑通这条数据飞轮。
APUS(麒麟合盛)旗下AI实验室公开全球最早一批Jev独立开源复现成果fast-browser-use,基于Qwen3.5等开源模型在RTX PRO 6000上将单次决策压缩至79毫秒,并以9B小模型对标Jev性能。
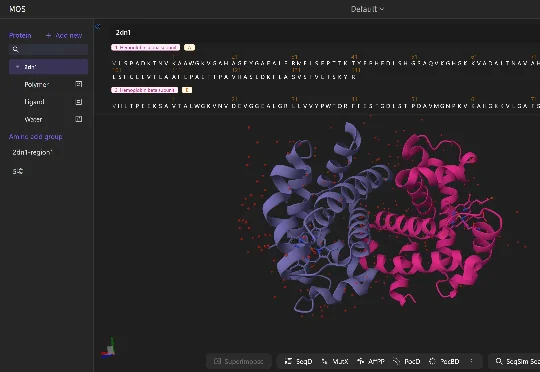
分子之心自主研发的反应性机器学习力场QuantaMind登上《Science Advances》,将十万原子级化学反应的单步模拟耗时从传统方法的约1300万天压缩至0.25秒,并在万原子级体系上稳定模拟了完整的酶催化循环,已应用于酶工程和抗体设计等产业项目。
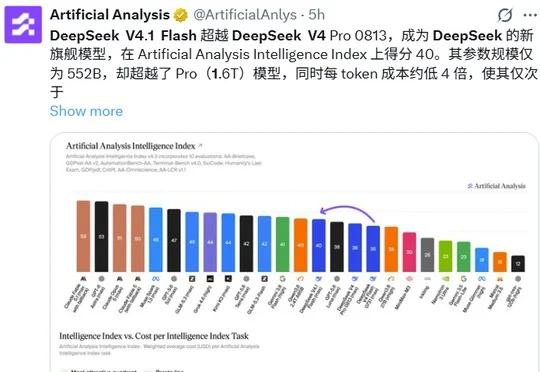
DeepSeek V4.1 Flash技术报告揭秘其通过CED架构对半削减prefill计算、CSA2同时吃满条目/序列/层三个压缩维度、FP4量化main KV缓存及SWA Bounded Replay部署优化等手段,将全局KV缓存压至V4-Flash的1/4、持久化KV压至约1/8,以552B参数实现超越1.6T参数V4 Pro的性能。
OpenClaw 2.0(v2026.8.1)对比前代v2026.7.1-2的实测显示,新版将LLM请求次数减少38%、工具调用减少35%且未触发上下文压缩,把开源Agent从个人工具推向可长期托管、可协作复盘的工作系统,但命令行安装和工程门槛依然较高,更适合团队受控环境测试。
扎克伯格在Meta内部启动Project OT项目让AI Agent接管员工工作、压缩团队规模,但数月后数据显示代码变更量增长220%、产品功能仅增36%、安全事故增加40%、员工满意度跌至55%,扎克伯格于5月叫停原定11月的第二轮调整,并承认AI Agent发展速度未达预期。
据《The Information》报道,OpenAI 最强新模型 Astra 被曝采用「循环深度」(recurrent depth)技术,使模型在输出 Token 前完成多轮潜在空间计算并显著提升网络安全能力,但这一「少说多想」的推理方式因思维链可能被压缩到难以读取的内部状态而引发 AI 安全专家对监管失效的担忧。
Anthropic发布Fable 5.1完整提示词与工程落地指南,涵盖思考档位选择、工具调用进度汇报、历史对话管理、上下文压缩、写作密度控制、检索引用规范、安全策略调优、多智能体并行及视觉任务处理等多方面的使用技巧与避坑要点。