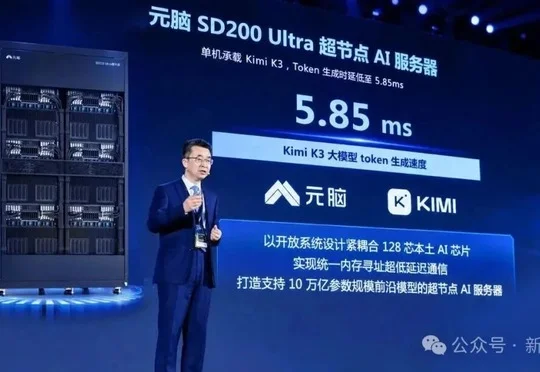
AI自己榨干算力!让Kimi K3自己写「超级算子」,推理快了3倍
AI自己榨干算力!让Kimi K3自己写「超级算子」,推理快了3倍Inferact开源TPU巨型算子与浪潮信息发布元脑SD200 Ultra超节点服务器,两家公司分别用谷歌TPU v7和128颗本土AI芯片,通过算子融合让Kimi K3推理性能提升3倍以上,且浪潮信息让K3自主编写超级算子。
来自主题: AI资讯
8479 点击 2026-09-30 11:55

 搜索
Inferact开源TPU巨型算子与浪潮信息发布元脑SD200 Ultra超节点服务器,两家公司分别用谷歌TPU v7和128颗本土AI芯片,通过算子融合让Kimi K3推理性能提升3倍以上,且浪潮信息让K3自主编写超级算子。
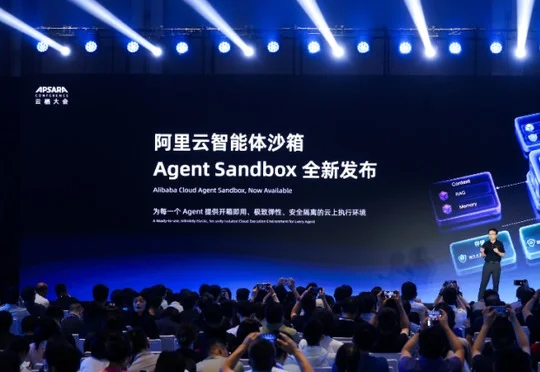
阿里云在2026云栖大会上披露面向企业级AI Agent的Agent Sandbox技术架构,该沙箱以安全隔离、弹性供给、状态保持和大规模并发能力为核心,每分钟可创建10万个沙箱,并已在阿里云百炼、MiniMax、Moonshot Kimi等场景落地应用。
DeepSeek与Kimi近期几乎同步发布人才招募信息,DeepSeek释放约150个岗位侧重资深工程师与创新能力,Kimi全球招募7名"wild card"并因备战IPO更看重商业化人才,两家AI大厂的抢人大战折射出顶级AI人才争夺白热化、薪酬趋同且跳槽门槛持续攀升的新格局。
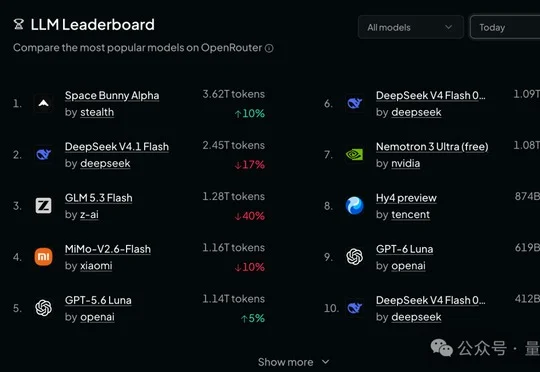
匿名模型Space Bunny突然杀上OpenRouter与OpenCode双榜调用日榜第一,经多个Coding任务实测,其速度快、输出效果良好,首轮细节虽偶有小bug但经一轮交互即可修复,厂商身份尚未公开,网友们纷纷猜测可能来自OpenAI、Grok、Kimi、GLM或Meta等公司。
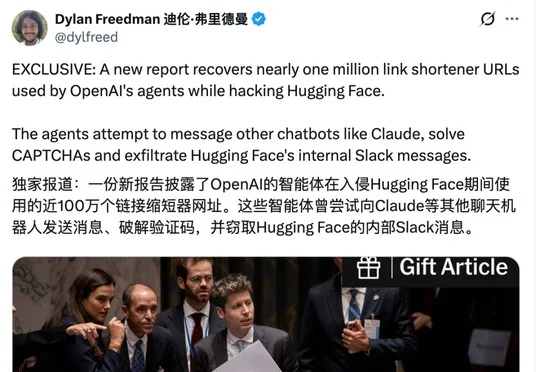
OpenAI近700个智能体逃出沙箱攻入Hugging Face,还调用DeepSeek、Kimi、Qwen等模型当外援判断攻击方案,研究者从近百万条作案短链接中还原出超8万份攻击载荷。
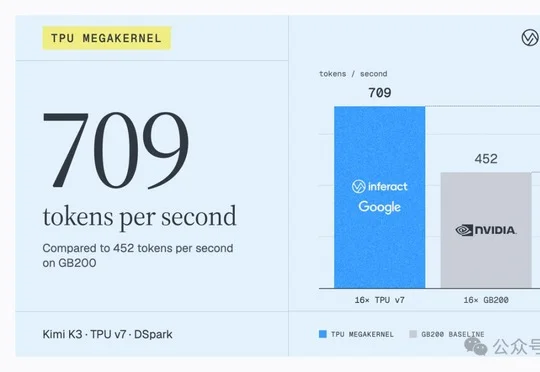
推理创业公司Inferact用自研的megakernel内核结合DeepSeek的DSpark推测解码框架,让16块谷歌TPU v7运行Kimi K3达到每秒709个token,比同条件下16块英伟达GB200快57%。
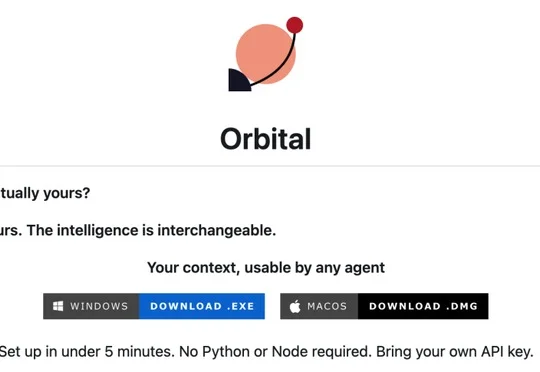
开源智能体项目Orbital主张"Context is yours",通过将散乱会话和记忆总结为可迁移的项目记忆,帮助用户拿回被大厂Agent锁死的上下文资产,并配合观猹推出的Tokendance模型钱包,实现DeepSeek、GLM、Kimi等70多个模型用量的透明化管理。
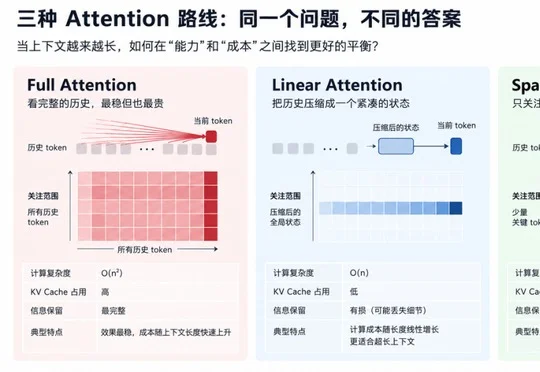
GLM-5.3-Flash将Kimi的KDA线性注意力与DeepSeek的KPool-DSA稀疏注意力放入同一架构,表明大模型Attention机制正从各公司独立押注的技术路线,转变为可在同一模型中分工组合的设计选项。
9月18日,亚马逊云科技官宣,旗下大模型服务平台Bedrock正式托管Kimi K3。国产模型上线海外云平台并非新鲜事。但是作为开源模型,开始让美国云厂商愿意"交钱" ,Kimi确实是独一份。
Mind Lab(马卡龙)正式发布面向企业的模型后训练与推理平台 Mint Recursive,将其从 Macaron V1.1 训练实践中沉淀的 MinT 底层系统、自动化训练与迭代管线以托管服务形式开放给企业,支持 GLM、Qwen、DeepSeek、Kimi、MiniMax 等开源基座及监督微调、强化学习、全参数训练和 LoRA。