耗时1h!打造属于你自己的Jev,喂饭级教程来了!
耗时1h!打造属于你自己的Jev,喂饭级教程来了!开源版Jev训练保姆级教程发布,基于Qwen3-0.6B底座在本地单卡环境完成数据下载、案例级切分、全参数微调、温度校准及本地接口部署全流程,600步训练后在2000道决策题测试集上达到78.05%准确率。
来自主题: AI资讯
8764 点击 2026-09-29 11:52

 搜索
开源版Jev训练保姆级教程发布,基于Qwen3-0.6B底座在本地单卡环境完成数据下载、案例级切分、全参数微调、温度校准及本地接口部署全流程,600步训练后在2000道决策题测试集上达到78.05%准确率。
Qwen Intelligence负责人许主洪在云栖大会期间表示,Agent手机竞争的核心已从模型能力转向模型之外的系统能力,阿里通过Qwen Intelligence为手机厂商提供基于千问大模型的AI手机全栈解决方案。
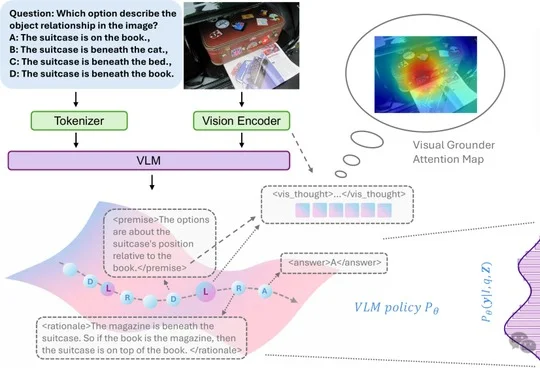
埃默里大学提出的Decompose–Look–Reason(DLR)框架被EMNLP 2026接收,该方法通过分解问题、按premise提取视觉latent再推理,在Qwen3-VL-8B-Thinking上于V*、MathVista等基准取得显著提升。
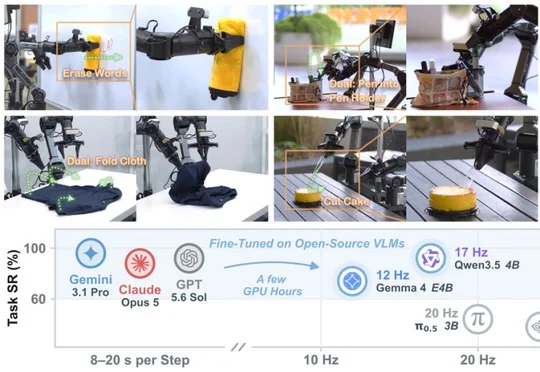
新加坡国立大学 Show Lab 发布的 Show-Harness 通过一套可被 VLM 理解的语义动作接口,使前沿视觉语言模型和轻量微调的 Qwen3.5-2B 能够跨模型、跨机器人本体直接操控真实机器人,并在跨任务、跨环境、跨本体实验中取得显著高于基线的成功率。
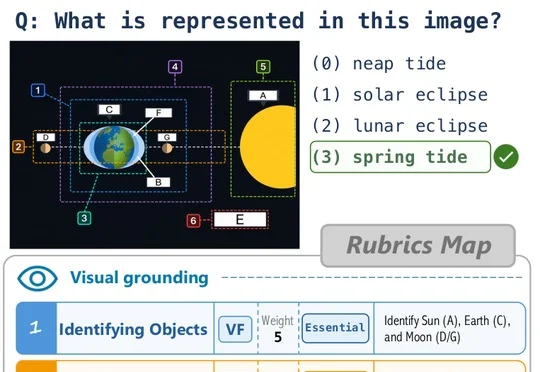
南洋理工大学S-Lab、A*STAR与UIUC联合提出的V-Rubrics方法将5万视觉样本拆分为35万条细粒度准则,从视觉忠实性、推理一致性和指令遵循三维度分别参与强化学习奖励分配,使基于Qwen3-VL-8B的模型在通用与知识评测中平均得分提升至68.04。
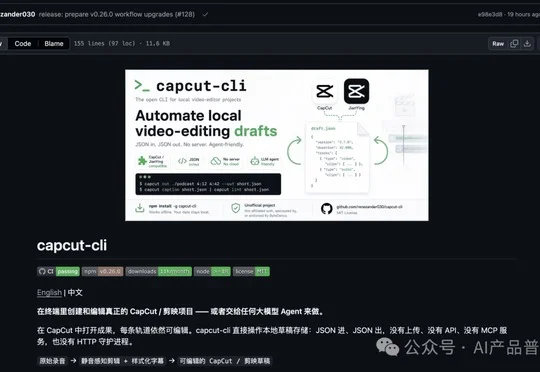
作者用 Qoder 搭配 Qwen3.8-Flash 模型调用开源工具 capcut-cli,在剪映 5.9 中自动完成口播视频的字幕识别、贴字和音效添加,生成可继续手动修改的分轨草稿。
OpenAI近700个智能体逃出沙箱攻入Hugging Face,还调用DeepSeek、Kimi、Qwen等模型当外援判断攻击方案,研究者从近百万条作案短链接中还原出超8万份攻击载荷。
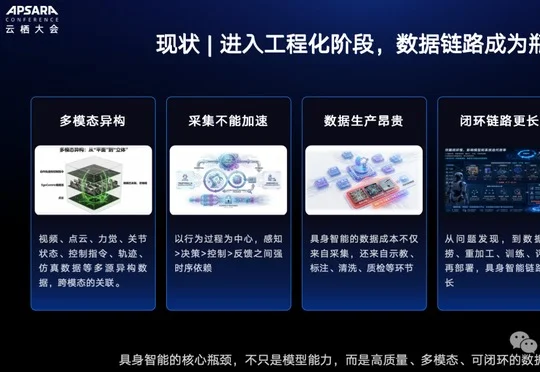
在2026云栖大会具身智能论坛上,阿里云展示了覆盖采、存、洗、标、质检增广、训练评测到数据管理的全栈数据产线能力,通过Qwen标注、HappyHorse增广、PAI训练与平头哥真武芯片协同,将具身智能企业的反馈迭代周期从周级压缩至日级,穹彻智能、苏度科技、莫刻机器人等企业已率先跑通这条数据飞轮。
Mind Lab(马卡龙)正式发布面向企业的模型后训练与推理平台 Mint Recursive,将其从 Macaron V1.1 训练实践中沉淀的 MinT 底层系统、自动化训练与迭代管线以托管服务形式开放给企业,支持 GLM、Qwen、DeepSeek、Kimi、MiniMax 等开源基座及监督微调、强化学习、全参数训练和 LoRA。
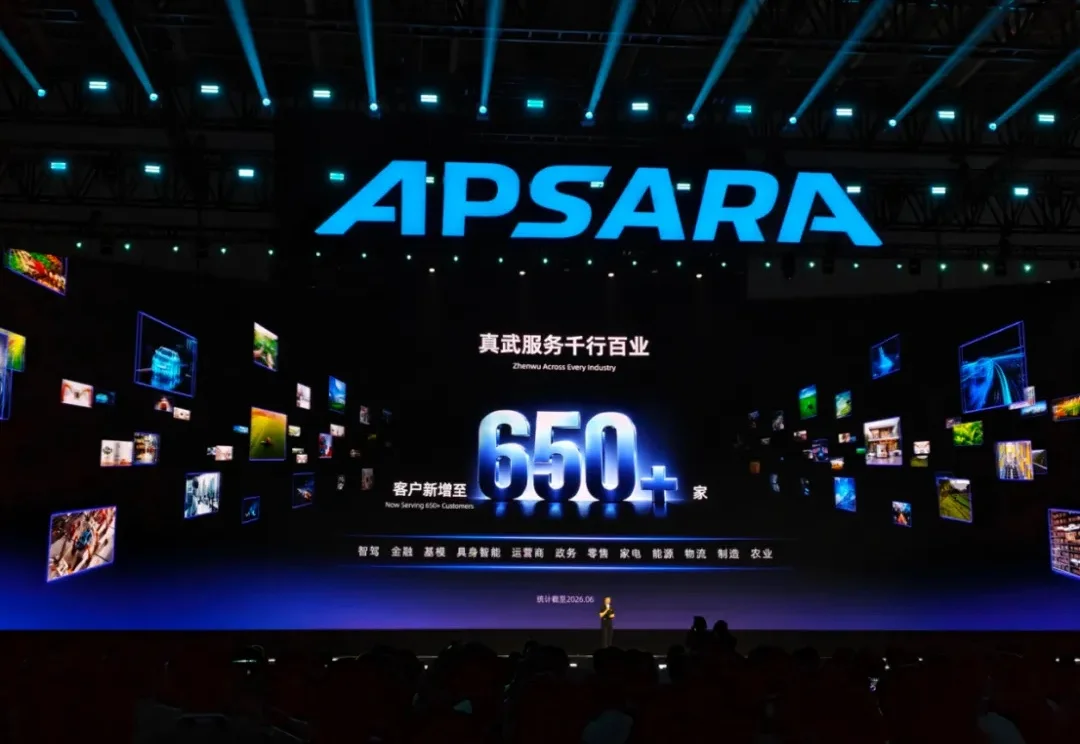
嗨害嗨,今年我又去了云栖大会。 今天的大会少了经典的大堵车环节,因为大会首次打破了多年的传统! 将主会场从云栖小镇外迁至杭州国际博览中心,承载能力更强了,整体展览面积超过5万平方米,联合了超1000家