当Coding Agent开始动态并行,软件开发变得更好了吗?
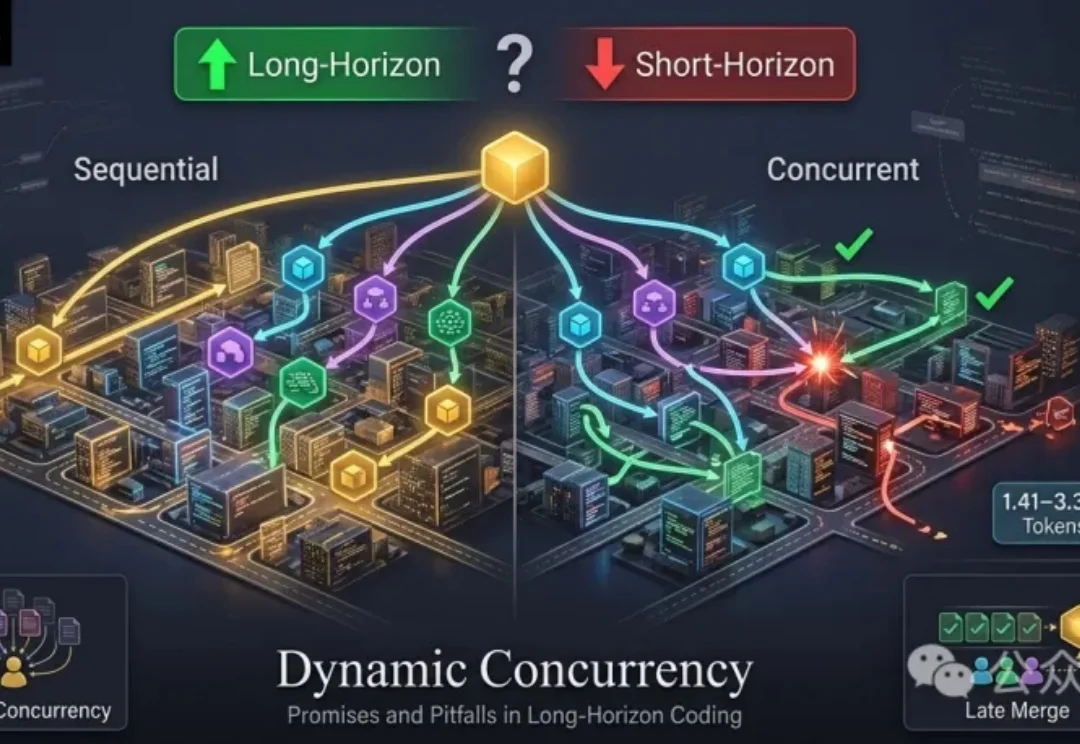
当Coding Agent开始动态并行,软件开发变得更好了吗?Coding Agent正在进入新的发展阶段。过去,它们主要修复Bug、解决GitHub Issue或实现相对独立的功能,SWE-bench等Benchmark已为此建立了成熟评测范式;如今它们开始承担从完整代码仓库生成、跨语言迁移,到需要持续探索与验证的长周期软件工程项目,任务规模和执行时间不断增长,单个Agent的上下文容量、推理能力和执行效率逐渐成为限制。
搜索
Coding Agent正在进入新的发展阶段。过去,它们主要修复Bug、解决GitHub Issue或实现相对独立的功能,SWE-bench等Benchmark已为此建立了成熟评测范式;如今它们开始承担从完整代码仓库生成、跨语言迁移,到需要持续探索与验证的长周期软件工程项目,任务规模和执行时间不断增长,单个Agent的上下文容量、推理能力和执行效率逐渐成为限制。
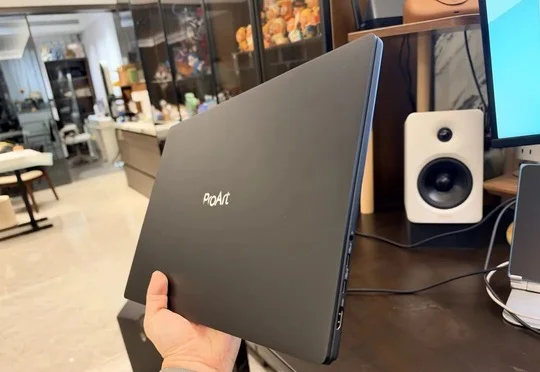
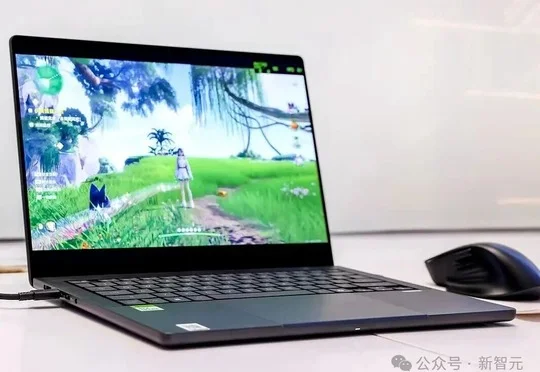
英伟达RTX Spark全球开售,128GB版本开售数分钟即售罄;作者使用售价37999元的华硕ProArt创16本地运行Qwen3.8-27B等模型,实现免API费用的多种AI任务并获得“Token自由”体验。
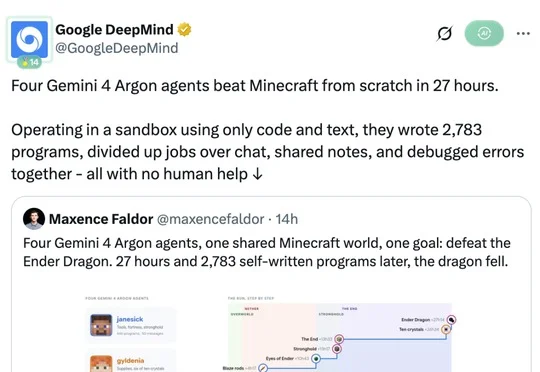
Google DeepMind的4个Gemini 4 Argon智能体在无人预先分工和干预的情况下自主协作,通过编写2783个程序在《我的世界》中经历605次死亡后,于27小时14分钟内击败末影龙。
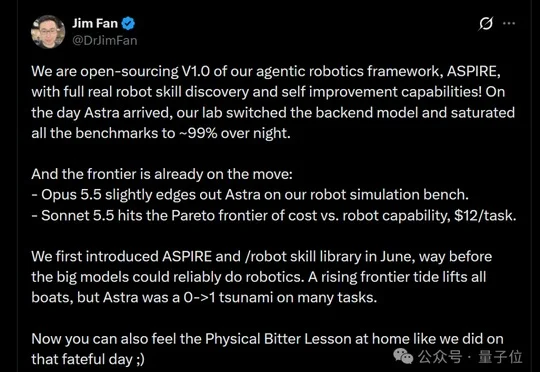
英伟达正式开源机器人智能体框架ASPIRE V1.0,使机器人可自主编程、调试、复盘并沉淀可复用Skill,换用GPT-6 Astra后,一夜将LIBERO-Pro任务成功率推至99%,Robosuite和BEHAVIOR-1K代表性任务均达100%。
智谱推出法律专用开源模型GLM-Legal,可处理合同审查、证据分析和跨境合规,并在Vals AI法律测评中以19.2%的任务全通过率和86.23%的准确率位居Harvey LAB与LegalBench双榜开放权重模型榜首。
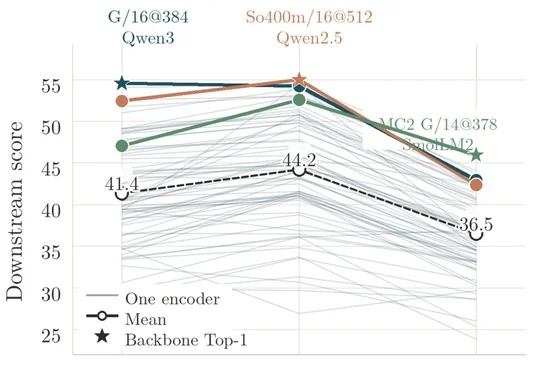
团队提出免训练评测方法RAVEL,通过带稳定项的PCA白化和局部图像块匹配提升视觉编码器评测准确性,在三个LLM上的平均Spearman相关系数达0.85,并开源210个MLLM权重。
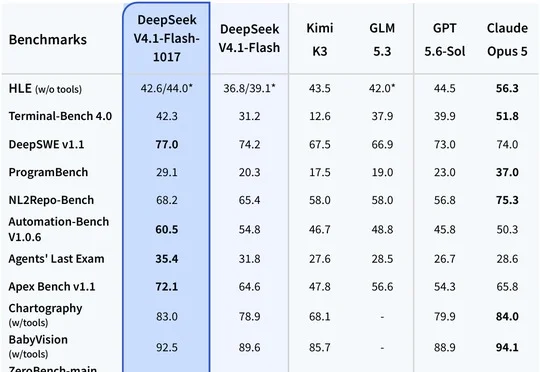
DeepSeek官宣DeepSeek-V4.1-Flash-1017全面上线,网页、App和API同步更新且价格不变,在DeepSWE v1.1取得77%最高分,并开放MIT许可证权重及Search/Fetch搜索API。
StartLux发布StartLux-Decision新版本,推出Instant与AutoThink双模型矩阵及原创RLCD²,在Decision Index 0.3和DecisionPivot评测中领先多款模型,并公开模型权重与推理代码。
英伟达开放Nemotron 3.5 Bolt模型权重,将740亿参数版本从约148GB压缩至22.1GB以支持笔记本本地Agent任务,搭载RTX Spark的联想、微软等笔记本也于10月16日全球发售。
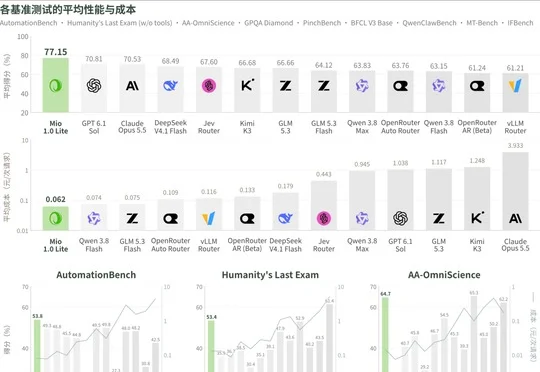
南芥智能发布模型群体智能技术报告,披露Mio 1.0 Lite在9个公开benchmark中平均得分77.15/100居首、平均每请求成本0.06元最低,其SinapisAI平台已公测并收录484个模型。