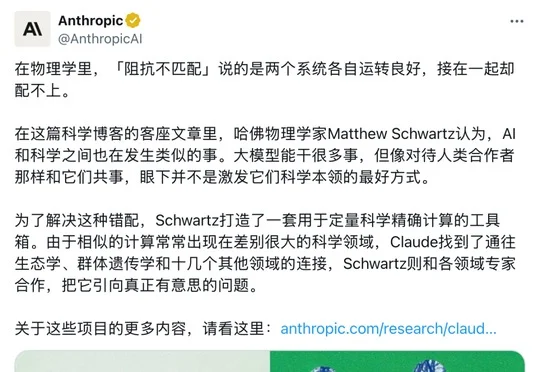
哈佛教授90天横扫18个学科,Claude神助攻!连开36篇论文
哈佛教授90天横扫18个学科,Claude神助攻!连开36篇论文哈佛物理学家Matthew Schwartz用Claude和开源工具BootLoops处理可验证的科研任务,90天产出横跨18个学科的36篇论文初稿,并主张由人挑题、追问和验收,让AI发挥辅助而非替代科学家的作用。
来自主题: AI资讯
10825 点击 2026-10-05 23:31

 搜索
哈佛物理学家Matthew Schwartz用Claude和开源工具BootLoops处理可验证的科研任务,90天产出横跨18个学科的36篇论文初稿,并主张由人挑题、追问和验收,让AI发挥辅助而非替代科学家的作用。
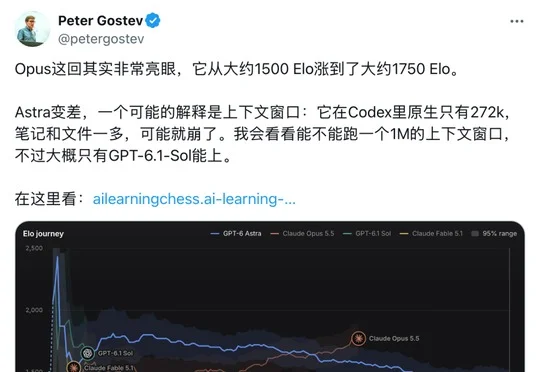
大模型竞技场Arena让Claude Opus 5.5与GPT-6 Astra各自练棋200局,前者估算评分从约1500升至1760,后者从第29盘的1810降至1400,显示AI仅靠记录与复盘提升能力的表现并不一致。
Harvey联合创始人Gabe Pereyra表示,AI应用公司不必与大模型公司比拼资金和算力,可借助真实任务评测、领域专家、开源模型和外部研究团队建立持续学习能力。
Geoffrey Hinton联合Yoshua Bengio、OpenAI首席科学家Jakub Pachocki、Anthropic联合创始人Jack Clark等20多位AI研究者发布剑桥CASP报告,指出AI已深度参与自身研发,Anthropic内部AI生成代码占比已超80%,警告递归自我改进可能引发技术进步突然加速的「智能爆炸」。
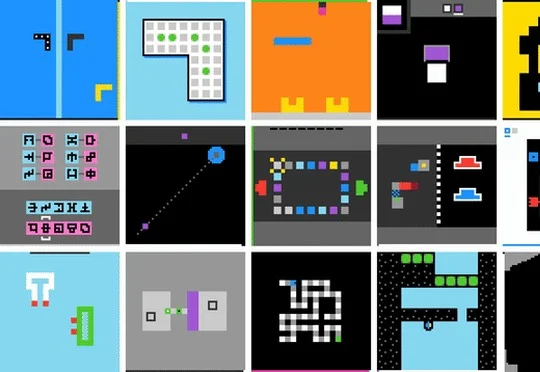
何恺明团队提出VISTA方法,将ARC-AGI-3的数字表换回图像并配备可随时翻看的视觉记忆相册,使Claude Opus 5拿下满分100分、GPT-5.6 Sol获得99分,证明卡住大模型的是眼睛和记性而非模型能力本身。
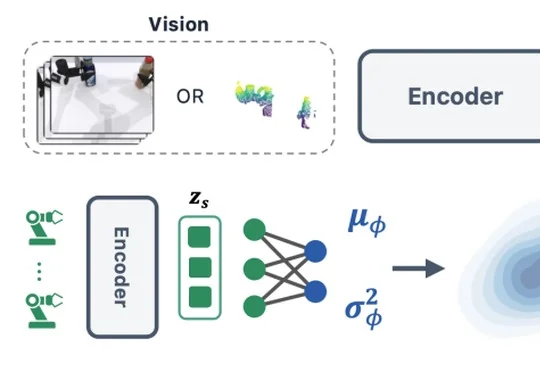
东南大学魏秀参团队提出LeaP(Learnable source Prior)方法,由本体感知信息驱动并联合预测动作生成起点的均值与方差,在RoboTwin仿真15项任务上平均成功率81.6%、较标准高斯基线提升25.5个百分点,相关论文已被CoRL 2026接收。
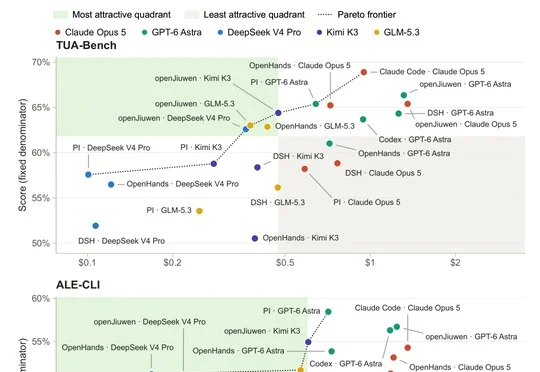
南洋理工大学安波团队最新研究指出,Agent Harness的选型应将模型、Harness与任务作为完整配置联合评估,不同任务下最佳组合会变化,原生搭配也未必优于其他可配置Harness。
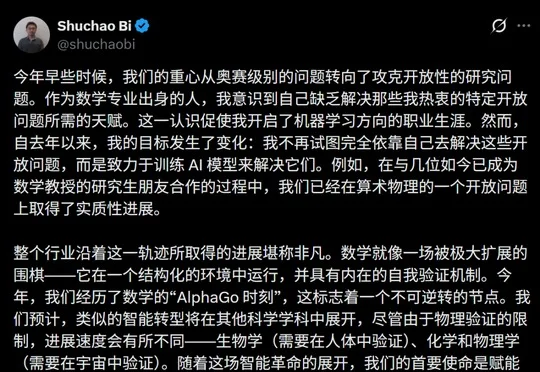
毕树超领衔的Meta超级智能实验室官宣,其Muse Spark模型在6个月内协助数学家连破概率论、微分方程、群论、优化理论、算术物理学及非结合代数六大领域的开放性难题,其中5篇论文直接给出前沿问题答案并推翻了既有群论规则,被毕树超称为数学界的"AlphaGo时刻"。
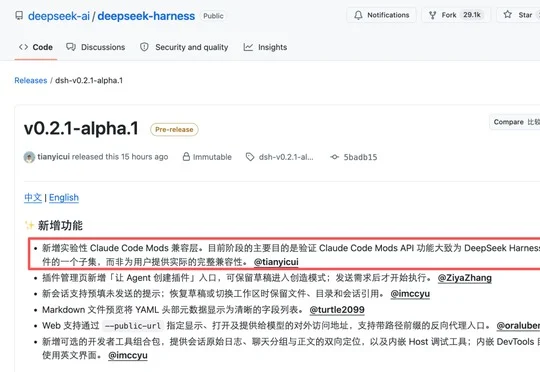
谁说 DeepSeek 假期不加班?就在昨天,DeepSeek Harness 又更新了。 这次发布的 v0.2.1-alpha.1,新增了一项很惹眼的功能:实验性 Claude Code Mods 兼容层。更有意思的是官方对它的解释:这次首先想验证,Claude Code Mods API 的能力,大致属于 DeepSeek Harness 插件能力的一个子集。
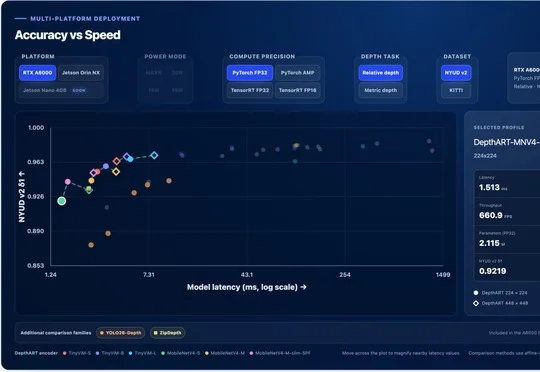
论文DepthART提出抗偏置数据采样与相机条件化微调方法,将基础单目深度估计模型压缩至约6M参数,在保留跨场景泛化能力的前提下实现Jetson等端侧设备的高帧率部署。