破局硅谷头号难题!中国AI「魂穿」老电影,神器全民开放
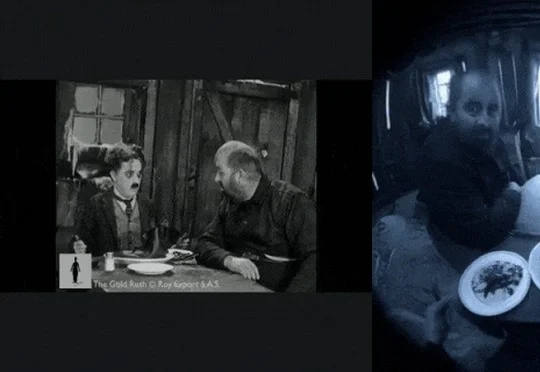
破局硅谷头号难题!中国AI「魂穿」老电影,神器全民开放中国具身智能公司维他动力(Vbot)发布跨视角生成模型Exo2EgoPolicy,并推出全面开放的Vbot Echo与Echo App,将第三人称视频转换为第一人称、手部骨骼及机器人训练数据。
来自主题: AI资讯
9605 点击 2026-11-14 12:47

 搜索
中国具身智能公司维他动力(Vbot)发布跨视角生成模型Exo2EgoPolicy,并推出全面开放的Vbot Echo与Echo App,将第三人称视频转换为第一人称、手部骨骼及机器人训练数据。
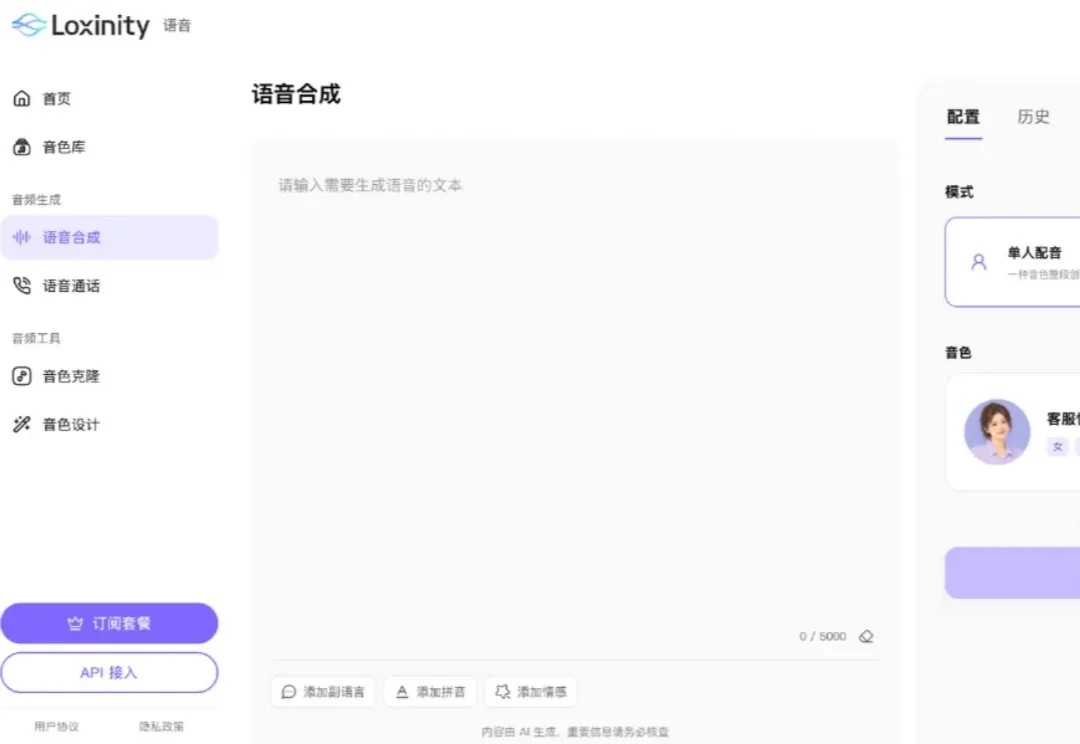
《读佳》独家获知,Soul将推出专为交互场景打造、超具活人感的语音合成产品“Loxinity(洛希无限)”,和市面上面向配音、短视频的TTS不同,这套模型从底层瞄准实时交互场景,主打强活人感。它支持单人配音、多人对话两种模式,配套音色克隆、音色设计等工具,还开放API接入。Loxinity下辖语音合成模型Loxi Speech和视频生成模型Loxi Avatar。
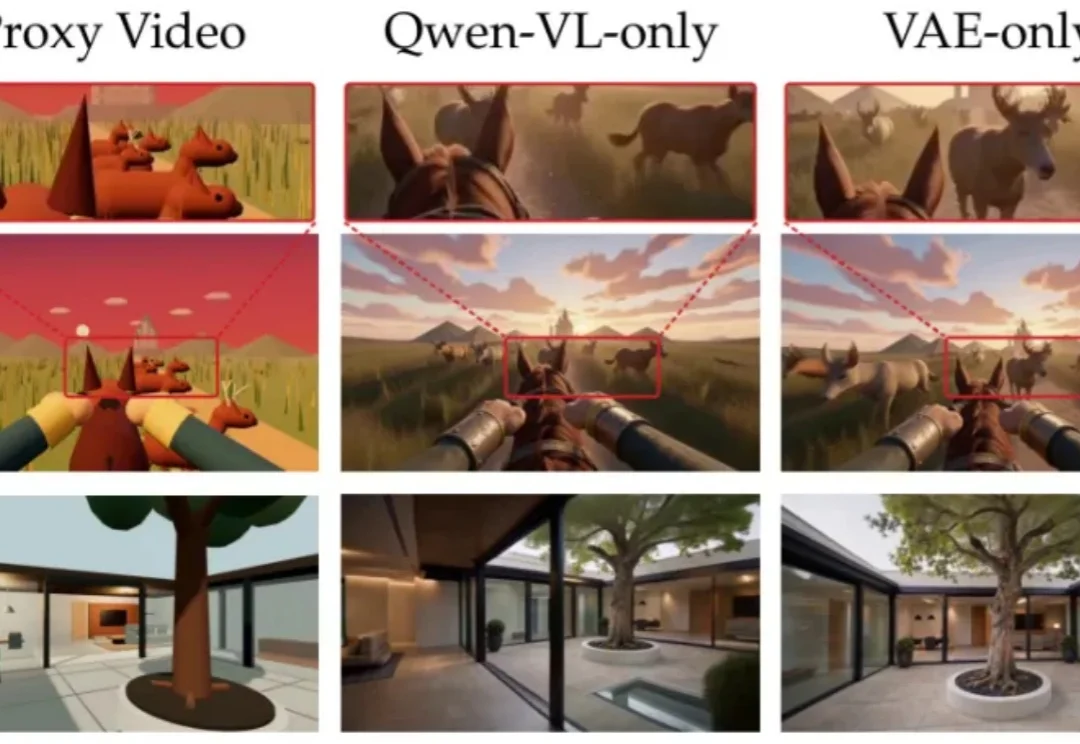
视频生成模型的视觉质量不断提升,但当前主流视频扩散模型仍面临两项根本局限。第一是物理规律约束不足:模型从像素中学习世界的视觉表象,却缺少物理方程的显式约束,画面看似合理,实际却不符合物理规律。
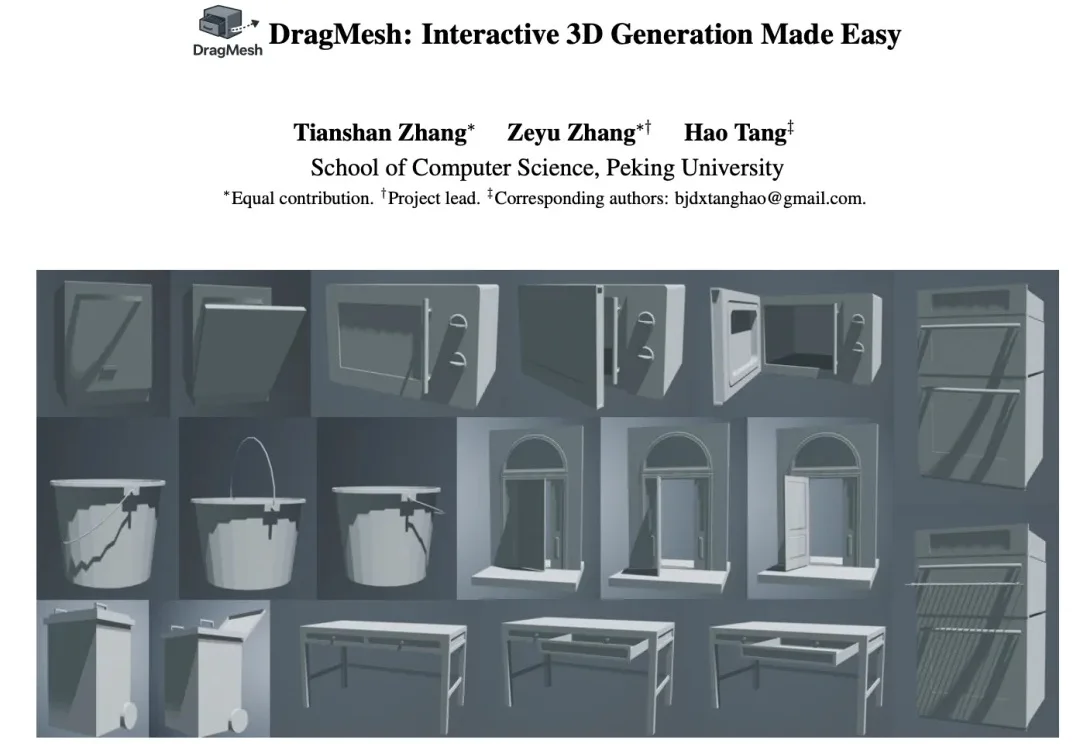
近年来,3D 生成模型在几何质量和渲染效果上进步很快。从 Mesh 到 NeRF、3D Gaussian Splatting,生成一个外观完整的三维物体已经不再困难。现有不少 articulated 3D generation 工作,更多关注的是从输入中生成一整套可动 3D 资产,包括物体几何、部件划分以及关节结构。
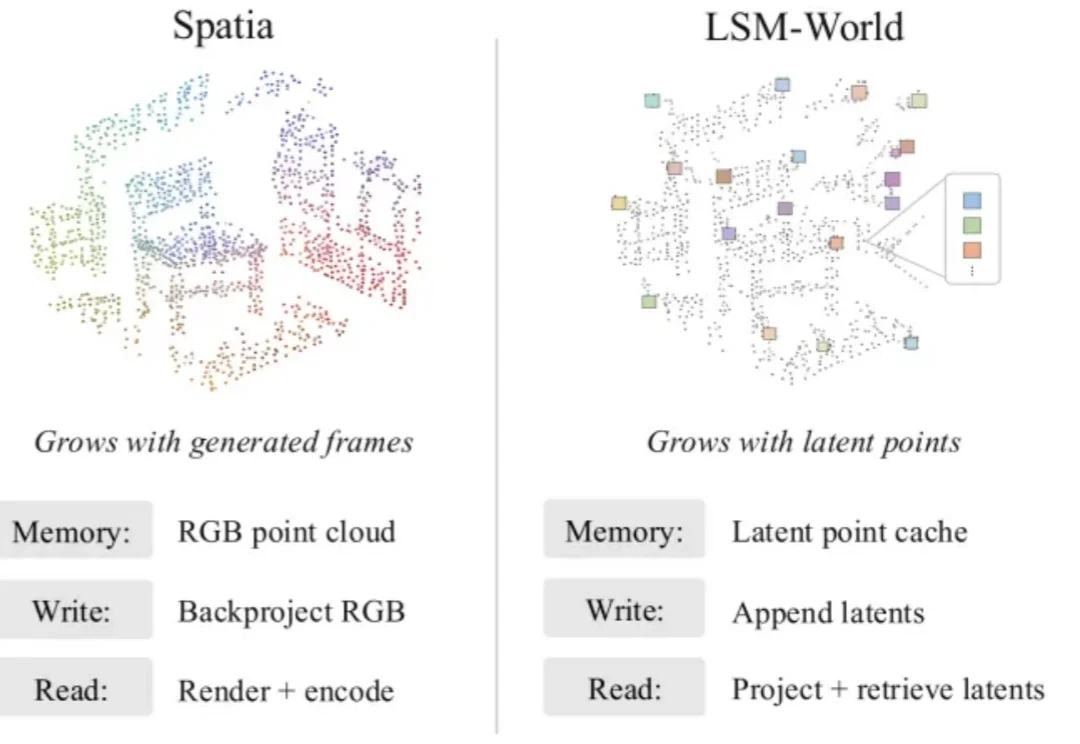
让视频生成模型沿着相机轨迹不断探索一个场景,并不算最难。真正困难的是:当镜头绕了一圈再次回到原点,房间的布局、家具的位置和墙面的纹理,是否还与最初一样?
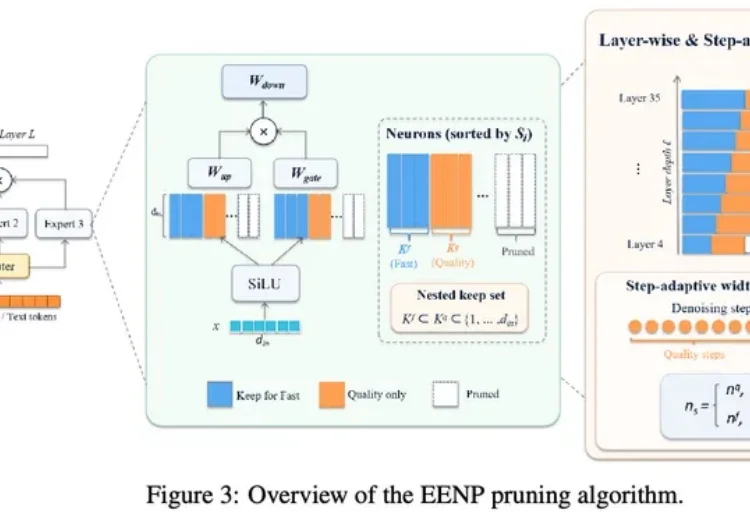
AI 视频越来越逼真,生成它的算力却并不便宜。复杂的动作、连贯的镜头和细腻的画面,背后都需要大量计算。一旦进入批量制作,反复生成、修改和重试的开销便会累积,成为创作者与视频平台必须考虑的成本。
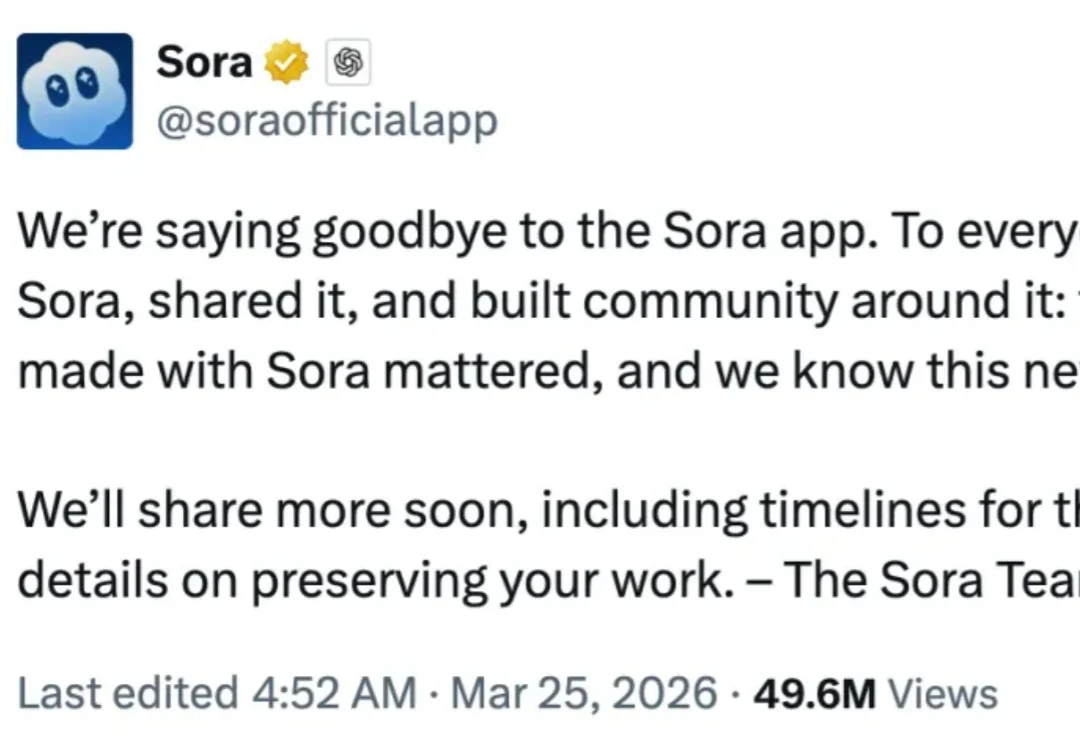
刚刚,一则消息让已经被 OpenAI 放弃的视频生成模型 Sora,再次回到公众视野。
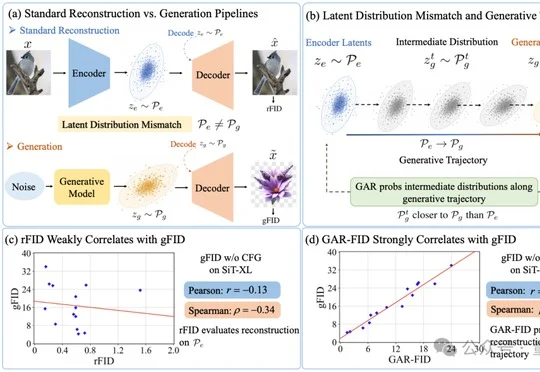
让图像生成模型先把图片压缩到潜空间,再由生成器在潜空间中作画,已成为常见路线。为了挑选图像编码器和解码器,研究者往往先看“重建”——把原图编码后再解码,所得图片是否逼真。
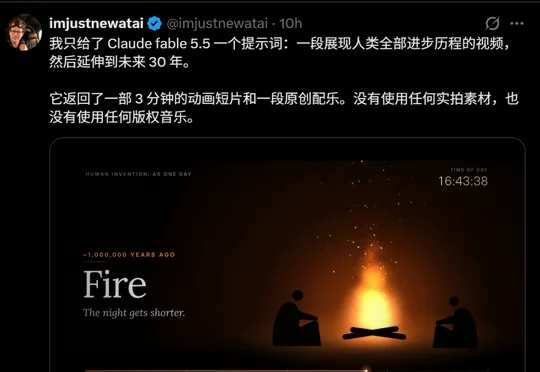
今天,外网被这个视频刷屏了。有人用Fable 5.5一键生成了一部「人类数万年进化史」,把整个人类历史压缩进了3分钟。整个过程,都是用纯代码写出,零视频素材,零版权音乐,没有使用任何视频生成模型。
TaoMate-H3 是由阿里巴巴 TaoLive AIGC 团队研发的音视频联合流式生成模型。基于 MiniMax H3,TaoMate-H3 将三步 LoRA 推理与自回归生成相结合,能够根据文本