AI资讯新闻榜单内容搜索-o

AITNT-国内领先的一站式人工智能新闻资讯网站
# 热门搜索 #
搜索: o
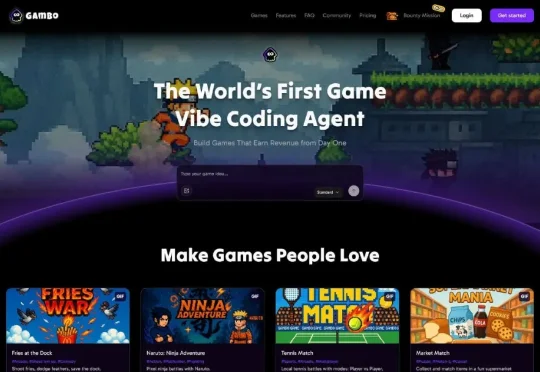
AI 时代的「4399」!我只用十五分钟做出了《技能五子棋》|AI 上新

AI 时代的「4399」!我只用十五分钟做出了《技能五子棋》|AI 上新

AI 时代的「4399」!我只用十五分钟做出了《技能五子棋》|AI 上新

在 Gambo 里,你不需要敲代码、不需要学美术、不需要处理角色、动画、地图、音效之间的复杂关系。你只需要不断地告诉它:你要做什么类型的游戏、希望有什么机制、哪里需要改得更好玩一点。

来自主题: AI资讯
10853 点击    2025-12-29 19:16
前字节技术负责人创业,要做企业级Coding Agent平台,已获数千万元融资

前字节技术负责人创业,要做企业级Coding Agent平台,已获数千万元融资

前字节技术负责人创业,要做企业级Coding Agent平台,已获数千万元融资

企业级场景和Vibe Coding,很大程度是相悖的。 文|邓咏仪 编辑|苏建勋 仅用半年时间,杨萍就目睹了AI Coding赛道有多疯狂。 2024年,Vibe Coding赛道发展如火如荼。Cur
来自主题: AI资讯
9158 点击    2025-12-29 19:15
CC之父自曝实际生产数据:30天,259个PR,共497次提交,全由CC编写!Claude可以连续数天运行,代码已不再是瓶颈

CC之父自曝实际生产数据:30天,259个PR,共497次提交,全由CC编写!Claude可以连续数天运行,代码已不再是瓶颈

CC之父自曝实际生产数据:30天,259个PR,共497次提交,全由CC编写!Claude可以连续数天运行,代码已不再是瓶颈

惊到了!Claude Code之父 Boris Cherny 刚跟大神卡帕西友好互动了“9级大地震”的帖子,后脚就在X上放出自己过去一个月使用CC的真实生产数据:
来自主题: AI资讯
7120 点击    2025-12-29 16:08
良心老黄不搞硅谷资本家那套!Groq人均套现500万美元

良心老黄不搞硅谷资本家那套!Groq人均套现500万美元

良心老黄不搞硅谷资本家那套!Groq人均套现500万美元

更多英伟达收购「TPU之父」创业公司Groq的细节曝光了—— 主打一个黄仁勋BOSS直聘。
来自主题: AI资讯
11821 点击    2025-12-29 15:36
Z Product|估值10亿美金的计费系统Metronome,如何成为OpenAI、英伟达首选的计价底层

Z Product|估值10亿美金的计费系统Metronome,如何成为OpenAI、英伟达首选的计价底层

Z Product|估值10亿美金的计费系统Metronome,如何成为OpenAI、英伟达首选的计价底层

Metronome成立于2019年的旧金山,专注于为AI与软件公司提供实时计费基础设施,解决从传统按Seat收费转向按用量、Token等复杂定价的工程难题。目前其融资总额达1.28亿美元,已服务OpenAI、NVIDIA、Databricks等头部企业,终端用户超1.5亿,成为AI时代“按价值收费”的关键基础设施。
来自主题: AI资讯
10719 点击    2025-12-29 15:35
英国想当“AI超级大国”,结果卡在这儿了...

英国想当“AI超级大国”,结果卡在这儿了...

英国想当“AI超级大国”,结果卡在这儿了...

全球人工智能(AI)热潮下,英国斯塔默政府在今年1月推出了雄心勃勃的“人工智能机遇行动计划”(AI Opportunities Action Plan),目标是成为“人工智能超级大国”。
来自主题: AI资讯
8942 点击    2025-12-29 15:08
AI医生终于有了硬标尺!全球首个专病循证评测框架GAPS发布,蚂蚁联合北大王俊院士团队出品

AI医生终于有了硬标尺!全球首个专病循证评测框架GAPS发布,蚂蚁联合北大王俊院士团队出品

AI医生终于有了硬标尺!全球首个专病循证评测框架GAPS发布,蚂蚁联合北大王俊院士团队出品

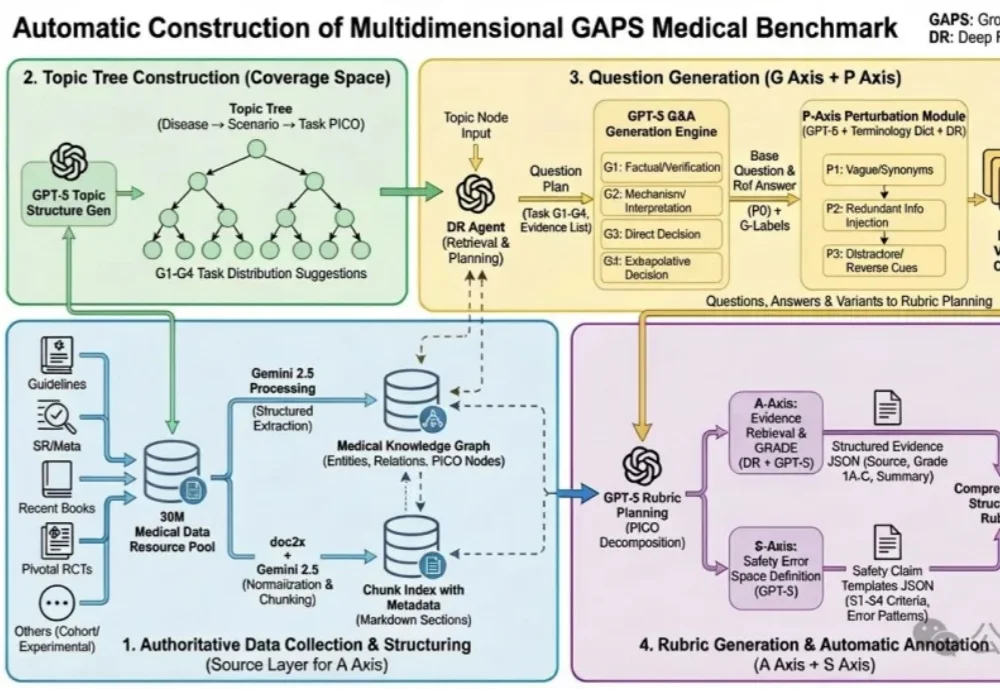
蚂蚁健康与北京大学人民医院王俊院士团队历时6个多月,联合十余位胸外科医生共同打磨,发布了全球首个大模型专病循证能力的评测框架—— GAPS(Grounding, Adequacy, Perturbation, Safety),及其配套评测集 GAPS-NSCLC-preview。
来自主题: AI技术研报
11862 点击    2025-12-29 15:06
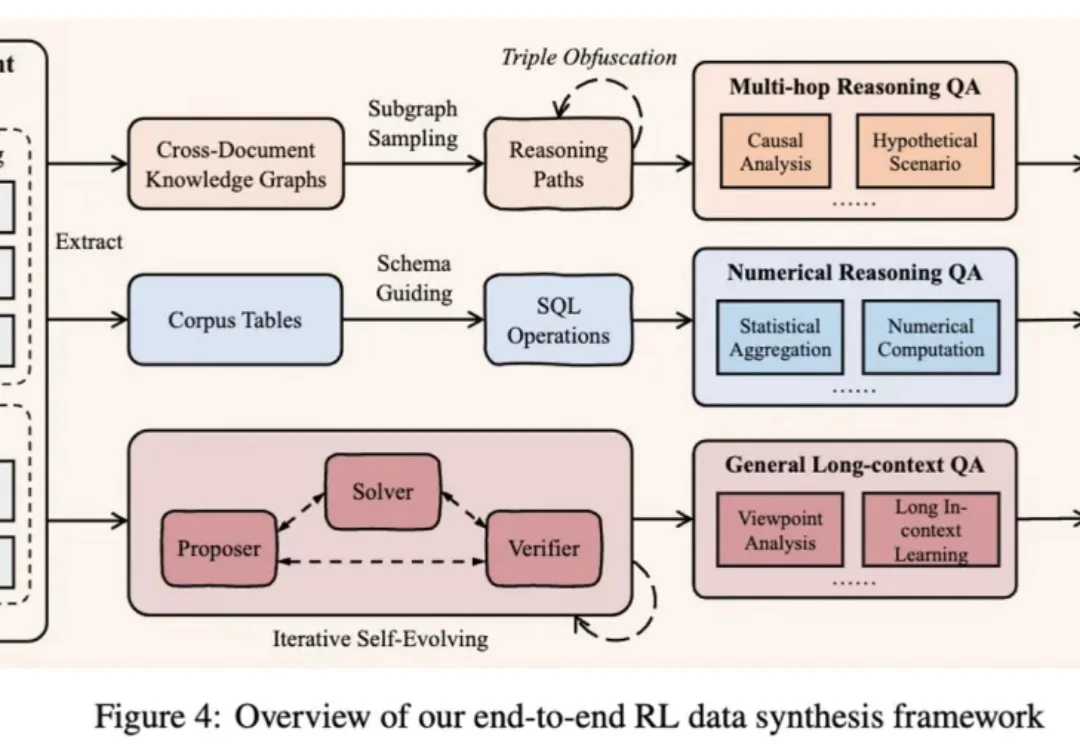
QwenLong-L1.5发布:一套配方,三大法宝,让30B MoE模型长文本推理能力媲美GPT-5

QwenLong-L1.5发布:一套配方,三大法宝,让30B MoE模型长文本推理能力媲美GPT-5

QwenLong-L1.5发布:一套配方,三大法宝,让30B MoE模型长文本推理能力媲美GPT-5

作为大模型从业者或研究员的你,是否也曾为一个模型的 “长文本能力” 而兴奋,却在实际应用中发现它并没有想象中那么智能?

来自主题: AI技术研报
9541 点击    2025-12-29 14:35