ICLR史无前例!中国团队站上C位,全球AI顶会首次为它设专场
ICLR史无前例!中国团队站上C位,全球AI顶会首次为它设专场史上首次,ICLR成立后设立机制设计相关Workshop,全球顶流学者众神云集!
来自主题: AI技术研报
10138 点击 2025-12-30 11:21

 搜索
史上首次,ICLR成立后设立机制设计相关Workshop,全球顶流学者众神云集!
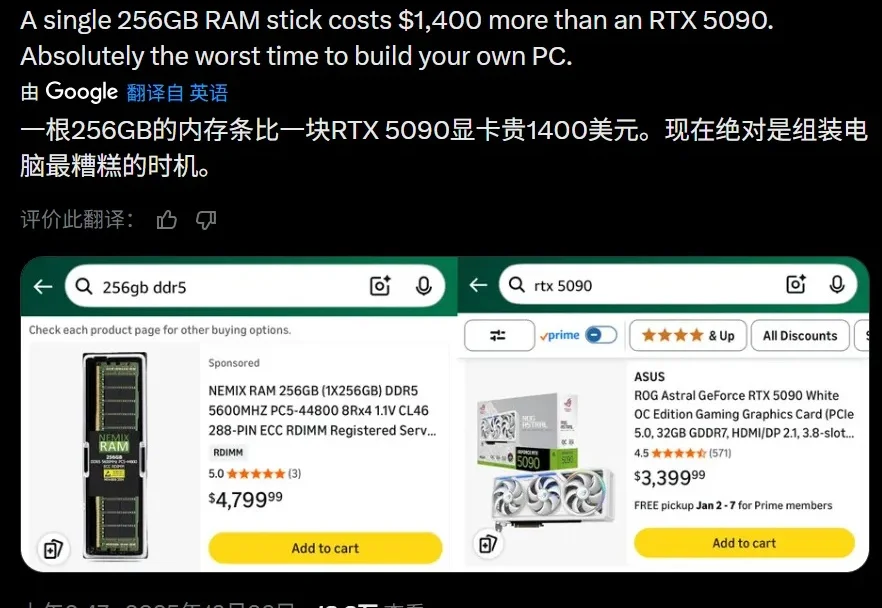
「我一直在告诉大家,如果你想买(电子)设备,现在就买。我自己要买的 iPhone 17 就已经下手了。」这是咨询公司 TrendForce 高级研究副总裁 Avril Wu 在最近接受采访时说的一句话。

2025年,AI终于从实验室冲进你的手机、浏览器,甚至购物车——但别被热闹骗了:赢家通吃的游戏从未如此真实。在 Andreessen Horowitz(a16z)最新发布的《2025消费级AI现状》年终报告中,我们看到一场表面百花齐放、实则高度集中的军备竞赛:ChatGPT 依然稳坐王座,Gemini 凭借一张“香蕉图”狂飙突进,而大多数用户——超过90%——根本懒得切换第二款AI。
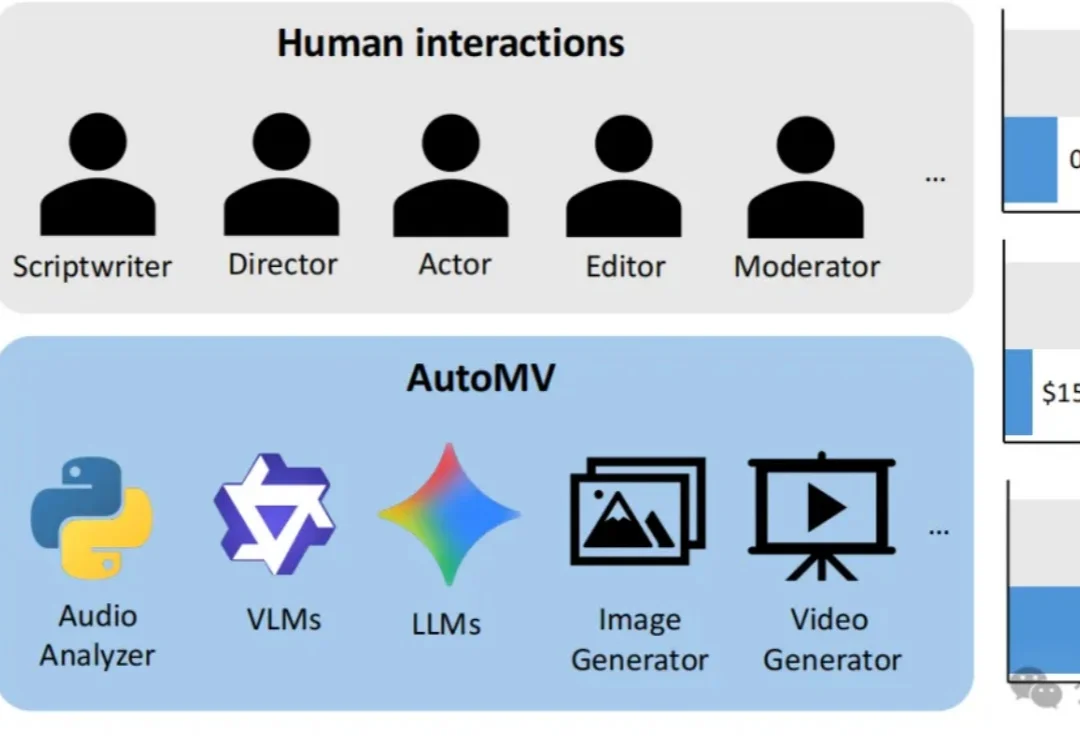
现有的AI视频生成模型虽然在短片上效果惊人,但面对一首完整的歌曲时往往束手无策——画面不连贯、人物换脸、甚至完全不理会歌词含义。
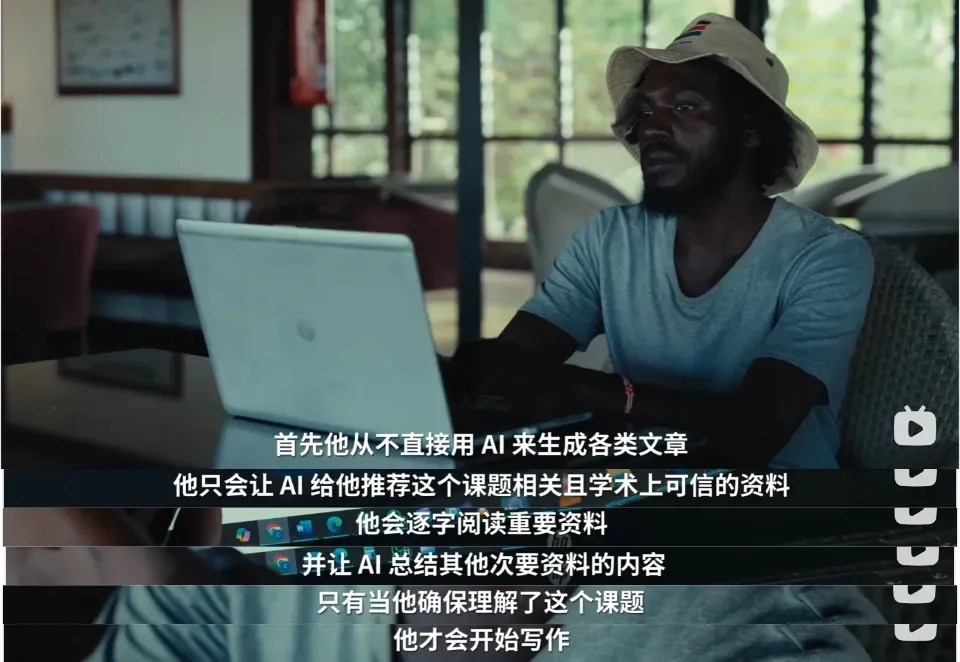
这两天,影视飓风那支《带着100万...我们去了论文代写聚集地》的视频彻底火了。大众的目光都被肯尼亚贫民窟里庞大的“论文代写产业链”所吸引,2.5美元的廉价劳动力、流水线般的学术欺诈。
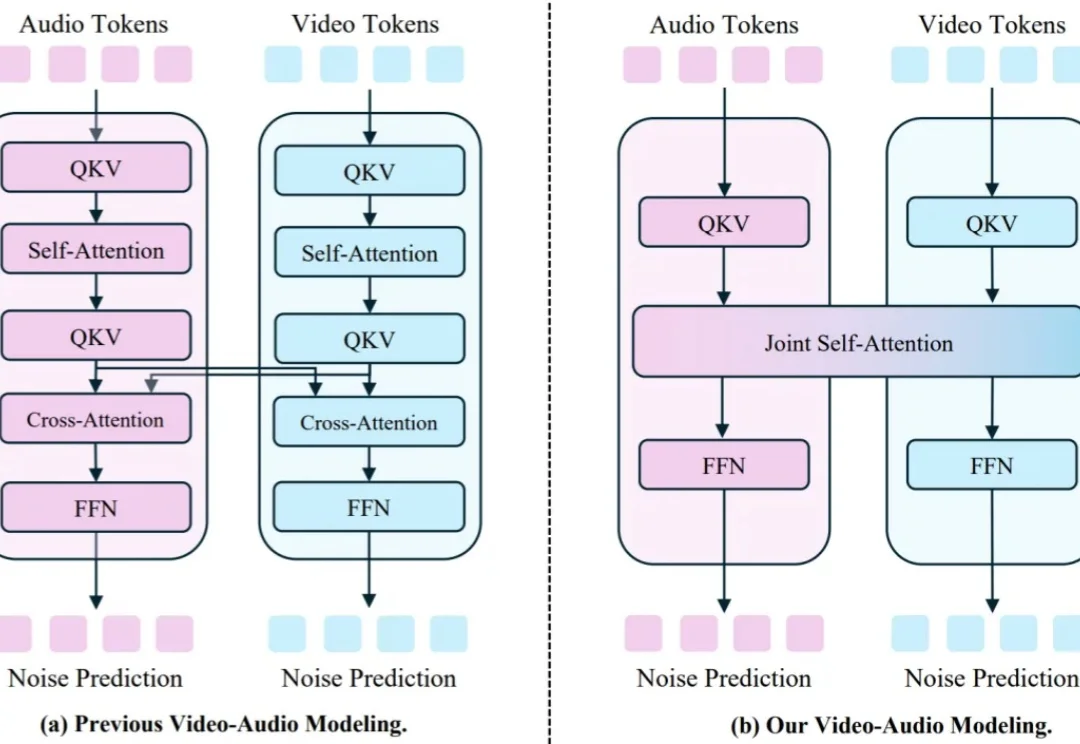
视频 - 音频联合生成的研究近期在开源与闭源社区都备受关注,其中,如何生成音视频对齐的内容是研究的重点。
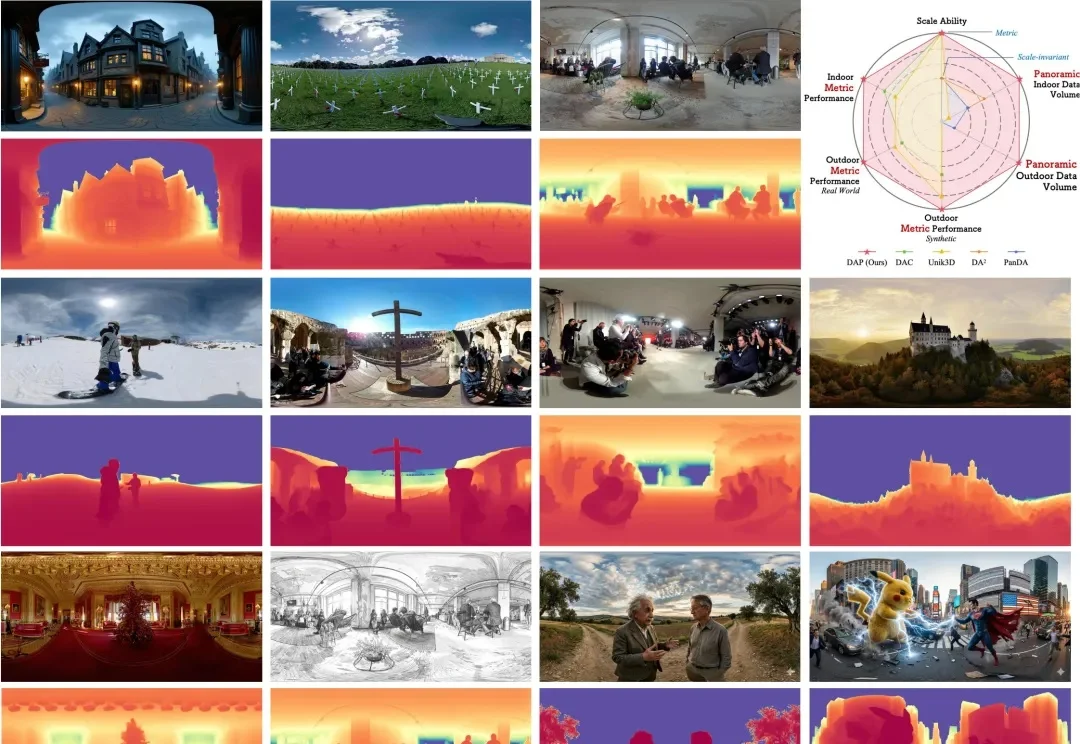
在空间智能(Spatial Intelligence)飞速发展的今天,全景视角因其 360° 的环绕覆盖能力,成为了机器人导航、自动驾驶及虚拟现实的核心基石。然而,全景深度估计长期面临 “数据荒” 与 “模型泛化差” 的瓶颈。
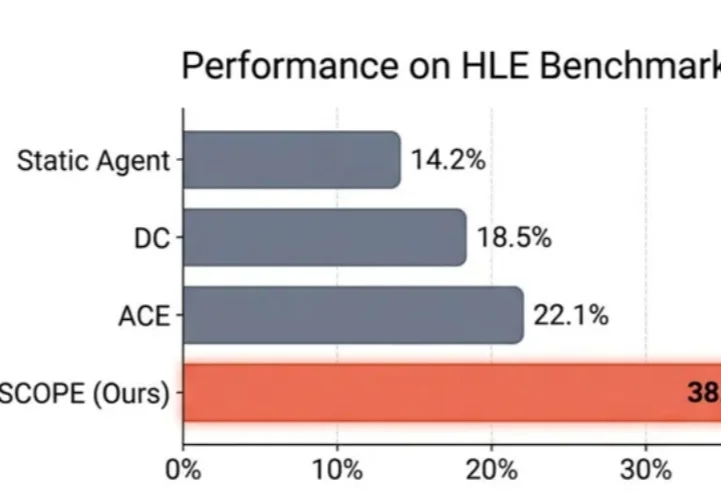
在 LLM Agent 领域,有一个常见的问题:Agent 明明 "看到了" 错误信息,却总是重蹈覆辙。
在电影与虚拟制作中,「看清一个人」从来不是看清某一帧。导演通过镜头运动与光线变化,让观众在不同视角、不同光照条件下逐步建立对一个角色的完整认知。然而,在当前大量 customizing video generation model 的研究中,这个最基本的事实,却往往被忽视。

世界模型的场景,不止在自动驾驶方面。 极客公园近期接触到的 Deep Optica,刚刚完成由 BV 百度风投、零以创投参与的种子轮融资,正试图从「判断方式」本身入手,为这一高度不确定的过程提供一种更加结构化的路径。