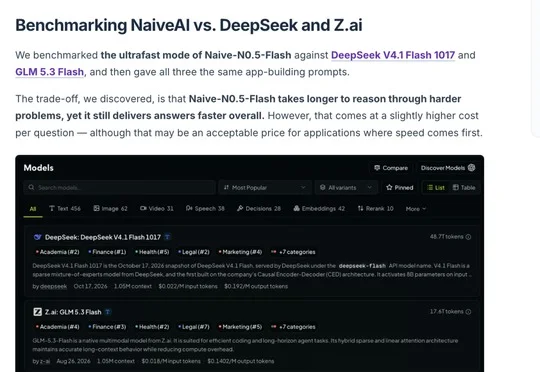
国产大模型又杀出一匹黑马,引发硅谷关注!
国产大模型又杀出一匹黑马,引发硅谷关注!Latent Space实测显示,NaiveAI开源模型Naive-N0.5-Flash综合能力介于DeepSeek V4.1 Flash 1017与GLM 5.3 Flash之间,编程单项评测反超,峰值速度约2100 Token/s,3D太阳系任务表现最佳。
来自主题: AI资讯
7748 点击 2026-11-14 12:48

 搜索
Latent Space实测显示,NaiveAI开源模型Naive-N0.5-Flash综合能力介于DeepSeek V4.1 Flash 1017与GLM 5.3 Flash之间,编程单项评测反超,峰值速度约2100 Token/s,3D太阳系任务表现最佳。
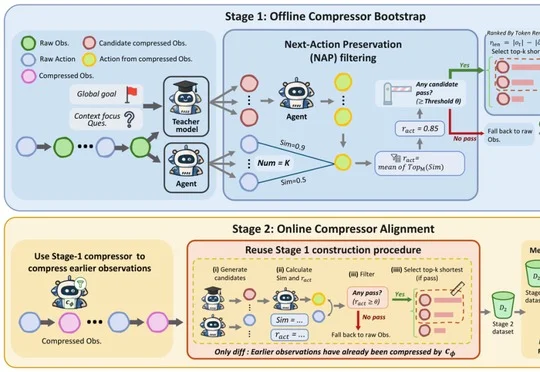
清华大学人工智能学院提出面向 Coding Agent 的 observation 压缩方法 CoACT,在 SWE-bench Verified 的三个 Agent 模型上平均减少 33.0% 总 token 消耗且 PASS@1 与未压缩时相近,该工作获 ICSE 2027 直接接收(Top 5%)。
等了半天,Gemini 4 Hydrogen没来。
最贵的模型,不该承包最简单的工作。
总参数量1.6万亿,每个Token激活约480亿参数。
这是鲁迅散文集《朝花夕拾》里的文章《藤野先生》,是每个上过初中的学生都会读到的一篇课文,在今天重新来看,多少有点荒谬——也就是藤野先生没有见过 AI。
终于有人出手反制REA了。
毫无预警,Anthropic深夜丢出了下一代旗舰Fable 5.2,直接杀入了物理世界。
一天烧掉 100 美元,是平时一周 Token 预算的 5 倍!
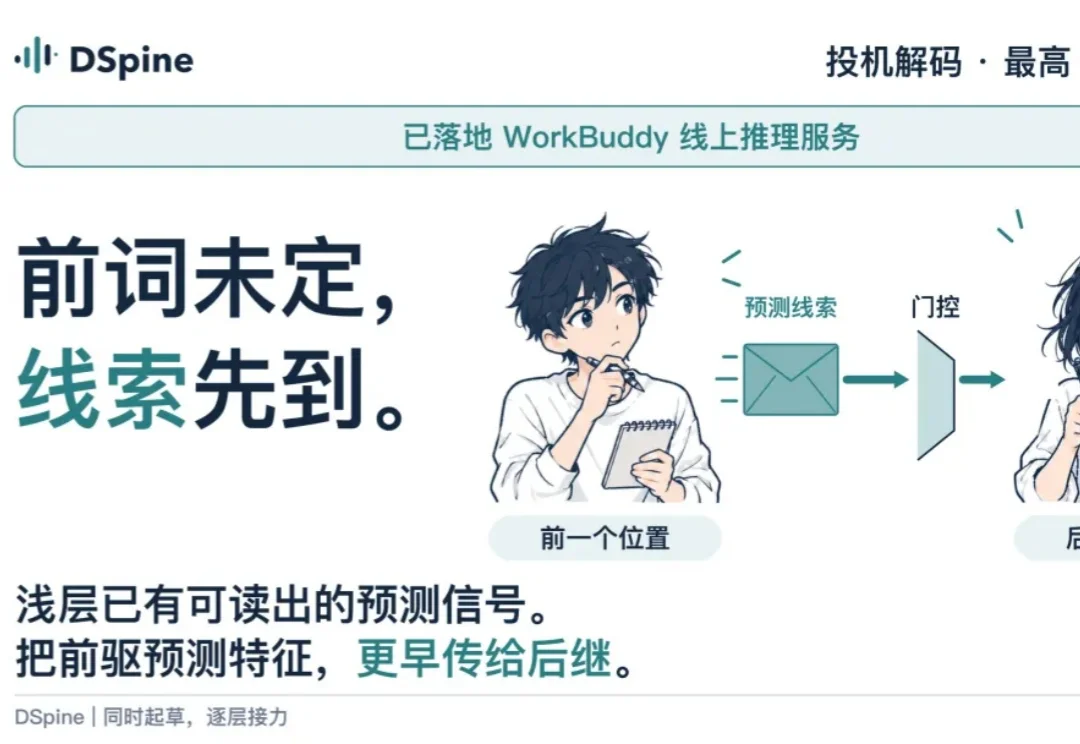
在大型语言模型(LLM)的无损推理加速中,推测解码(Speculative Decoding)已成为工业界标配。以 EAGLE-3 为代表的自回归草稿模型虽然预测准,但每多猜一个 token 就要多跑一步串行前向;而受扩散语言模型启发的 DFlash 将草稿生成彻底并行化 —— 一次骨干网络前向即可同时吐出整块候选 token,大幅压缩了起草耗时。