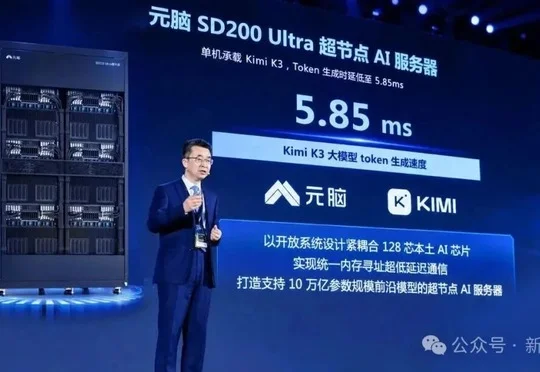
AI自己榨干算力!让Kimi K3自己写「超级算子」,推理快了3倍
AI自己榨干算力!让Kimi K3自己写「超级算子」,推理快了3倍Inferact开源TPU巨型算子与浪潮信息发布元脑SD200 Ultra超节点服务器,两家公司分别用谷歌TPU v7和128颗本土AI芯片,通过算子融合让Kimi K3推理性能提升3倍以上,且浪潮信息让K3自主编写超级算子。
来自主题: AI资讯
8474 点击 2026-09-30 11:55

 搜索
Inferact开源TPU巨型算子与浪潮信息发布元脑SD200 Ultra超节点服务器,两家公司分别用谷歌TPU v7和128颗本土AI芯片,通过算子融合让Kimi K3推理性能提升3倍以上,且浪潮信息让K3自主编写超级算子。
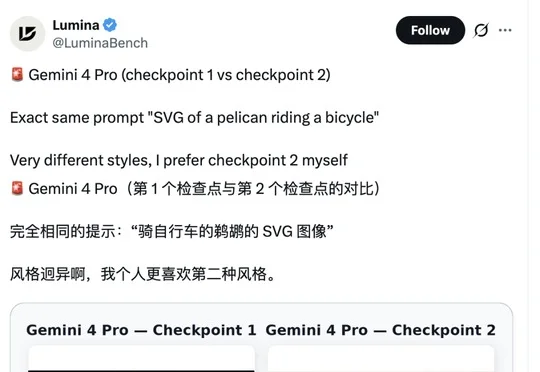
谷歌DeepMind确认Gemini 4进入后训练早期并加速发布,计划通过SpaceX发射搭载TPU芯片的卫星测试太空算力,前DeepMind工程师Robert O'Callahan因认为AI发展太快宣布辞职。
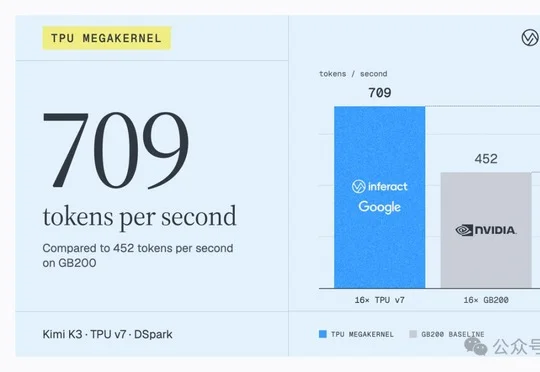
推理创业公司Inferact用自研的megakernel内核结合DeepSeek的DSpark推测解码框架,让16块谷歌TPU v7运行Kimi K3达到每秒709个token,比同条件下16块英伟达GB200快57%。
英伟达死守的推理性价比神话,碎了。
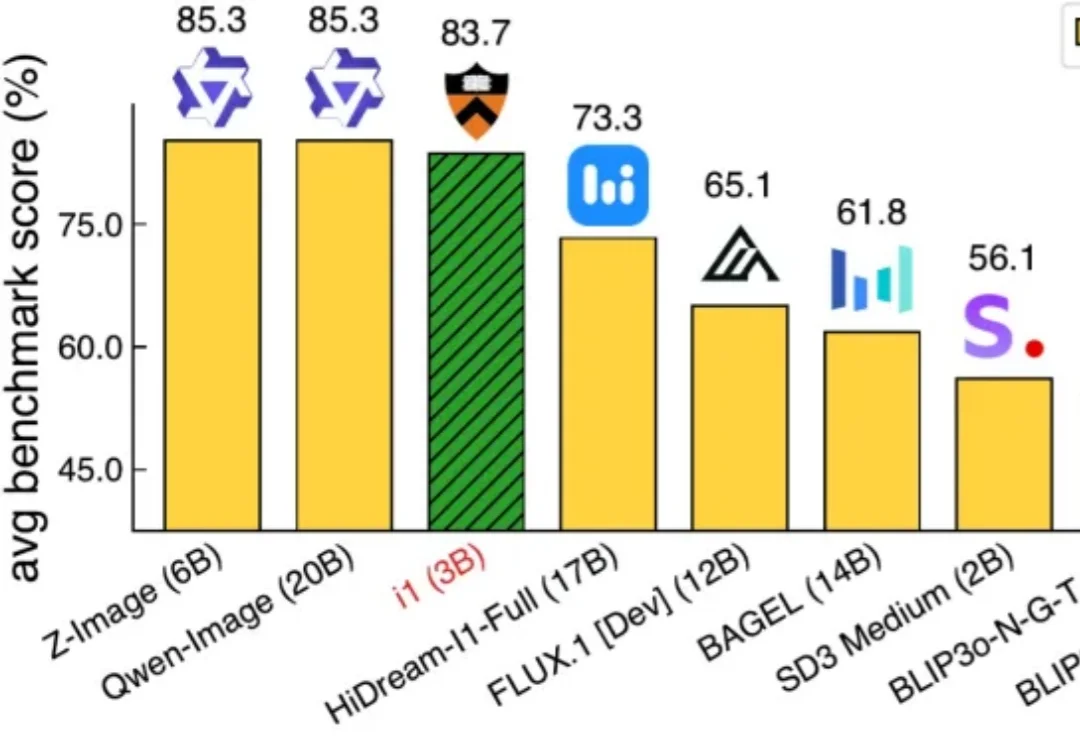
近来文生图模型发展迅速,但每篇工作多是独立地引入一整套模型、数据和训练设计,然后用私有的数据训出来了一个亮眼的模型。
今天一大早,AI圈被这个消息刷屏了。外媒曝出猛料:Anthropic成功挖角前谷歌高管、大名鼎鼎的「TPU之父」Amir Salek!看来,Anthropic要自己造芯片了。此前,Anthropic就从OpenAI那里挖来了自研芯片骨干。
2026 年的 YC Startup School 上,Jeff Dean 的声音有些沙哑。
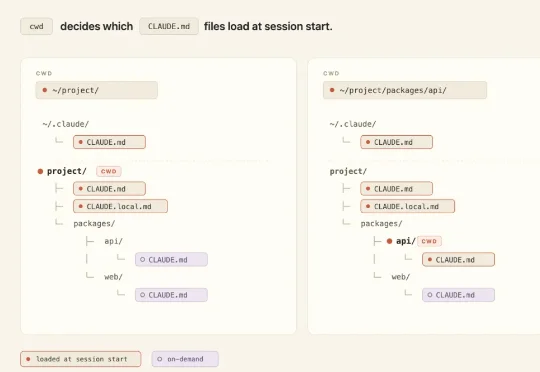
在常规的对话外,Claude Code(也可以是 Codex)其实还提供了一些别样的控制(或者说:上下文注入)方法,比如:CLAUDE.md、Rules、Skills、Subagents、Hooks、Output Styles、以及 System Prompt Append
The Information 周一报道称,Google 在数月测试这家芯片制造商的技术后,决定委托英特尔生产部分张量处理单元(TPU)。该媒体指出,由于台湾芯片制造商台积电的产能持续供不应求,英特尔正从 Google 等企业获得订单。
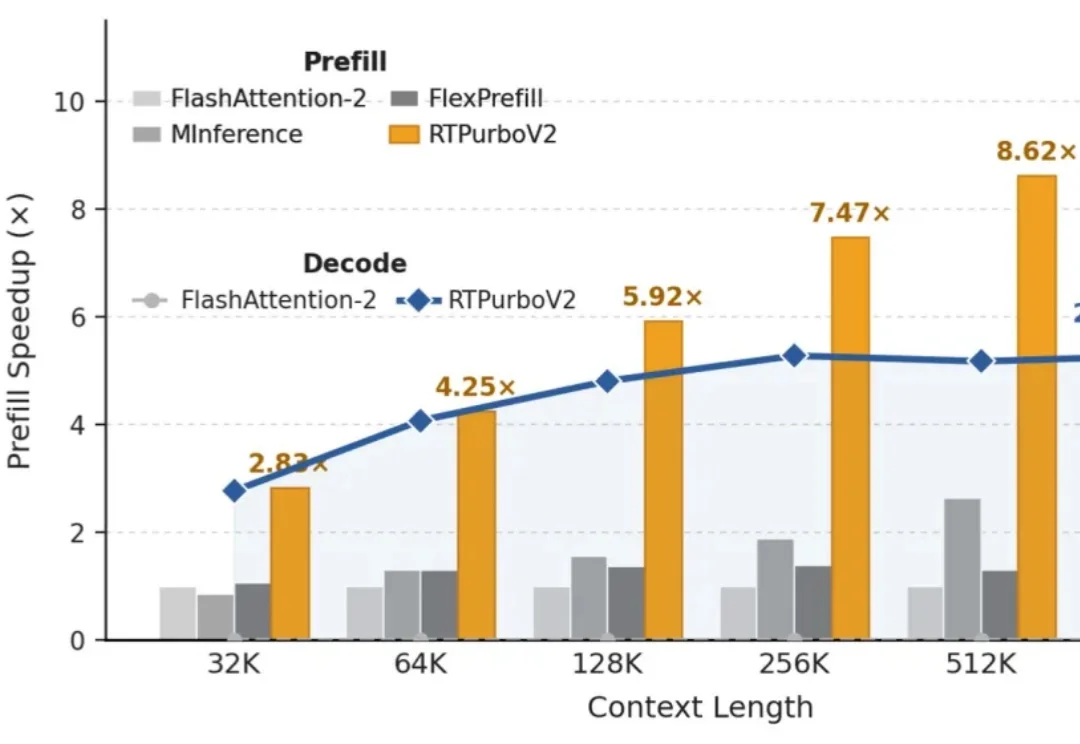
“Full Attention 正在被遗忘”