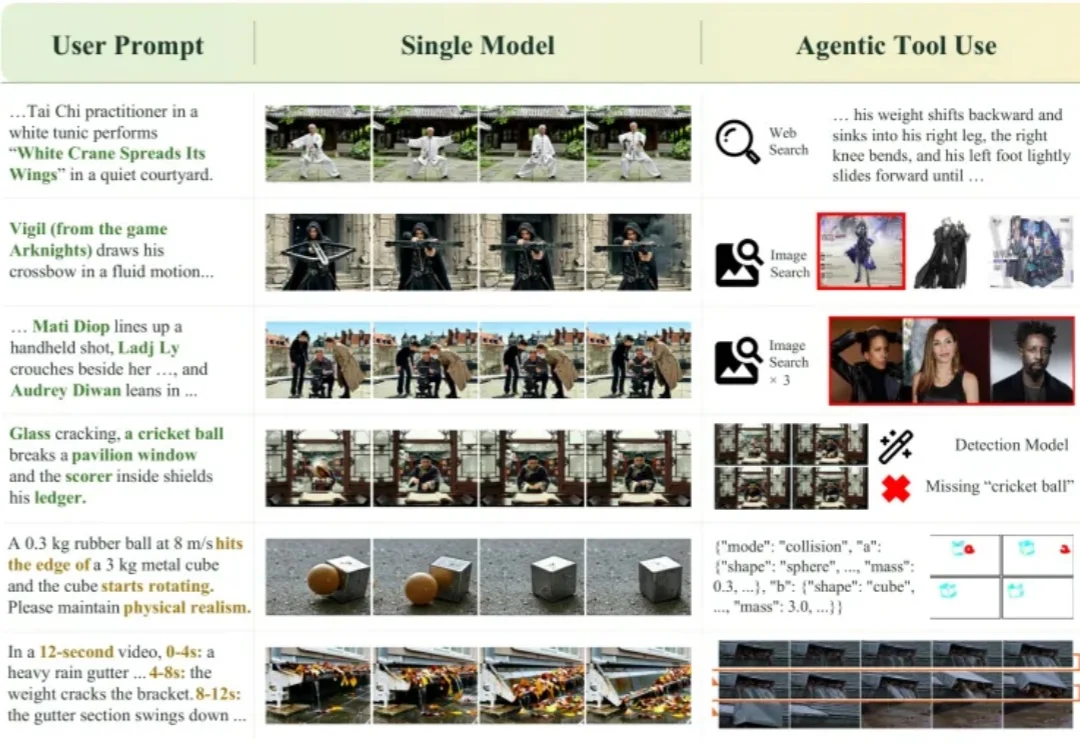
视频生成也能查资料、做模拟:8B智能体学会自主调用工具
视频生成也能查资料、做模拟:8B智能体学会自主调用工具从检索动作知识、寻找角色参考,到模拟运动和衔接镜头,一个经过强化学习的智能体,能给视频生成带来多大提升?
来自主题: AI技术研报
7992 点击 2026-10-09 11:34

 搜索
从检索动作知识、寻找角色参考,到模拟运动和衔接镜头,一个经过强化学习的智能体,能给视频生成带来多大提升?
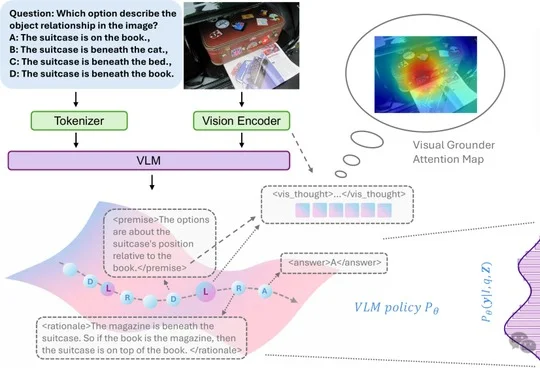
埃默里大学提出的Decompose–Look–Reason(DLR)框架被EMNLP 2026接收,该方法通过分解问题、按premise提取视觉latent再推理,在Qwen3-VL-8B-Thinking上于V*、MathVista等基准取得显著提升。
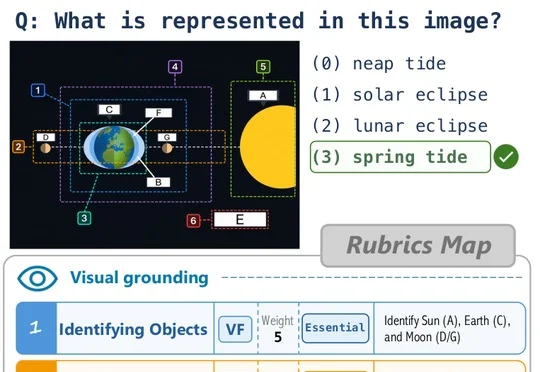
南洋理工大学S-Lab、A*STAR与UIUC联合提出的V-Rubrics方法将5万视觉样本拆分为35万条细粒度准则,从视觉忠实性、推理一致性和指令遵循三维度分别参与强化学习奖励分配,使基于Qwen3-VL-8B的模型在通用与知识评测中平均得分提升至68.04。
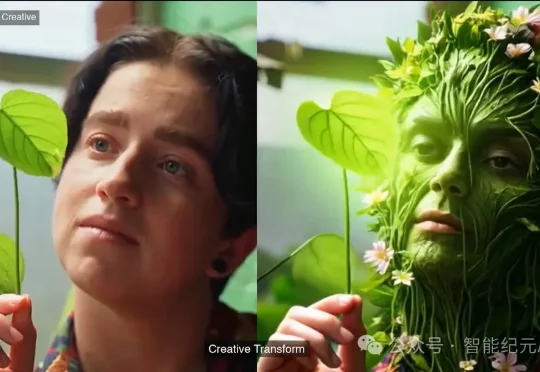
独家获悉,字节跳动日前低调公布全球首个25B级、基于混合专家 (MoE) -扩散自注意力机制(DiT) 的开源增强统一多模态模型Mamoda2.5。Mamoda2.5依托Qwen3-VL-8B、128 个专家,Top-8 路由的MoE+DiT架构搭建,最终模型参数高达250亿,而每次仅激活约30亿参数(约12%)。
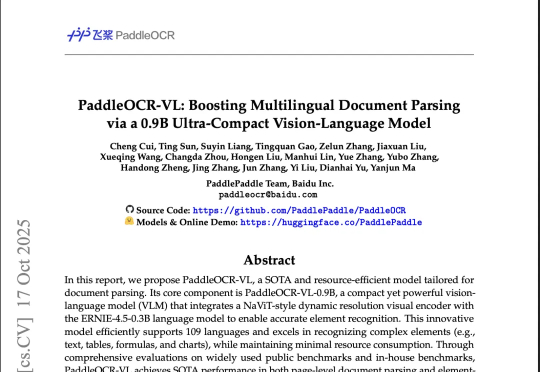
整个Hugging Face的趋势版里,前4有3个OCR,甚至Qwen3-VL-8B也能干OCR的活,说一句全员OCR真的不过分。然后在我上一篇讲DeepSeek-OCR文章的评论区里,有很多朋友都在把DeepSeek-OCR跟PaddleOCR-VL做对比,也有很多人都在问,能不能再解读一下百度那个OCR模型(也就是PaddleOCR-VL)。