刚刚,DeepSeek 开放全家桶 API,人人都能打造自己的超级 App
刚刚,DeepSeek 开放全家桶 API,人人都能打造自己的超级 AppDeepSeek 正式开放全家桶 API,V4.1-Flash(deepseek-flash)支持联网搜索、文件解析、链接阅读、语音交互及 Search、Fetch、OCR、ASR、TTS 独立调用,并开源聊天应用 Demo,降低开发者打造个性化超级 App 的门槛。
搜索
DeepSeek 正式开放全家桶 API,V4.1-Flash(deepseek-flash)支持联网搜索、文件解析、链接阅读、语音交互及 Search、Fetch、OCR、ASR、TTS 独立调用,并开源聊天应用 Demo,降低开发者打造个性化超级 App 的门槛。
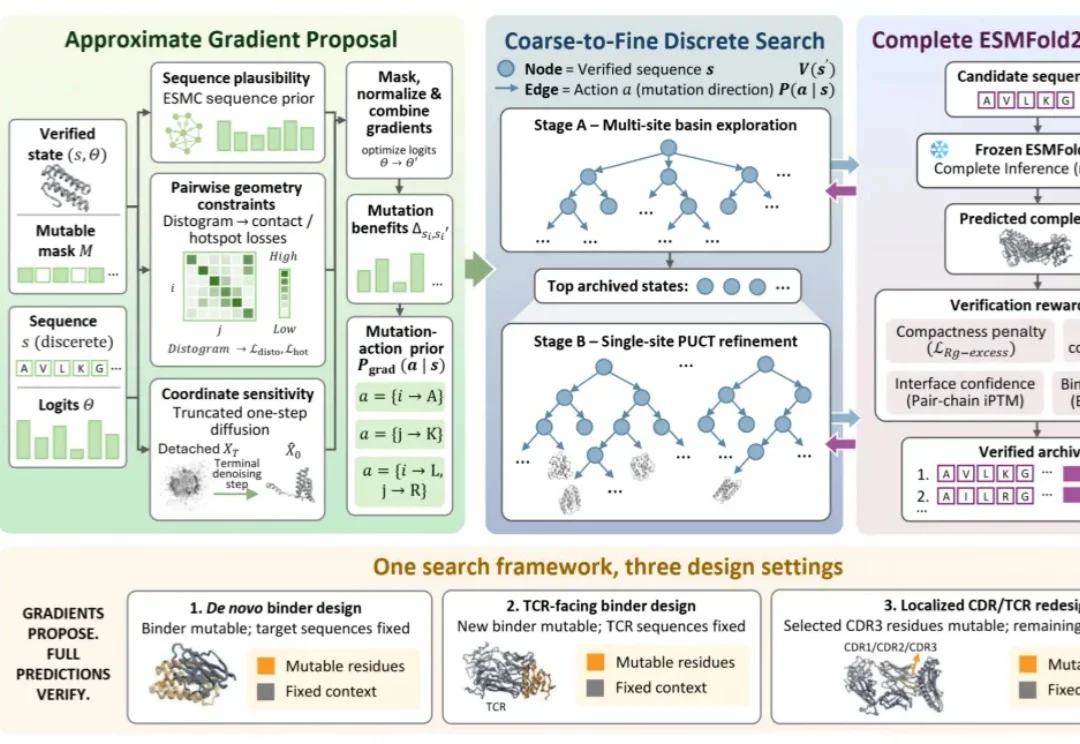
庞大的序列搜索空间,是蛋白质设计面临的核心难题之一。
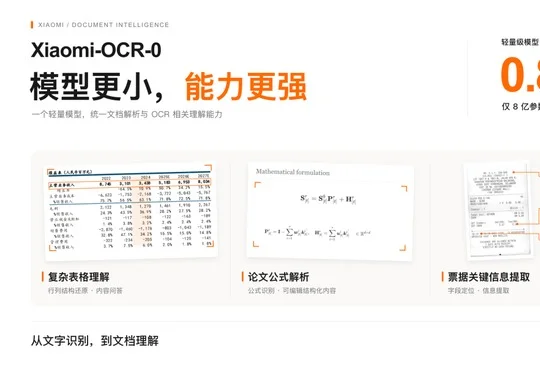
小米发布并开源0.8B文档理解模型Xiaomi-OCR-0,融合文档解析、关键信息抽取与视觉问答,在OmniDocBench v1.6获96.83分并位列1B以下第一,相关技术正用于小米手机“超级小爱”的识屏办事场景。
随着多模态大模型越来越强,OCR的短板反而逐渐明显。
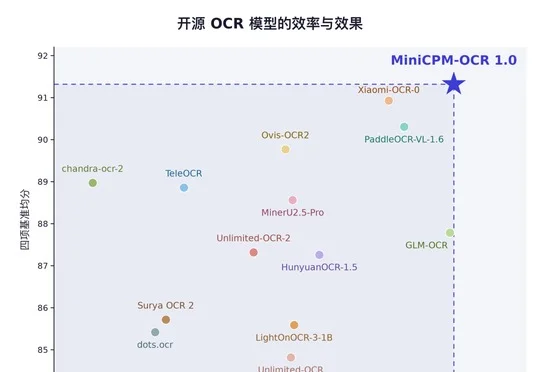
面壁智能开源MiniCPM-OCR 1.0与MiniCPM-OCR Jev,前者以1.3B参数取得4项SOTA并登顶吞吐,后者独立为OCR结果校准置信度并触发重读或人工复核。
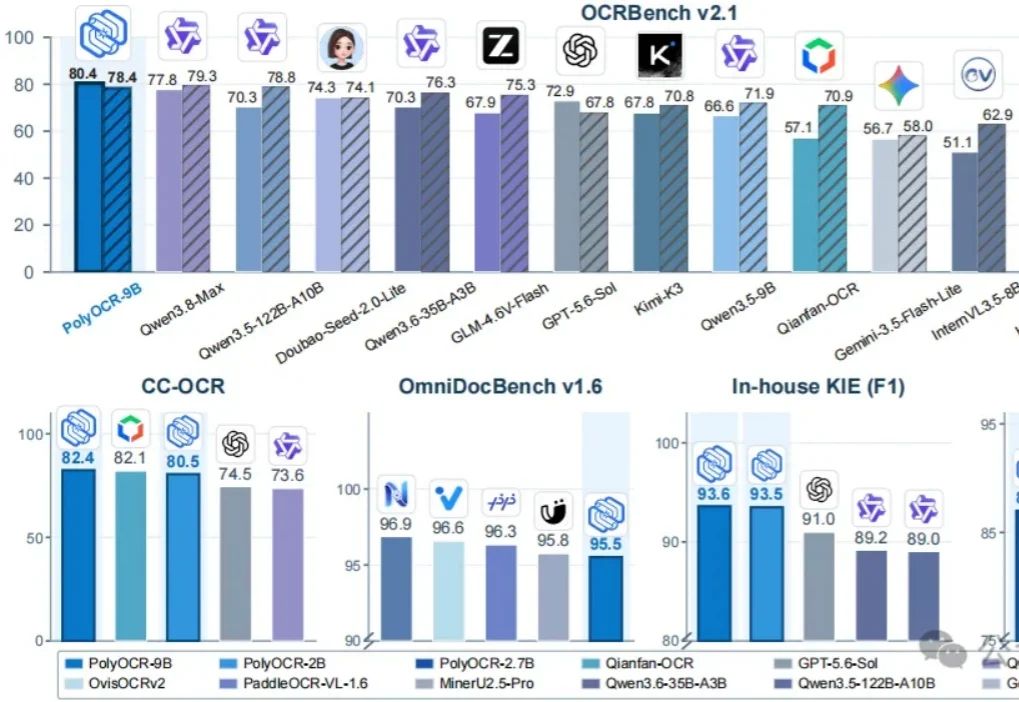
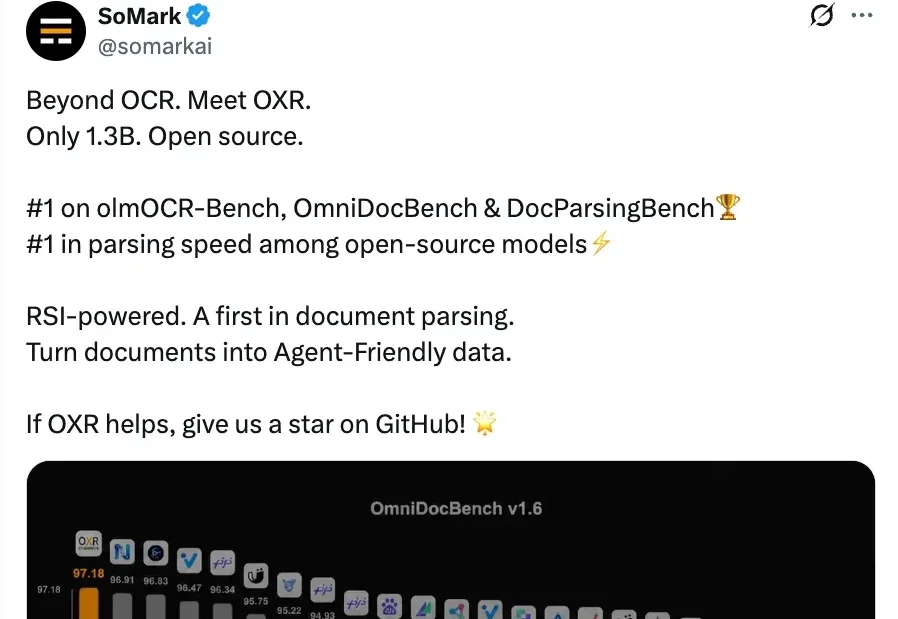
不er,RSI应用在OCR上,效果这么猛??
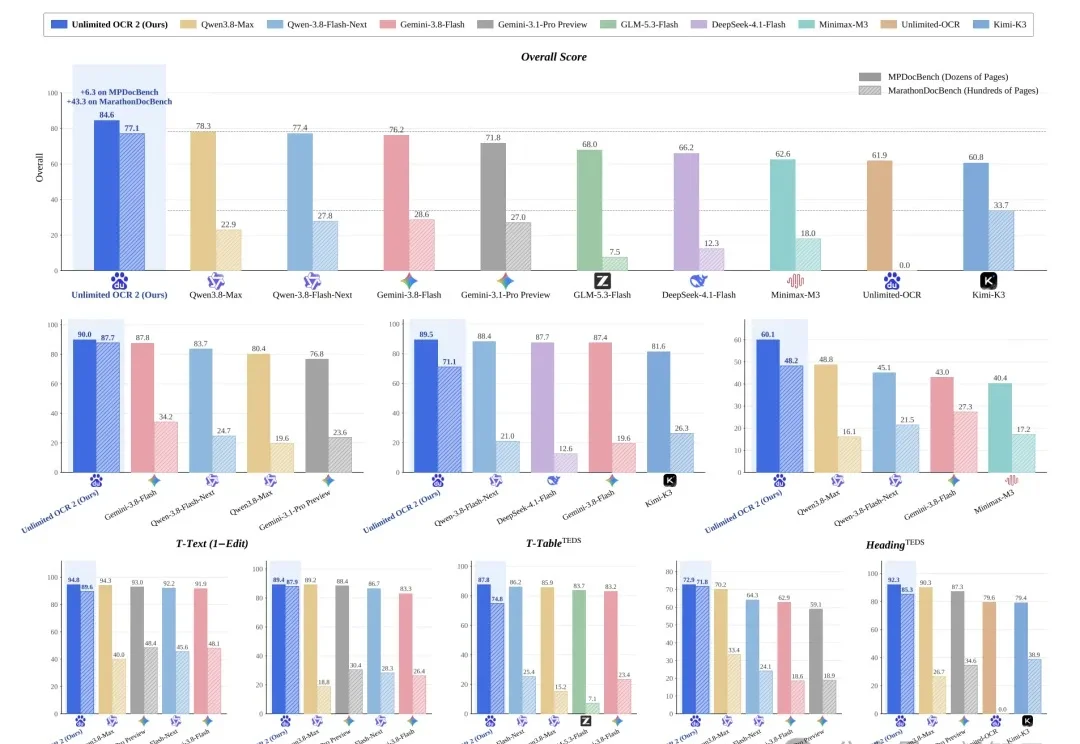
曾获LeCun转发推荐、狂揽1,000万下载的百度开源神作,又杀回来了!
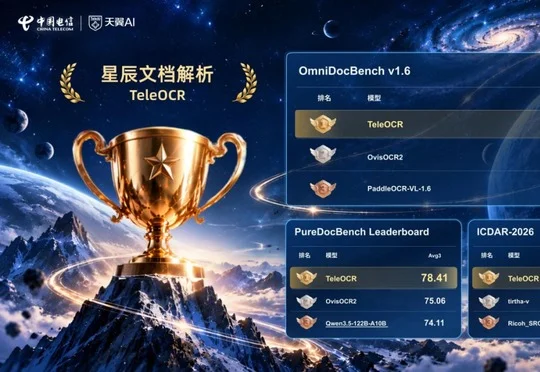
中国电信星辰通用人工智能实验室推出的轻量化文档解析模型TeleOCR(约1.2B参数)凭借形变感知学习、多边形版面分割、CGDP采样及内容—结构解耦等技术创新,在OmniDocBench v1.6、Wild-OmniDocBench、PureDocBench等多个公开榜单取得领先,并在ICDAR 2026 Sci-ImageMiner挑战赛中夺冠,目前已开源。
Jina AI 发布端到端文档解析模型 jina-ocr-v1,以 3.4B 总参数/570M 激活参数在 OmniDocBench v1.6 与 olmOCR-Bench 上刷新同级别最佳成绩,并凭借 FastMTP 推测解码与分级密集奖励在低成本 GPU 上实现无损近倍速生成,单页仅输出 1085 个 token 以 2.57 页/秒吞吐领跑 14 款主流系统。
前不久,微信视觉团队开源了WeMM-Embedding。