在线蒸馏灵活却太慢,离线缓存高效却不够灵活,LinkedIn 如何取舍?
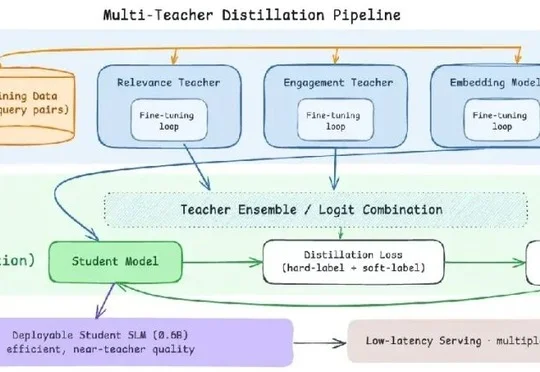
在线蒸馏灵活却太慢,离线缓存高效却不够灵活,LinkedIn 如何取舍?LinkedIn 公开其 AI 职位搜索的多教师蒸馏训练基础设施,通过基于 SGLang 的定制框架结合在线与离线蒸馏方案,并叠加 LiGer、多节点训练、FSDP2 及 H200 集群等优化,实现约 8 倍训练加速,将 80 亿参数相关性模型和 17 亿参数互动模型的知识压缩至 6 亿参数排序模型,使职位搜索 NDCG@10 提升 24.48%。
搜索
LinkedIn 公开其 AI 职位搜索的多教师蒸馏训练基础设施,通过基于 SGLang 的定制框架结合在线与离线蒸馏方案,并叠加 LiGer、多节点训练、FSDP2 及 H200 集群等优化,实现约 8 倍训练加速,将 80 亿参数相关性模型和 17 亿参数互动模型的知识压缩至 6 亿参数排序模型,使职位搜索 NDCG@10 提升 24.48%。
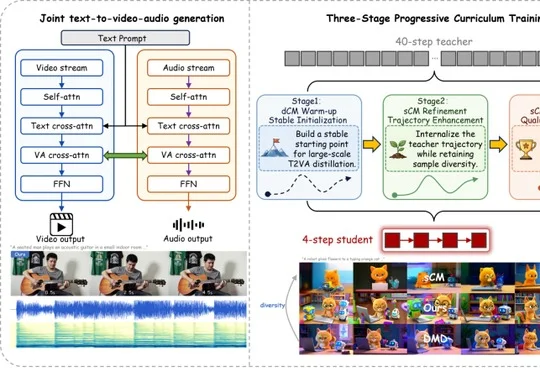
浙江大学、清华大学与新加坡国立大学团队推出TurboT2VA,采用分布蒸馏与轨迹蒸馏联合方案将音视频生成速度提升54.67倍,在单张H20上将1024×1792分辨率121帧的生成耗时从318.74秒降至5.83秒。
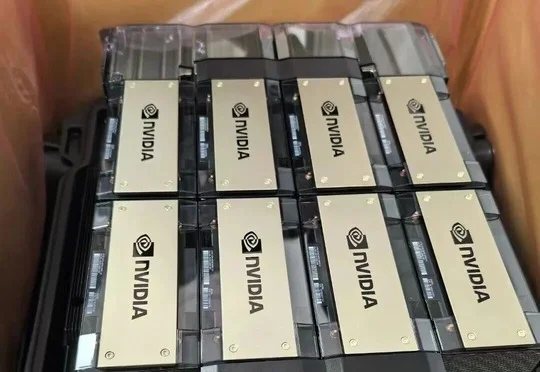
文章详细介绍了将H200 SXM单模组组装成H200服务器的全流程,包括施工前准备、单卡模组安装、散热系统配置、整机硬件复原、软件环境初始化、上线前检查清单,并总结了电力规划、网络配置、NCCL调优及螺丝扭矩等实战中容易翻车的环节。
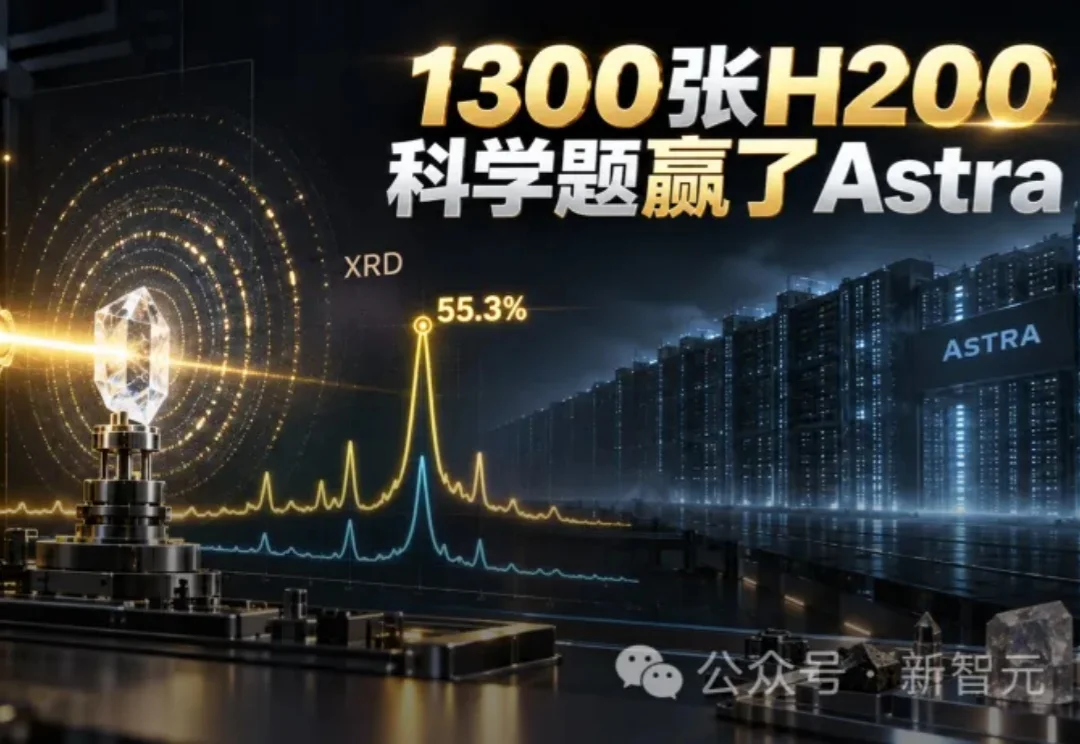
只用1300张H200,在一项硬核科学基准上,赢了GPT-6 Astra。
在IDC报告数据中,2025年中国具身智能云市场已经达到10.51亿元。而一年前,按照Omdia发布的《中国具身智能AI云市场1H25》报告,中国具身智能云服务市场规模约为1800万美元。相当于市场扩增了10倍。
首次参展的 AI 原生企业与爱为舞,直接把一座开放式「AI 学习实验室」搬进了世博展览馆 H2-E505 展位。没有大屏循环播片,也不是观众站一圈看完就走。你是真的能坐下来,亲手一试:学习这件事,确实换了个打开方式。
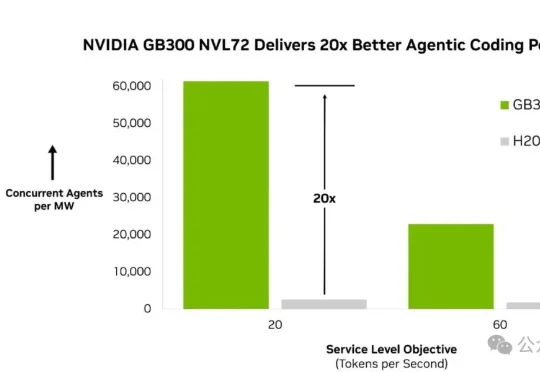
同样一兆瓦电,英伟达最新的GB300 NVL72能同时扛住61400个智能体,上一代H200只扛得住大约2600个。这中间,差了整整20倍。它就是独立评测机构Artificial Analysis发布的新基准:AA-AgentPerf。
AI抗衰药物研发公司「无尽方舟」已完成数千万元种子轮融资,Monolith领投,九合创投跟投。此次融资将主要用于加速核心药物的工程化生产与猫狗临床验证,并同时推进H2P跨物种平台及干湿结合药物研发平台两大AI系统的建设。
2026 年 5 月的硅谷,对于 AI 算力的“饥荒”和焦虑,正达到一个前所未有的高度。
Prime Intellect把Opus 4.7和GPT 5.5关进H200集群,不给人类指导,跑了1万次实验。结果:AI第一次在科研竞赛中打破人类纪录。2930步,递归自改进的卢比孔河,被跨过了。