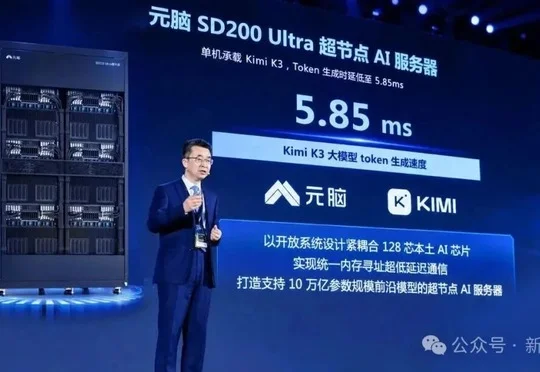
AI自己榨干算力!让Kimi K3自己写「超级算子」,推理快了3倍
AI自己榨干算力!让Kimi K3自己写「超级算子」,推理快了3倍Inferact开源TPU巨型算子与浪潮信息发布元脑SD200 Ultra超节点服务器,两家公司分别用谷歌TPU v7和128颗本土AI芯片,通过算子融合让Kimi K3推理性能提升3倍以上,且浪潮信息让K3自主编写超级算子。
来自主题: AI资讯
8510 点击 2026-09-30 11:55

 搜索
Inferact开源TPU巨型算子与浪潮信息发布元脑SD200 Ultra超节点服务器,两家公司分别用谷歌TPU v7和128颗本土AI芯片,通过算子融合让Kimi K3推理性能提升3倍以上,且浪潮信息让K3自主编写超级算子。
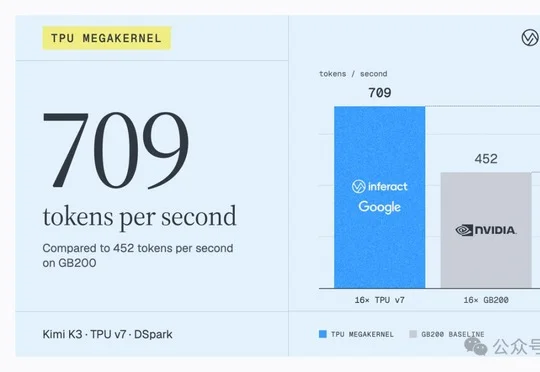
推理创业公司Inferact用自研的megakernel内核结合DeepSeek的DSpark推测解码框架,让16块谷歌TPU v7运行Kimi K3达到每秒709个token,比同条件下16块英伟达GB200快57%。
大模型推理的基石 vLLM,现在成为创业公司了。
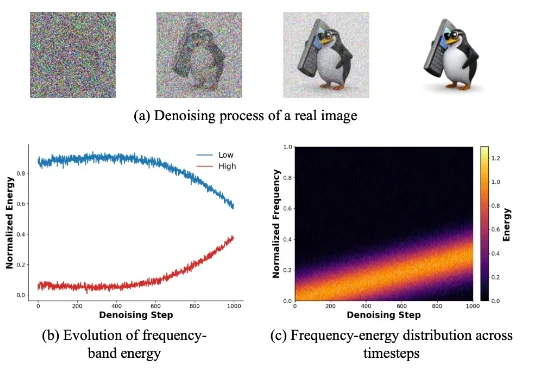
新加坡国立大学 LV Lab(颜水成团队) 联合电子科技大学、浙江大学等机构提出 FeRA (Frequency-Energy Constrained Routing) 框架:首次从频域能量的第一性原理出发,揭示了扩散去噪过程具有显著的「低频到高频」演变规律,并据此设计了动态路由机制。
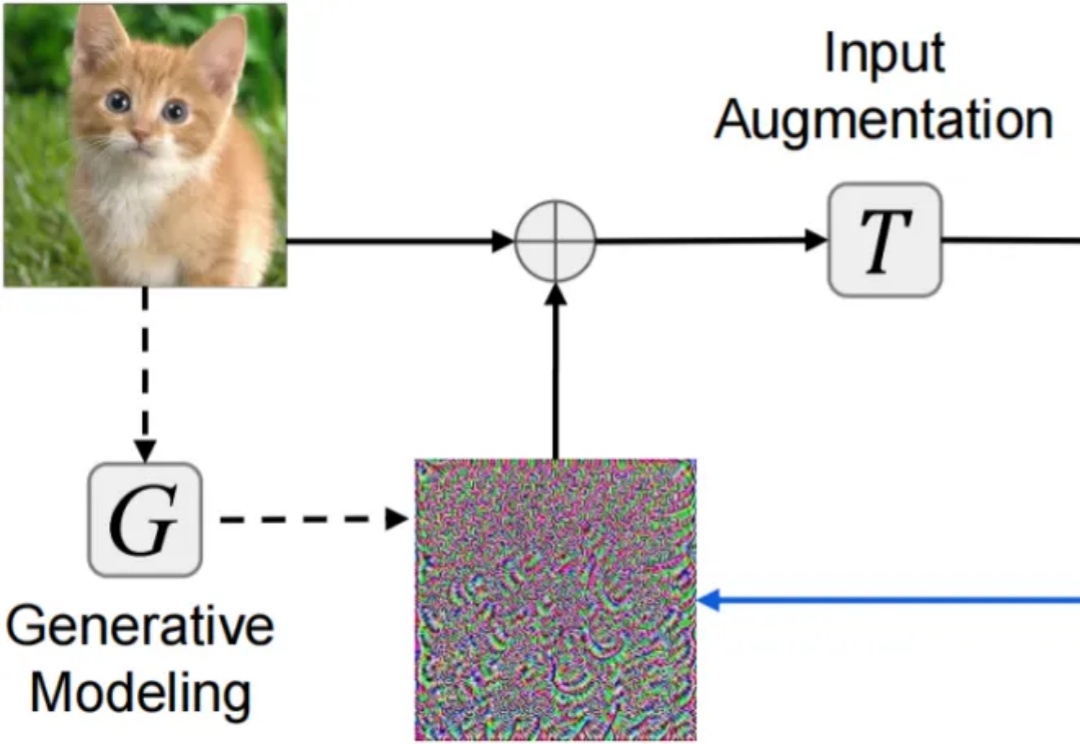
对抗样本(adversarial examples)的迁移性(transferability)—— 在某个模型上生成的对抗样本能够同样误导其他未知模型 —— 被认为是威胁现实黑盒深度学习系统安全的核心因素。尽管现有研究已提出复杂多样的迁移攻击方法,却仍缺乏系统且公平的方法对比分析:(1)针对攻击迁移性,未采用公平超参设置的同类攻击对比分析;(2)针对攻击隐蔽性,缺乏多样指标。