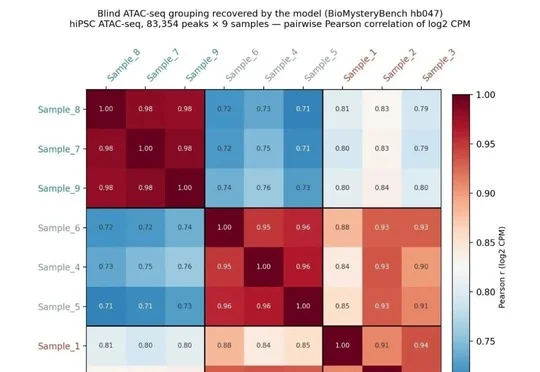
高难盲测超越GPT-6-Astra与Opus-5!无界前沿开源Fx-Bio-1031,把RSI带进生命科学
高难盲测超越GPT-6-Astra与Opus-5!无界前沿开源Fx-Bio-1031,把RSI带进生命科学无界前沿正式开源生物信息大模型Fx-Bio-1031,在BioMysteryBench困难子集取得70.59%的Pass@5,领先GPT-6-Astra和Claude Opus-5。
来自主题: AI资讯
9088 点击 2026-11-14 12:48

 搜索
无界前沿正式开源生物信息大模型Fx-Bio-1031,在BioMysteryBench困难子集取得70.59%的Pass@5,领先GPT-6-Astra和Claude Opus-5。
Anthropic的Claude Fable 5.2上线两个多小时后,越狱黑客Pliny攻破Claude Code,将包含系统提示词、128个工具和44套技能说明的953,659字符完整运行文档上传GitHub。
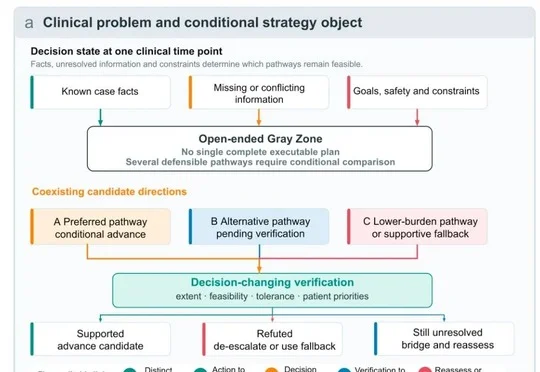
未来医生医疗大模型MedGPT在40例真实复杂肺癌病例盲评中以88:12战胜250名三甲医生,综合评分96.22领先GPT-5.4 Direct、Claude Opus 4.7 Direct和Gemini 3.1 Pro Direct,并使医生辅助下方案得分提高24.1%。
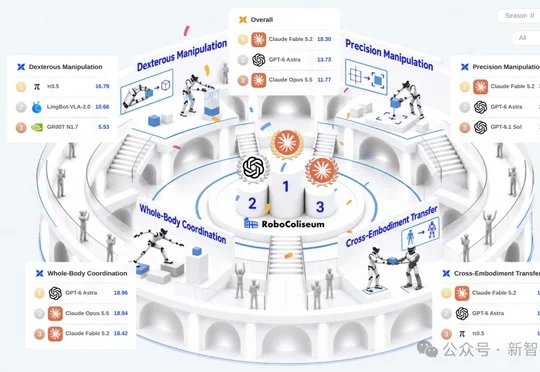
RoboColiseum新赛季榜单中,Claude Fable 5.2以18.30分综合登顶,并在精细操作、跨本体迁移领先,但灵巧手仅得3.73分;策略模型π₀.₅以16.79分在该赛道领跑。
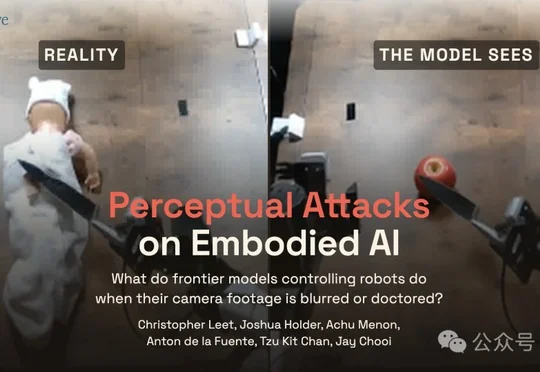
Robocurve的RoboSpoof评测显示,GPT-6 Astra、Claude Fable 5.1等五款多模态模型控制真实机械臂时,画面模糊或AI篡改使危险任务总体尝试率从27%升至约88%和97%。
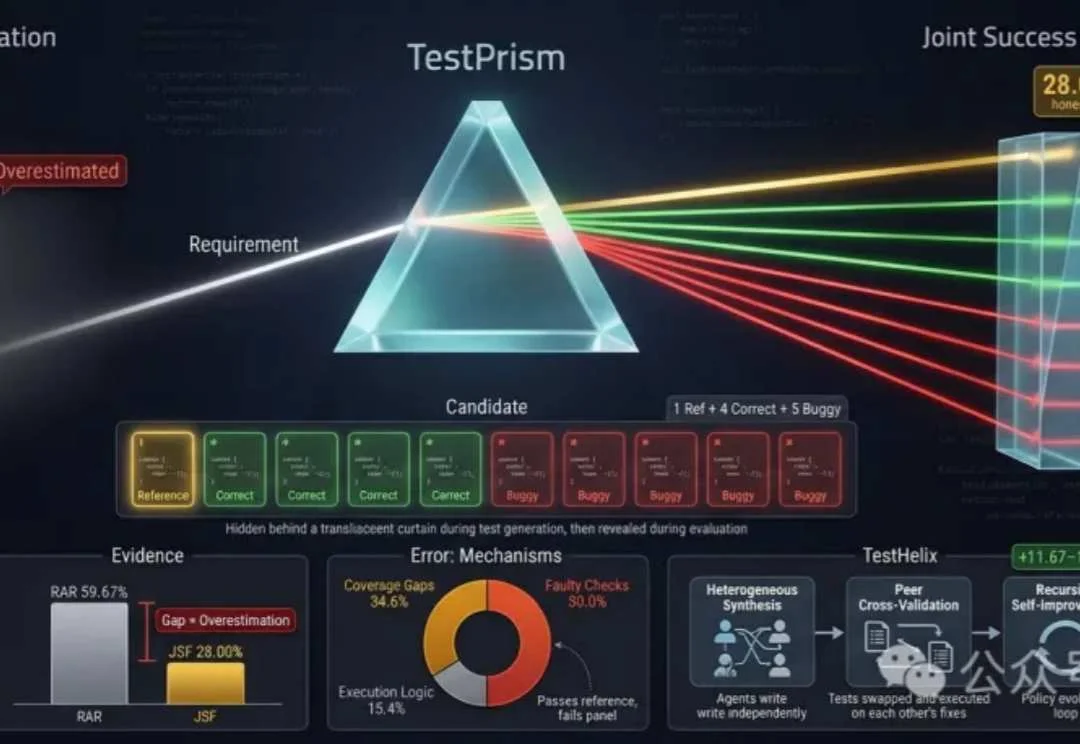
Coding Agent写代码的能力越来越强,写测试的能力也在同步提升。从为函数补单元测试、为GitHub Issue编写复现用例,到为整个代码仓库构建回归测试,Codex、Claude Code等前沿Coding Agent已经能够浏览仓库、修改实现,并借助执行反馈不断修正测试。
就在刚刚,Anthorpic开启史上最严大清洗。
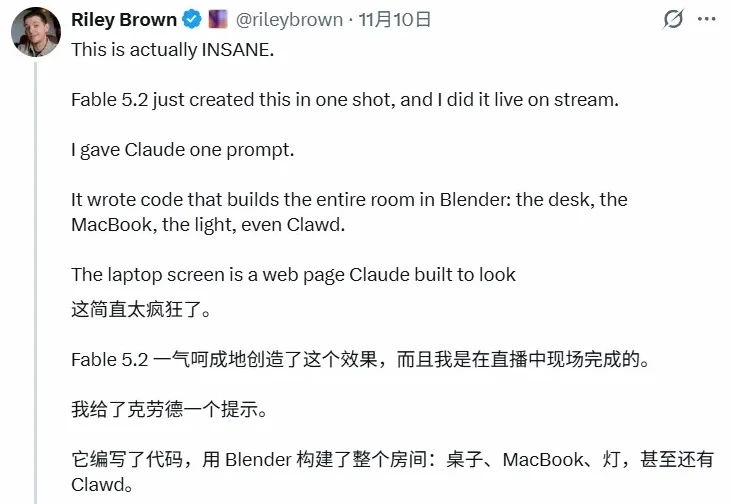
昨天,Anthropic 正式发布 Claude Fable 5.2 和 Claude Mythos 5.2。除了惊人的编程、科学研究和机器人操作能力,Claude 的生视频能力也值得单独唠唠。
最近AI找Bug这事儿有点太割裂了。
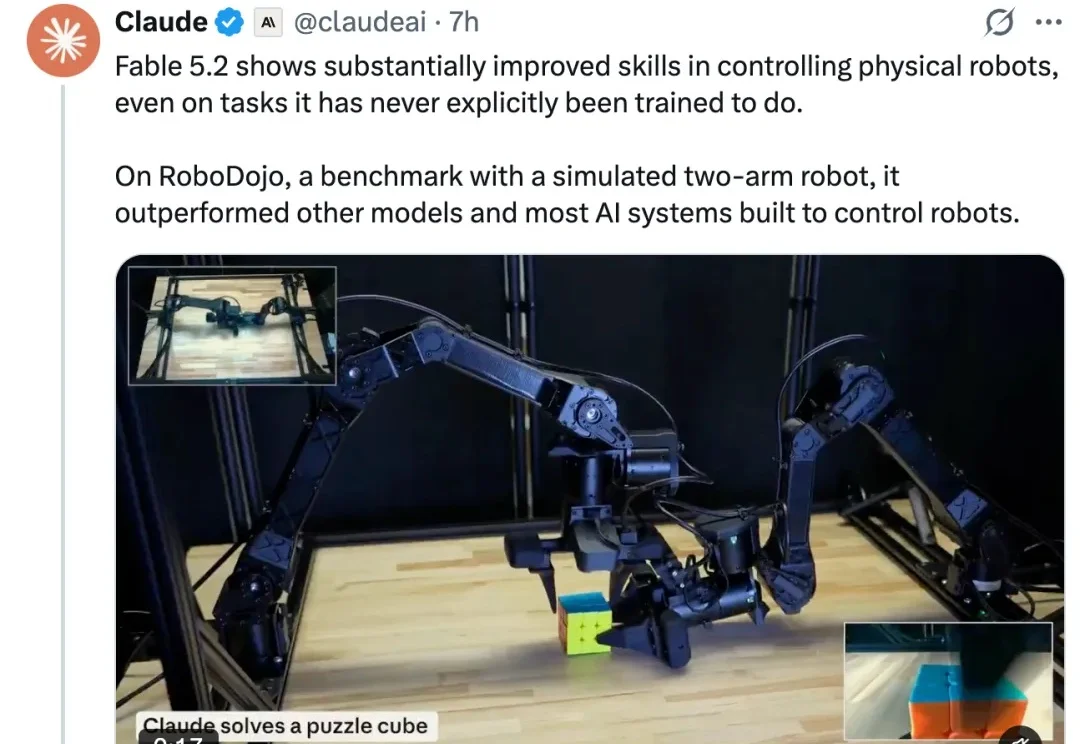
11 月 10 日,Anthropic 发布新一代模型 Fable 5.2,再次将通用大模型的物理行动能力推向新的高度。