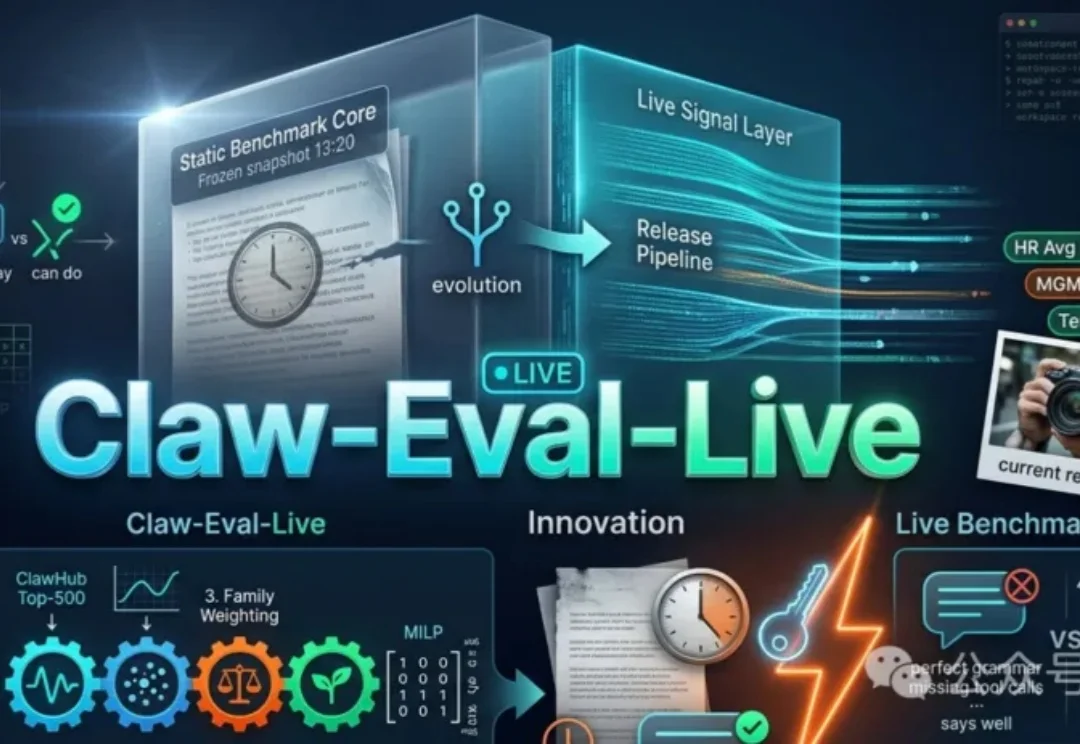
Agent评测的下半场:为什么需要一个「活的」Benchmark?
Agent评测的下半场:为什么需要一个「活的」Benchmark?Claw-Eval-Live提出「活的」benchmark概念,通过信号采集与任务筛选,确保评测内容紧跟企业实际痛点,而非固定不变的题库。评测不仅关注结果,还追踪执行过程,从数据调用到状态变更,全面验证Agent的真实能力。
来自主题: AI技术研报
7257 点击 2026-05-11 16:08

 搜索
Claw-Eval-Live提出「活的」benchmark概念,通过信号采集与任务筛选,确保评测内容紧跟企业实际痛点,而非固定不变的题库。评测不仅关注结果,还追踪执行过程,从数据调用到状态变更,全面验证Agent的真实能力。
北京脑回录科技有限公司(Nanoloop)宣布完成千万级种子 + 轮融资。本轮融资由南山战新投领投。此前,公司曾获得奇绩创坛种子轮投资。本轮资金将主要用于运动脑机接口核心技术迭代、Nuromova 智能运动头带工程化量产、真实运动场景脑电数据资产建设及国内外市场拓展。
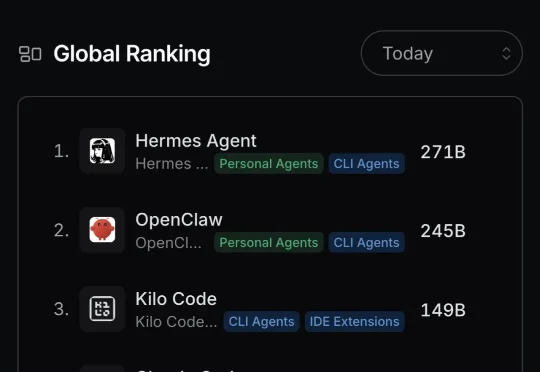
5月9日,Hermes Agent(昵称:爱马仕)登顶OpenRouter全球应用调用量榜首,首次超越OpenClaw(昵称:龙虾)。据OpenRouter应用Token消耗榜最新数据,这一Nous Research旗下开源自进化Agent产品登顶全球应用Token消耗榜,单日Token消耗量达到271B,也就是2710亿Token。
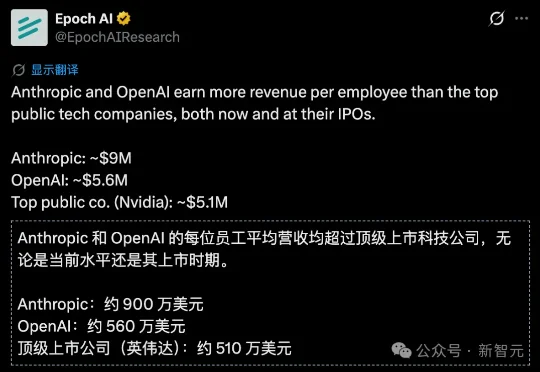
Epoch AI最新数据:Anthropic人均年营收900万美元,远超OpenAI的560万和英伟达的510万。一家没上市的AI公司,人效已刷新硅谷全部历史纪录。
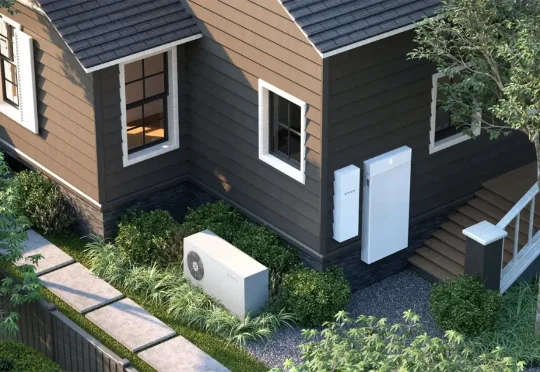
Span 2018 年起家时做的是智能电板,卖给业主帮他们省电费。它的电板能识别每户人家电网接入端的实际可用容量。美国住宅一般标配 200 安培的服务等级,日常负载远低于此。空出来的那部分电力过去没被任何人定价,Span 现在打算把它用来跑 AI 推理。
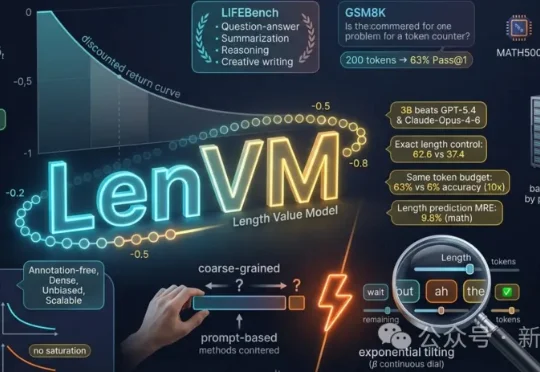
LenVM将长度建模提升到token级别,开辟可扩展价值预训练的新维度——3B开源模型精确长度控制全面击败GPT-5.4、Claude-Opus-4-6等顶级闭源模型;相同token预算下推理准确率提升10倍(63% vs 6%);沿模型规模、数据量、采样数三轴无饱和scaling的value pretraining
旅游是个矛盾的行业。据 WTTC 数据,2024 年全球旅游业贡献 10.9 万亿美元,接近全球 GDP 的 10%,每 10 个工作岗位就有 1 个与之相关。可就是这样一个体量的行业,二十年却没长出过一家真正的旅游公司。

同样是 AI 陪伴,放到不同市场,用户消费的到底是什么?
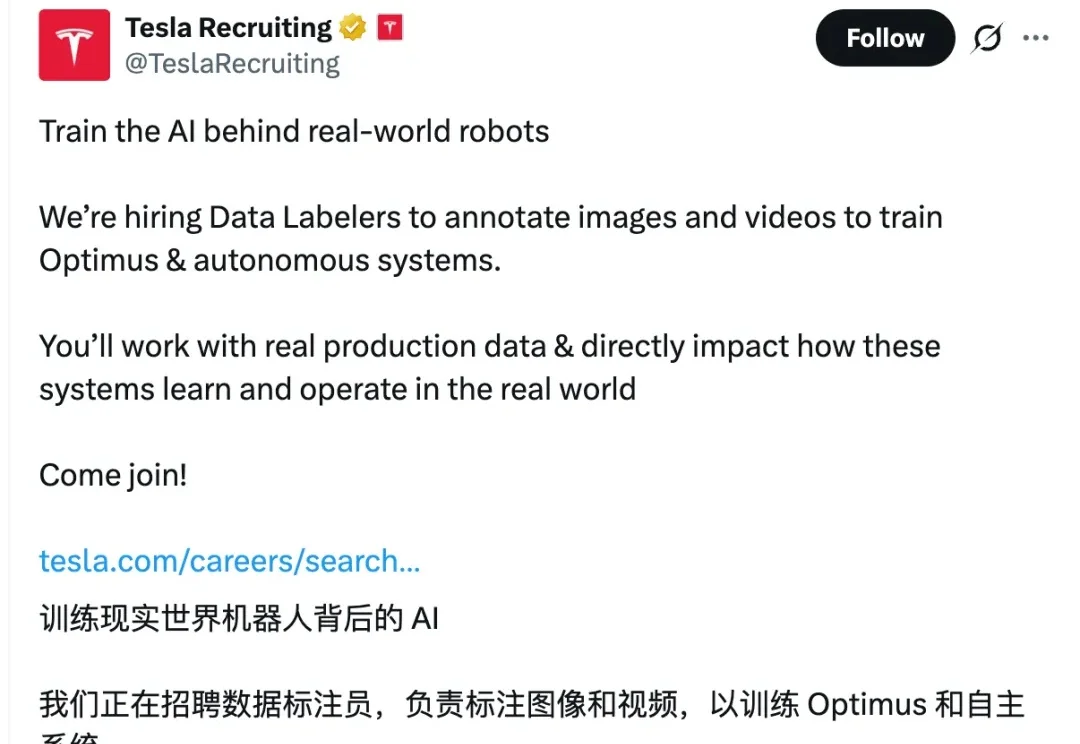
急招数据标注员!
当地时间 5 月 5 日,迈阿密一家名为 Subquadratic 的公司走出隐身模式。CTO Alexander Whedon 在 X 上把首款模型 SubQ 称作“a major breakthrough in LLM intelligence”(LLM 智能领域的重大突破),