天大、南大发布LPSNet:无透镜成像下的人体三维姿态与形状估计 | CVPR 2024
天大、南大发布LPSNet:无透镜成像下的人体三维姿态与形状估计 | CVPR 2024天津大学与南京大学联合团队在CVPR 2024上发表了LPSNet项目,提出了一种端到端的无透镜成像下的3D人体姿态和形状估计框架,通过多尺度无透镜特征解码器和双头辅助监督机制,直接从编码后的无透镜成像数据中提取特征并提高姿态估计的准确度。
搜索
天津大学与南京大学联合团队在CVPR 2024上发表了LPSNet项目,提出了一种端到端的无透镜成像下的3D人体姿态和形状估计框架,通过多尺度无透镜特征解码器和双头辅助监督机制,直接从编码后的无透镜成像数据中提取特征并提高姿态估计的准确度。
抄袭框架和预训练数据的情况,是更狭义的套壳。
就算是 OpenAI 在舆论场也无法逃过版权保护的呼声。
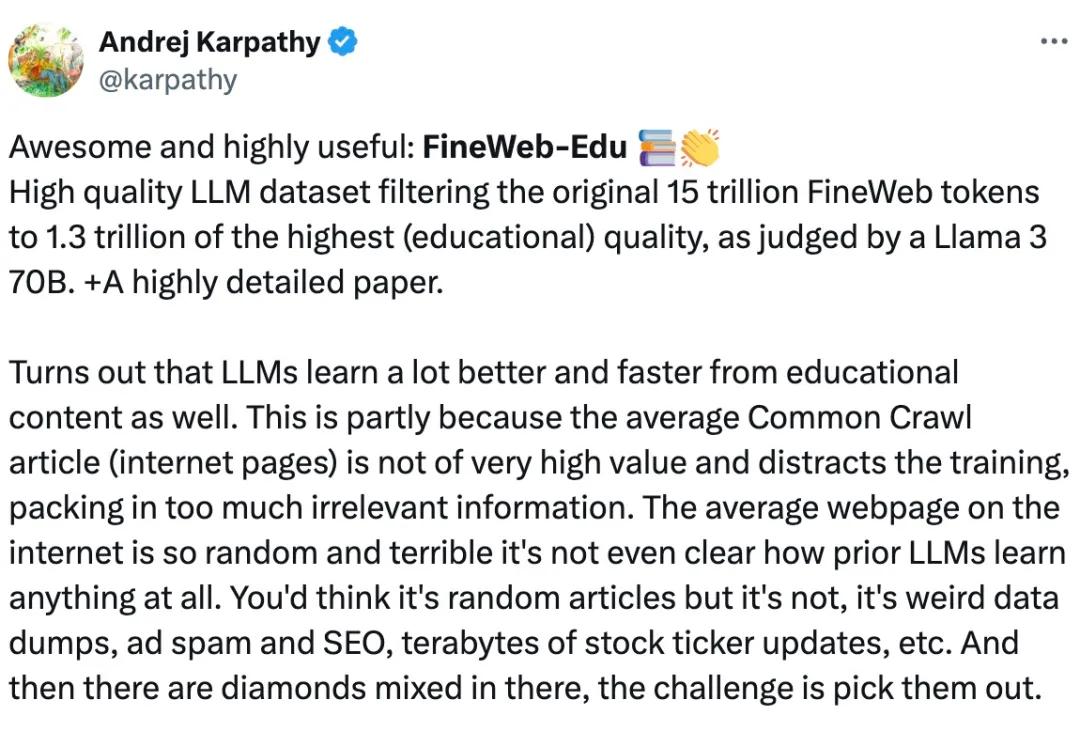
众所周知,对于 Llama3、GPT-4 或 Mixtral 等高性能大语言模型来说,构建高质量的网络规模数据集是非常重要的。然而,即使是最先进的开源 LLM 的预训练数据集也不公开,人们对其创建过程知之甚少。
华南理工大学和香港大学的研究人员在ICML 2024上提出了一个简单而通用的时空提示调整框架FlashST,通过轻量级的时空提示网络和分布映射机制,使预训练模型能够适应不同的下游数据集特征,显著提高了模型在多种交通预测场景中的泛化能力。
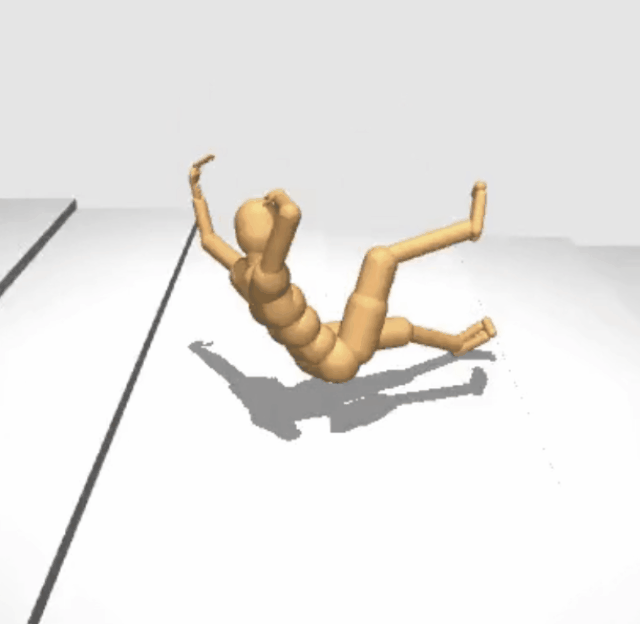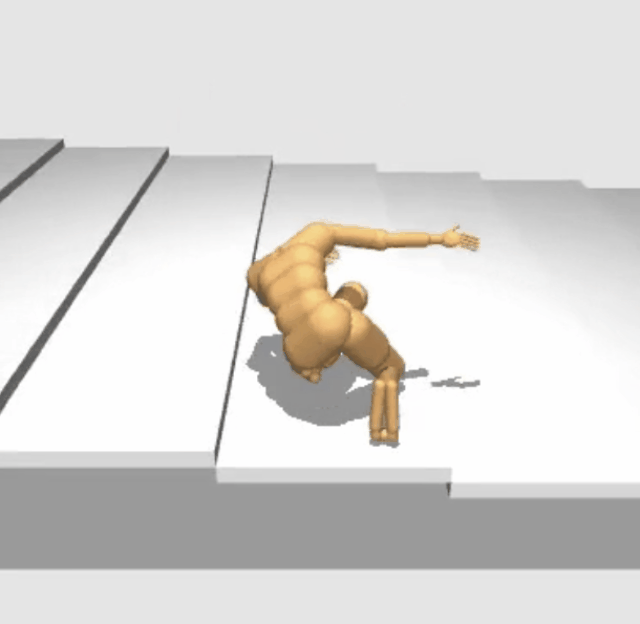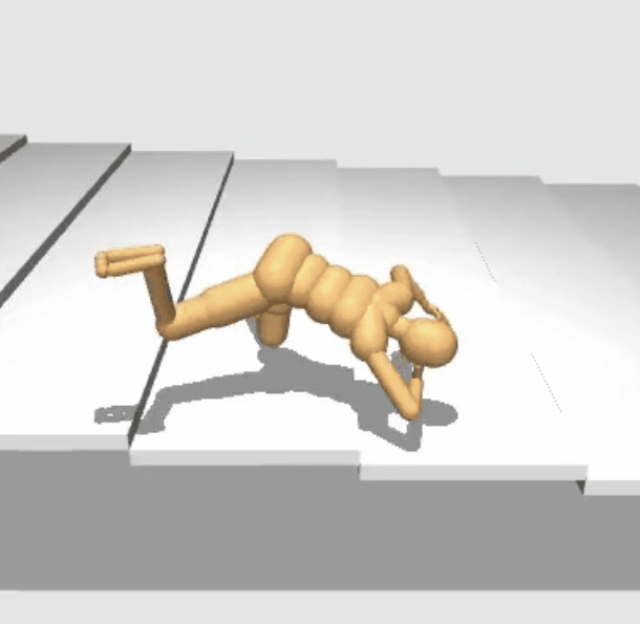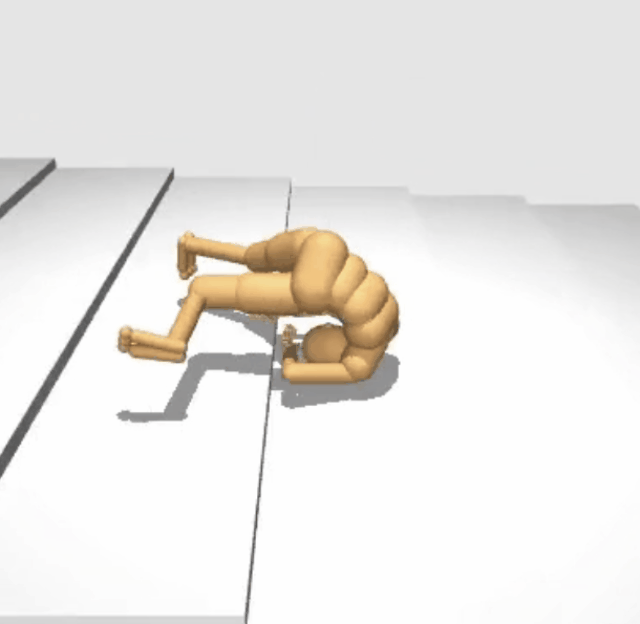
在复杂的物理世界中,人型机器人的全身控制一直是个难题,现有的强化学习做出的效果有时会比较抽象。近日,LeCun参与的一项工作给出了基于数据驱动的全新解决方案。
一般而言,训练神经网络耗费的计算量越大,其性能就越好。在扩大计算规模时,必须要做个决定:是增多模型参数量还是提升数据集大小 —— 必须在固定的计算预算下权衡此两项因素。
Scaling law发展到最后,可能每个人都站在一个数据孤岛上。
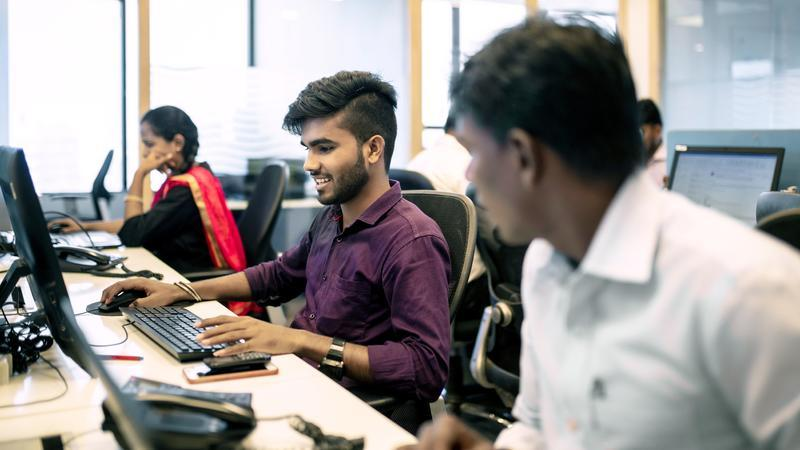
本文介绍了印度农村和小城镇成为AI数据标注中心的现状,以及数据标注师在AI产业中的重要性和挑战。数据标注公司在印度纷纷诞生,市场需求增长迅速。农村和小城镇超过80%的数据标注员来自印度,为AI产业注入新活力
John Schulman 是 OpenAI 联合创始人、研究科学家(OpenAI 现存最主要具有技术背景的创始人),他领导了 ChatGPT 项目,在 OpenAI 内部长期负责模型 post-traning,在 Ilya 和 Jan Leike 离开 OpenAI 后,下一代模型安全性风险相关的研究也会由 John Schulman 来接替负责。