AI内存新秀,SOCAMM2登场
AI内存新秀,SOCAMM2登场据报道,英伟达已取消其第一代SOCAMM内存模块的推广,并将开发重点转向名为SOCAMM2的新版本。不久前,英伟达曾表示计划今年为其AI产品部署60-80万个SOCAMM内存模块,但据称随后发现了技术问题,项目两次搁置,并未能下达任何实际的大规模订单。目前开发重点已经转移到SOCAMM 2,英伟达已开始与三星电子、SK海力士和美光合作对SOCAMM 2进行样品测试。
搜索
据报道,英伟达已取消其第一代SOCAMM内存模块的推广,并将开发重点转向名为SOCAMM2的新版本。不久前,英伟达曾表示计划今年为其AI产品部署60-80万个SOCAMM内存模块,但据称随后发现了技术问题,项目两次搁置,并未能下达任何实际的大规模订单。目前开发重点已经转移到SOCAMM 2,英伟达已开始与三星电子、SK海力士和美光合作对SOCAMM 2进行样品测试。
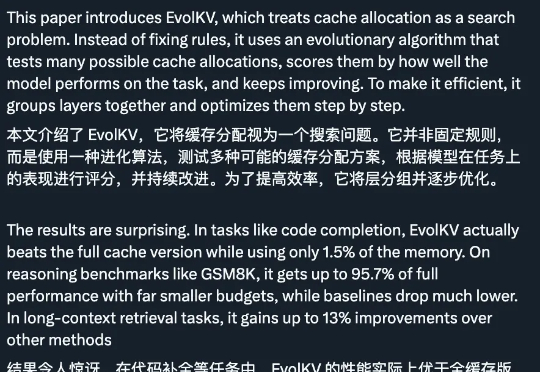
只用 1.5% 的内存预算,性能就能超越使用完整 KV cache 的模型,这意味着大语言模型的推理成本可以大幅降低。EvolKV 的这一突破为实际部署中的内存优化提供了全新思路。
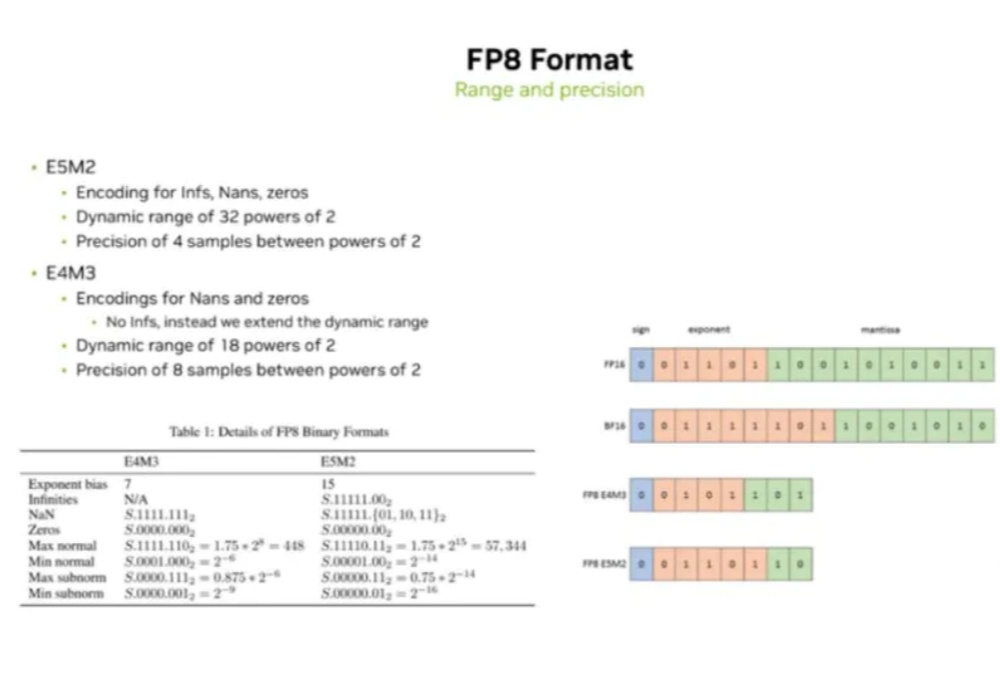
当前AI大模型(LLM)训练与推理对算力的巨大需求,以及传统计算精度(如FP16/BF16)面临的功耗、内存带宽和计算效率瓶颈。
不使用端侧AI的话,谷歌在Pixel 10上就有虚假宣传的嫌疑了。
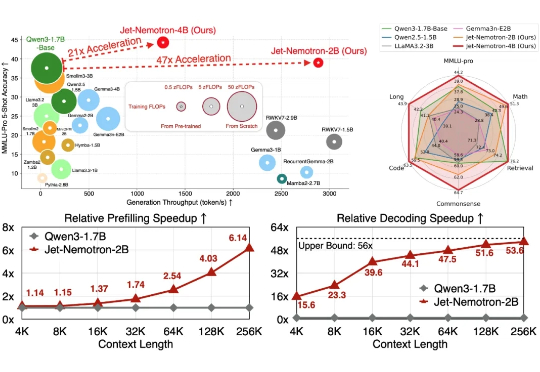
Transformer 架构对计算和内存的巨大需求使得大模型效率的提升成为一大难题。为应对这一挑战,研究者们投入了大量精力来设计更高效的 LM 架构。
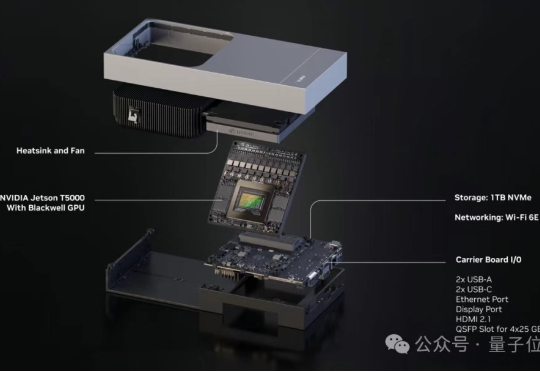
英伟达直接把服务器级别的算力塞进了机器人体内。 全新的机器人计算平台Jetson Thor正式发售,基于最新的Blackwell GPU架构,AI算力直接飙升到2070 TFLOPS,比上一代Jetson Orin提高至整整7.5倍,同时能效提高至3.5倍。
大模型“世子之争”,果然暗潮汹涌(doge)。 这不“手机内存不够”怎么办,如果你问问DeepSeek老师:你和豆包删一个你删谁?
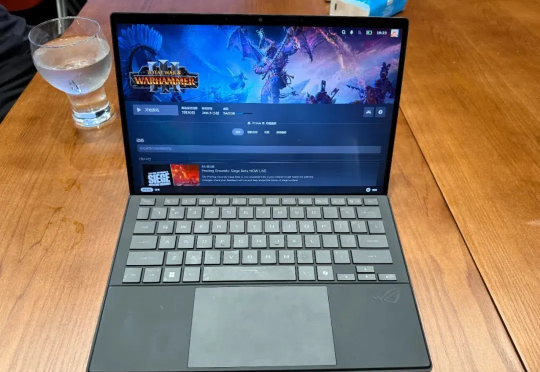
今天 ,OpenAI 开源了俩模型:120B/20B 117B 的 gpt-oss-120b 对标 o4-min,按官方说法至少需要 80G 内存,推荐使用单卡 H100 GPU 而刚买的的游戏本,刚好满足gpt-oss-120b 的部署条件
近日,一位开发者在 GitHub 上公开警告称,字节跳动旗下 AI 编程环境 Trae IDE 存在在用户未明确知情的情况下,将数据上传至字节服务器的行为,即便用户已在设置中手动关闭遥测(Telemetry)功能。
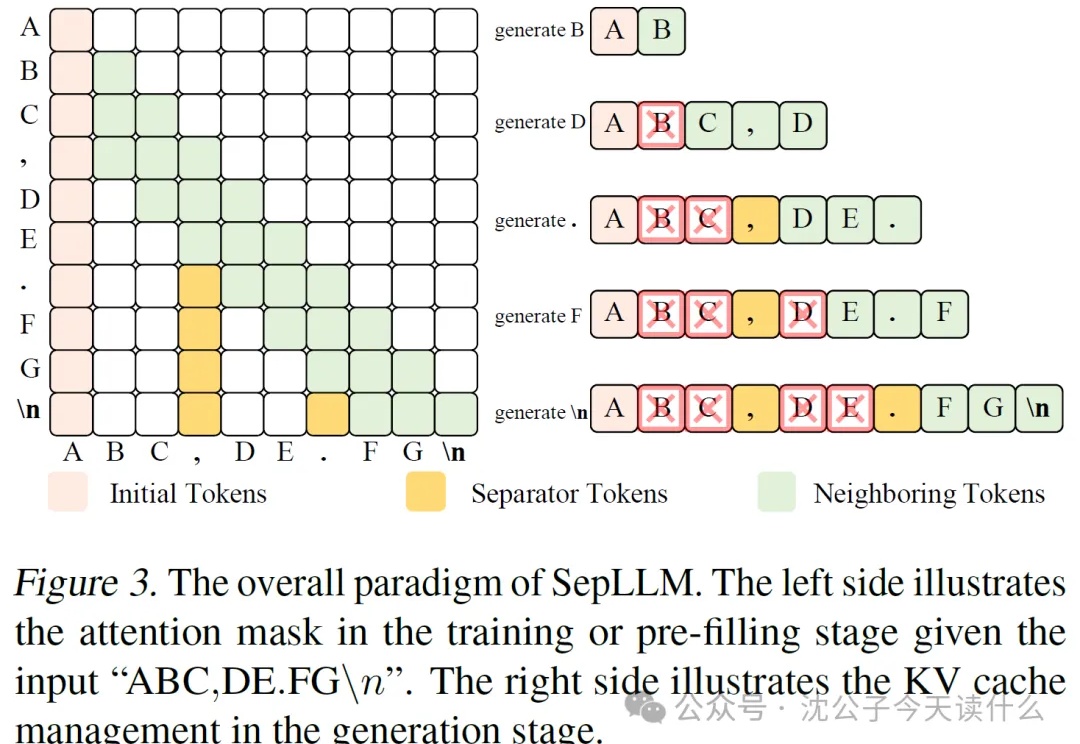
近年来,大语言模型(LLM)的能力越来越强,但它们的“饭量”也越来越大。这个“饭量”主要体现在计算和内存上。当模型处理的文本越来越长时,一个叫做“自注意力(Self-Attention)”的核心机制会导致计算量呈平方级增长。这就像一个房间里的人开会,如果每个人都要和在场的其他所有人单独聊一遍,那么随着人数增加,总的对话次数会爆炸式增长。