对比AI检索巨头,刨析AI全球局势,一个新出的AI种子如何嵌入到上升为AI资本企业
对比AI检索巨头,刨析AI全球局势,一个新出的AI种子如何嵌入到上升为AI资本企业昨晚睡不着,我把四份最新AI纪要摊床上,越看越像四盘菜:Kimi那盘是精算师凉面,DeepSeek端上战略家佛跳墙,ChatGPT递来脱口秀炸酱面,Gemini则摆好外交官寿司。
来自主题: AI资讯
9749 点击 2025-08-21 10:09

 搜索
昨晚睡不着,我把四份最新AI纪要摊床上,越看越像四盘菜:Kimi那盘是精算师凉面,DeepSeek端上战略家佛跳墙,ChatGPT递来脱口秀炸酱面,Gemini则摆好外交官寿司。
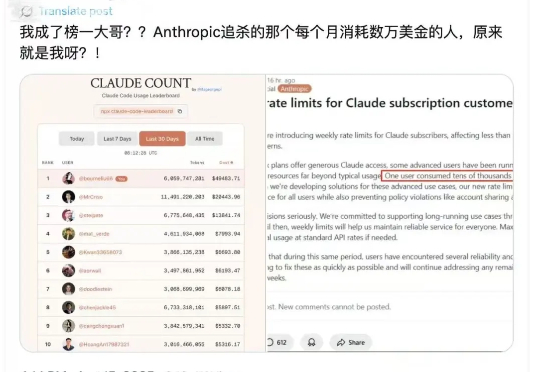
众所周知,前不久 Anthropic 宣布对用户实行每周速率限制。其中,在解释原因时,Anthropic 提到“虽然 Pro 和 Max 套餐提供了充足的 Claude 访问权限,但一些高级用户却全天候不间断地运行 Claude,消耗的资源远远超出了正常使用量。一位用户在 200 美元的套餐中消耗了数万个模型使用量。”
大模型与多模态之间的关系,可以理解为大模型就像是人脑中的‘前额叶’,主要负责高级认知功能,但只有前额叶的大脑是无法处理复杂任务的,这就需要多个不同模型之间互相协调,从单纯的“前额叶”走向“完整的大脑”,从而处理更加复杂的现实任务。
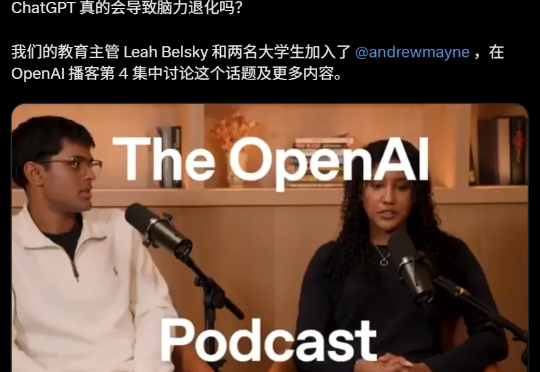
想象一个课堂:讲台上是永不疲倦的AI讲师,台下是专注于启发和引导的人类导师。本期播客,听听他们关于AI如何重塑教育、老师角色以及适应力为何是新一代职业保障的深刻洞见。
美国每年有超三分之一患者需跨机构转诊,但复杂行政流程导致转诊完成率不足一半。Tennr以AI为底座切入这一高摩擦、高错误率的关键节点,重构信息交互与操作流程,为医疗机构与患者带来更高效、更可控的转诊体验。
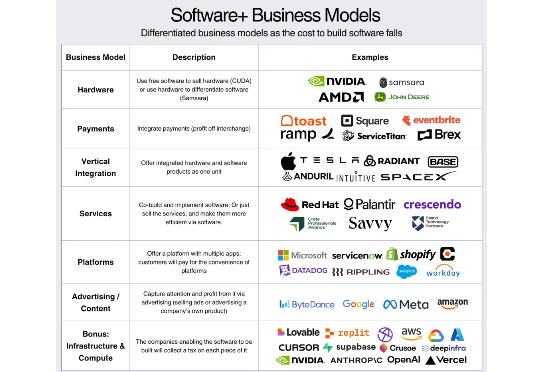
当我看到 Cursor、Claude Code、Lovable 这些 AI 编程工具的出现,以及它们正在以惊人的速度降低软件开发成本时,我意识到我们正站在一个历史转折点上。这不仅仅是开发效率的提升,而是整个软件行业商业逻辑的根本性重构。
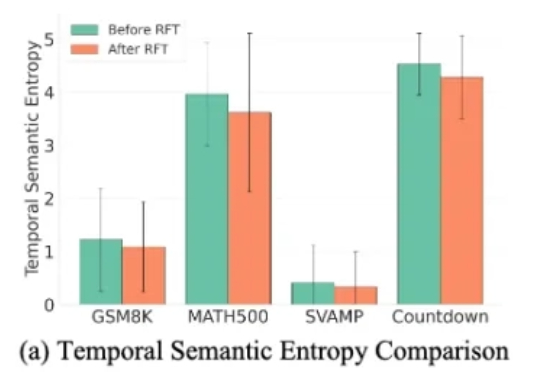
近年来,扩散大语言模型(Diffusion Large Language Models, dLLMs)正迅速崭露头角,成为文本生成领域的一股新势力。与传统自回归(Autoregressive, AR)模型从左到右逐字生成不同,dLLM 依托迭代去噪的生成机制,不仅能够一次性生成多个 token,还能在对话、推理、创作等任务中展现出独特的优势。
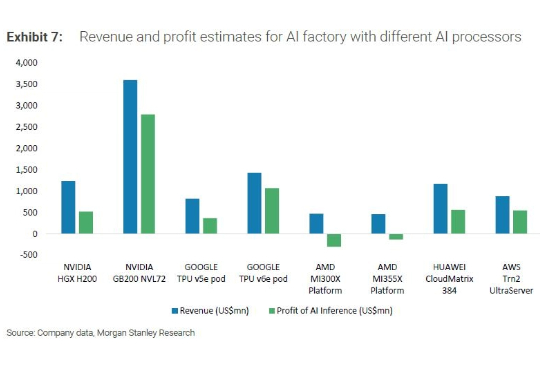
英伟达封王,谷歌、亚马逊、华为“稳赚不赔”,AMD意外亏损。AI推理,是一门利润惊人的生意。
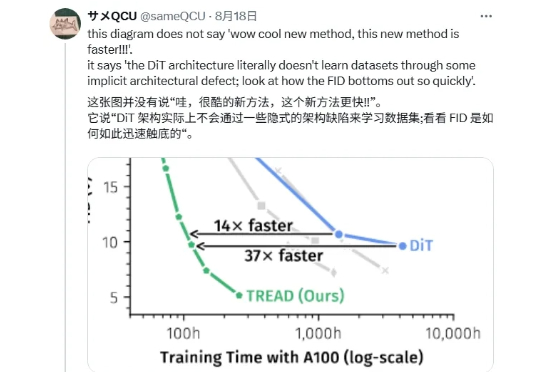
「兄弟们,DiT 是错的!」 最近一篇帖子在 X 上引发了很大的讨论,有博主表示 DiT 存在架构上的缺陷,并附上一张论文截图。
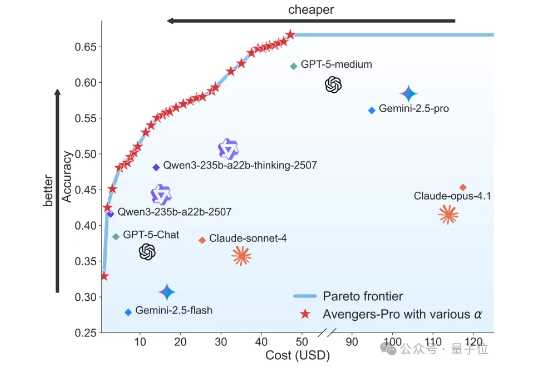
虽然大模型的优越表现令人瞩目,但动辄高昂的使用成本也让不少用户望而却步。 为平衡性能与成本,上海人工智能实验室科研团队基于前期技术积累,开源推出了Avengers-Pro多模型调度路由方案。