10分钟搞定Excel世锦赛难题!首个超越人类Excel Agent,网友:想给它磕一个
10分钟搞定Excel世锦赛难题!首个超越人类Excel Agent,网友:想给它磕一个这个AI让打工人「磕头」致谢。 前段时间,我们报道了 5 款大模型参加了今年山东高考的事儿,为了弄清楚各大模型在 9 个科目中的具体表现,我们对着测评明细表挨个儿分析,搞得狼狈又崩溃。要是哪个 AI 能一键分析表格,我当场就能给它磕一个。
搜索
这个AI让打工人「磕头」致谢。 前段时间,我们报道了 5 款大模型参加了今年山东高考的事儿,为了弄清楚各大模型在 9 个科目中的具体表现,我们对着测评明细表挨个儿分析,搞得狼狈又崩溃。要是哪个 AI 能一键分析表格,我当场就能给它磕一个。
7月2日,韩国专注于AI癌症诊断和治疗的企业Lunit宣布与Microsoft达成合作,加速提供人工智能驱动的医疗保健解决方案。
AI 社交,尤其是 AI 角色扮演方向,最近势头不太好,产品停止投入、流量下降等消息不少。但另一个细分方向,一直处于边缘位置的 AI 陪伴产品,在有点颓的市场环境中,正在默默发力。
2025年,AI界风云激荡,DeepSeek-R1横空出世、英伟达市值称霸全球、谷歌AlphaEvolve打破数学神话,中国Qwen3登顶开源王座……智能爆炸的奇点已悄然降临!新智元十周年之际,2025 AI Era & ASI创新大奖报名正式启动,致敬重塑世界的AI先锋!
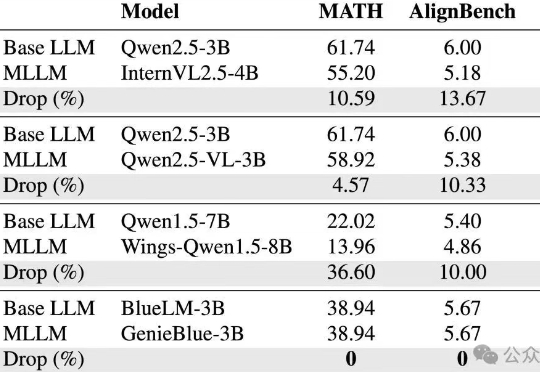
vivo AI研究院联合港中文以及上交团队为了攻克这些难题,从训练数据和模型结构两方面,系统性地分析了如何在MLLM训练中维持纯语言能力,并基于此提出了GenieBlue——专为移动端手机NPU设计的高效MLLM结构方案。
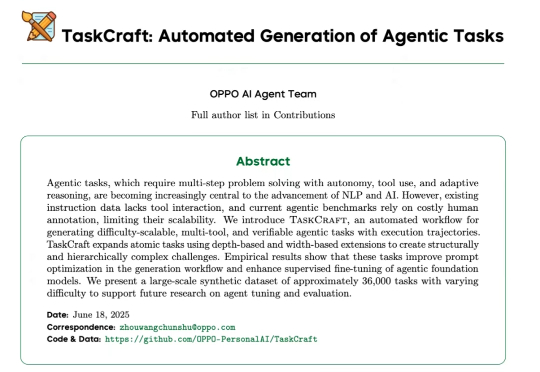
近年来,基于智能体的强化学习(Agent + RL)与智能体优化(Agent Optimization)在学术界引发了广泛关注。然而,实现具备工具调用能力的端到端智能体训练,首要瓶颈在于高质量任务数据的极度稀缺。
从「与GPT-3.5畅聊」到「ChatGPT」,OpenAI团队如何在混乱中拍板上线、又怎样被用户「点赞」调教成「赛博舔狗」?从产品发布、命名内幕、团队文化到AI时代核心竞争力,深度访谈揭开幕后全过程!
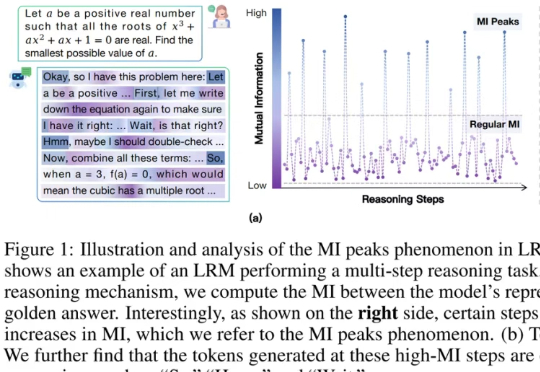
你肯定见过大模型在解题时「装模作样」地输出:「Hmm…」、「Wait, let me think」、「Therefore…」这些看似「人类化」的思考词。
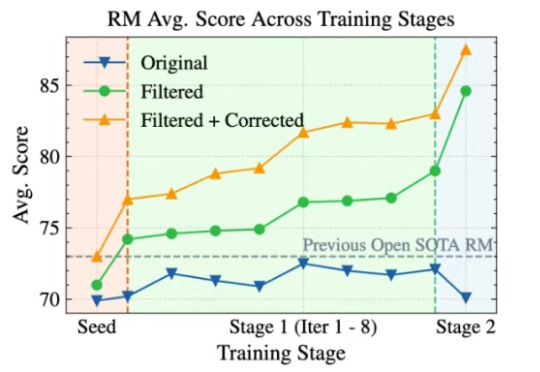
大语言模型(LLM)以生成能力强而著称,但如何能让它「听话」,是一门很深的学问。 基于人类反馈的强化学习(RLHF)就是用来解决这个问题的,其中的奖励模型 (Reward Model, RM)扮演着重要的裁判作用,它专门负责给 LLM 生成的内容打分,告诉模型什么是好,什么是不好,可以保证大模型的「三观」正确。
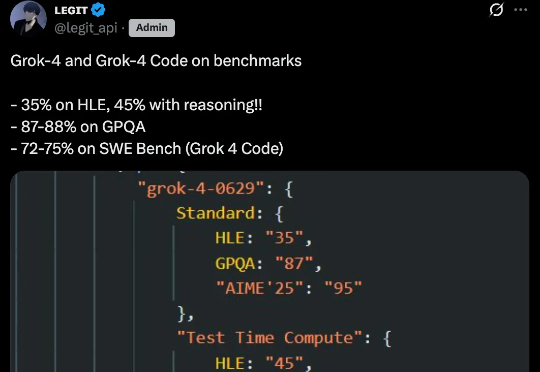
刚刚,Grok 4 和 Grok 4 Code 的基准测试结果疑似泄露。X 博主 @legit_api 发帖称,Grok 4 在 HLE(Humanities Last Exam,人类最后考试)上的标准得分是 35%,使用推理技术后提高到 45%;在 GPQA 上的得分是 87-88%;而Grok 4 Code 在 SWE Bench 上的得分则达到 72-75%。