大模型训练新突破!“不对称”训练让AI学会自我反思,推理零开销
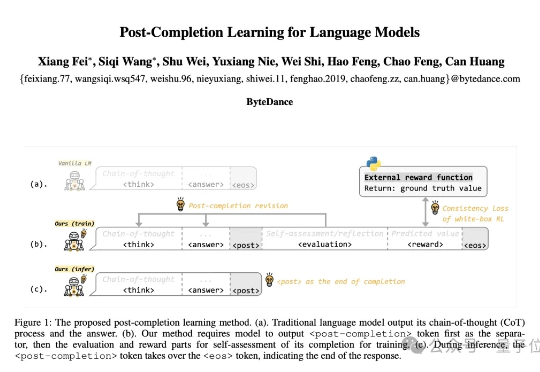
大模型训练新突破!“不对称”训练让AI学会自我反思,推理零开销首次实现“训练-推理不对称”,字节团队提出全新的语言模型训练方法:Post-Completion Learning (PCL)。 在训练时让模型对自己的输出结果进行反思和评估,推理时却仅输出答案,将反思能力完全内化。
来自主题: AI资讯
8563 点击 2025-08-13 16:10

 搜索
首次实现“训练-推理不对称”,字节团队提出全新的语言模型训练方法:Post-Completion Learning (PCL)。 在训练时让模型对自己的输出结果进行反思和评估,推理时却仅输出答案,将反思能力完全内化。
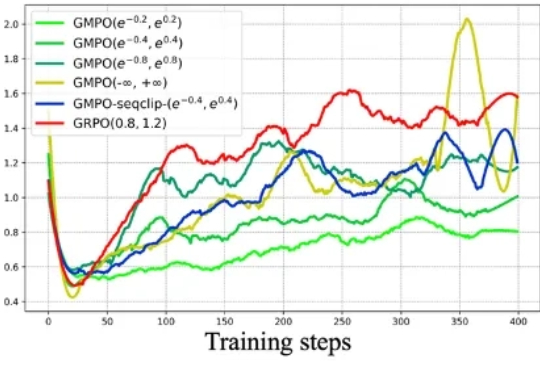
近年来,强化学习(RL)在大型语言模型(LLM)的微调过程中,尤其是在推理能力提升方面,取得了显著的成效。传统的强化学习方法,如近端策略优化(Proximal Policy Optimization,PPO)及其变种,包括组相对策略优化(Group Relative Policy Optimization,GRPO),在处理复杂推理任务时表现出了强大的潜力。
Artificial Analysis 最近发布了《State of AI: China Q2 2025 Highlights Report》(2025年Q2 中国人工智能现状分析报告),聚焦中国 AI 发展现状。
危险!ChatGPT存在“零点击攻击”安全问题。 用户无需点击,攻击者也能从ChatGPT连接的第三方应用窃取敏感数据,甚至窃取API密钥。

一场创业公司对大厂产品的反向收购,罕见地发生在了AI搜索战场。 2025年8月12日,据“华尔街日报”消息,美国AI搜索领域的“顶流”初创公司Perplexity,正在计划全现金收购谷歌的Chrome浏览器,报价高达345亿美元。
虚拟细胞(AIVC),被誉为生物学的圣杯之一。 设想一下,如果能在临床前阶段使用AI较为准确的模拟新药在细胞内的反应,临床阶段所面临的问题将会显著减少。
总部位于首尔的 Datumo 最初是一家 AI 数据标注公司,如今致力于通过提供工具和数据来帮助企业构建更安全的 AI 系统。
GPT-5是一次 ChatGPT 产品的重要升级。Routing 能力的加入帮助 ChatGPT 模型第一次把产品线捋顺统一,是 UX 交互的一次重要革新。就像 Apple 决定只推出一款 iPhone 产品线,短期用户可能被迫适应 GPT-5 这个旗舰产品的优缺点,但长期更容易占领用户心智。
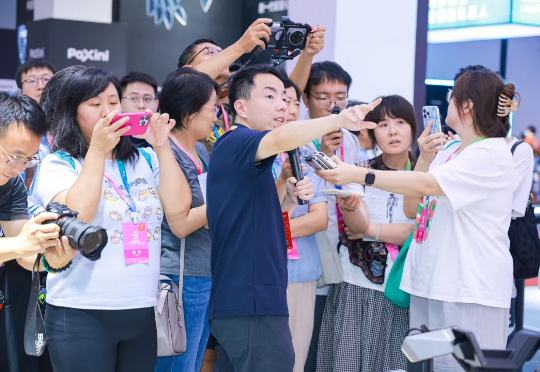
人头攒动的2025WRC(世界机器人大会)上,不乏各种酷炫的Demo展示,可在一众敲锣打鼓的机器人表演中,具身智能公司星海图展位上,机器人却在安静地执行铺床任务。
穿着运动鞋的鲨鱼踩着滑板冲浪,头顶卡布奇诺泡沫的芭蕾舞者在水晶球里旋转——这些被称为“脑残视频”(Brainrot Videos)的荒诞内容正在TikTok和Instagram上病毒式传播,年轻用户群体疯狂追捧这些脱离现实逻辑的视觉梗图,单条播放量动辄突破千万。