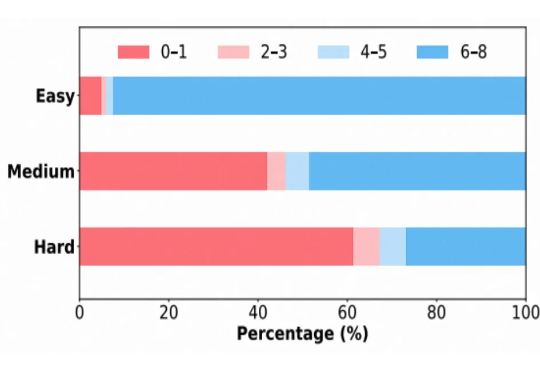
从繁杂技巧到极简方案:ROLL团队带来RL4LLM新实践
从繁杂技巧到极简方案:ROLL团队带来RL4LLM新实践近年来,强化学习(Reinforcement Learning, RL)在提升大语言模型(LLM)复杂推理能力方面展现出显著效果,广泛应用于数学解题、代码生成等任务。通过 RL 微调的模型常在推理性能上超越仅依赖监督微调或预训练的模型。
来自主题: AI技术研报
8962 点击 2025-08-22 16:35

 搜索
近年来,强化学习(Reinforcement Learning, RL)在提升大语言模型(LLM)复杂推理能力方面展现出显著效果,广泛应用于数学解题、代码生成等任务。通过 RL 微调的模型常在推理性能上超越仅依赖监督微调或预训练的模型。
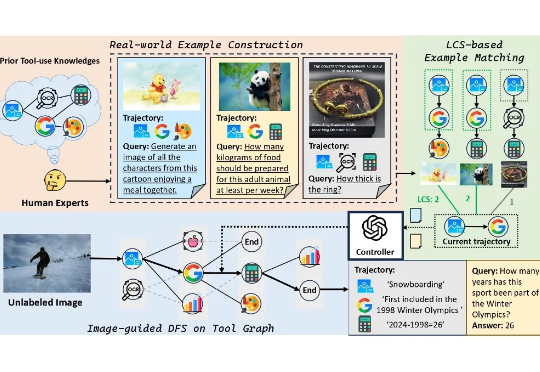
本文提出了一个旨在提升基础模型工具使用能力的大型多模态数据集 ——ToolVQA。现有研究已在工具增强的视觉问答(VQA)任务中展现出较强性能,但在真实世界中,多模态任务往往涉及多步骤推理与功能多样的工具使用,现有模型在此方面仍存在显著差距。

据知情人士透露,Anthropic 即将达成协议,在新一轮融资中筹集高达 100 亿美元资金,这一金额超出预期,成为人工智能初创企业迄今规模最大的超级融资轮之一。

一生充满传奇经历的AI先驱Warren Brodey逝世,享年101岁。这位精神病学家出身的思想家,早在AI曙光初露时,便在MIT探索技术解放人类潜能的道路。他在复杂系统和响应式技术方面所做的开拓性工作,为AI等领域的发展奠定了基础。

知情人士透露,作为人工智能热潮中关键基础设施供应商的 Crusoe 能源系统公司,正计划以近 100 亿美元的估值进行新一轮融资。这笔交易将突显支撑 AI 系统运作所需的庞大资源。
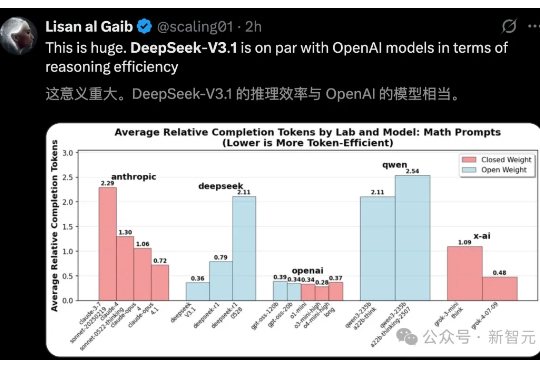
DeepSeek-V3.1官宣了,作为首款「混合推理」模型,将开启智能体新时代。新模型共有671B参数,编码实力碾压DeepSeek-R1、Claude 4 Opus,登顶编程开源第一。

当一家创业公司,决定比OpenAI更快推出一款AI硬件,“快”,是他们在这场九死一生的创业游戏中,最大的砝码。 8月19日上午,在海淀区北四环的一座大厦里,我们见到了「光智时空Looki」创始人孙洋。
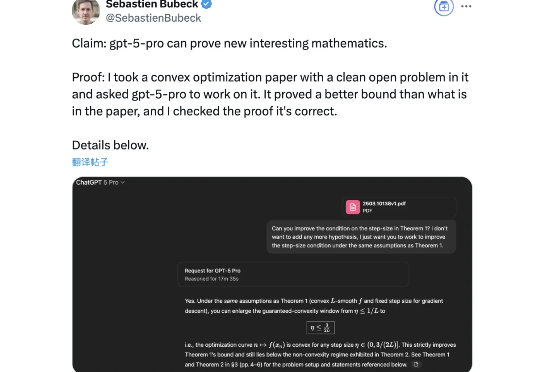
AI已经能够自主思考并证明新的数学规律了? OpenAI研究人员表示,自己喂给GPT-5 Pro一篇论文,结果模型读完之后得到了新的结论。
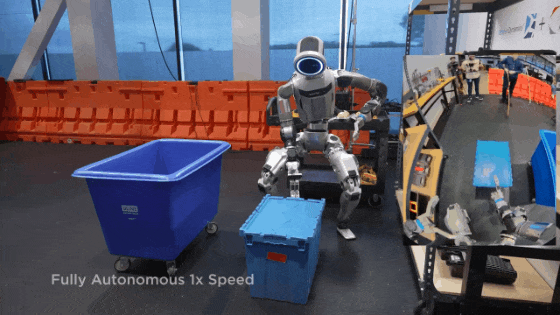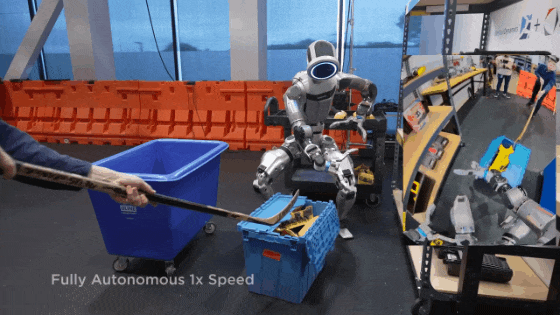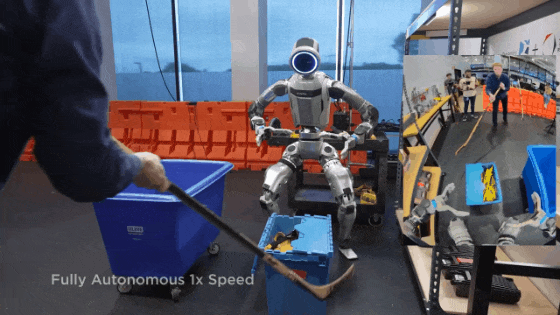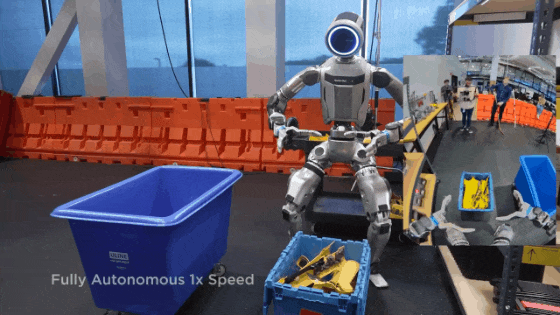
Atlas进厂打工技能再进化!波士顿动力联手丰田研究院,首次让人形机器人Atlas能够通过语言指令驱动,一次性处理从折叠配件到整理仓架的复杂作业。这种LBM(Large Behavior Models,大行为模型)方法让机器人具备跨任务泛化能力,迈出了工业化实践的一大步。
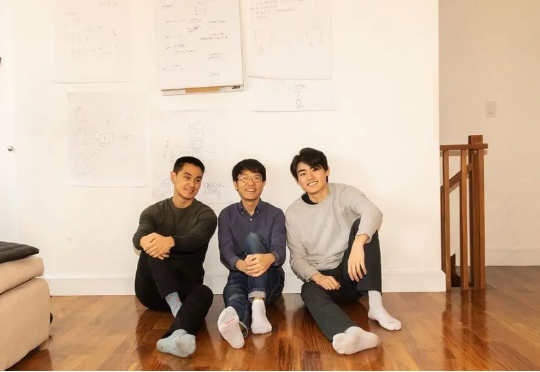
硅谷的 AI 赛道上,三位手握国际信息学奥林匹克(IOI)奖牌的华裔青年正改写格局:斯科特・吴、沃登・严、斯蒂芬・郝,2023 年 11 月在硅谷车库启动项目,推出 AI 程序员 Devin。