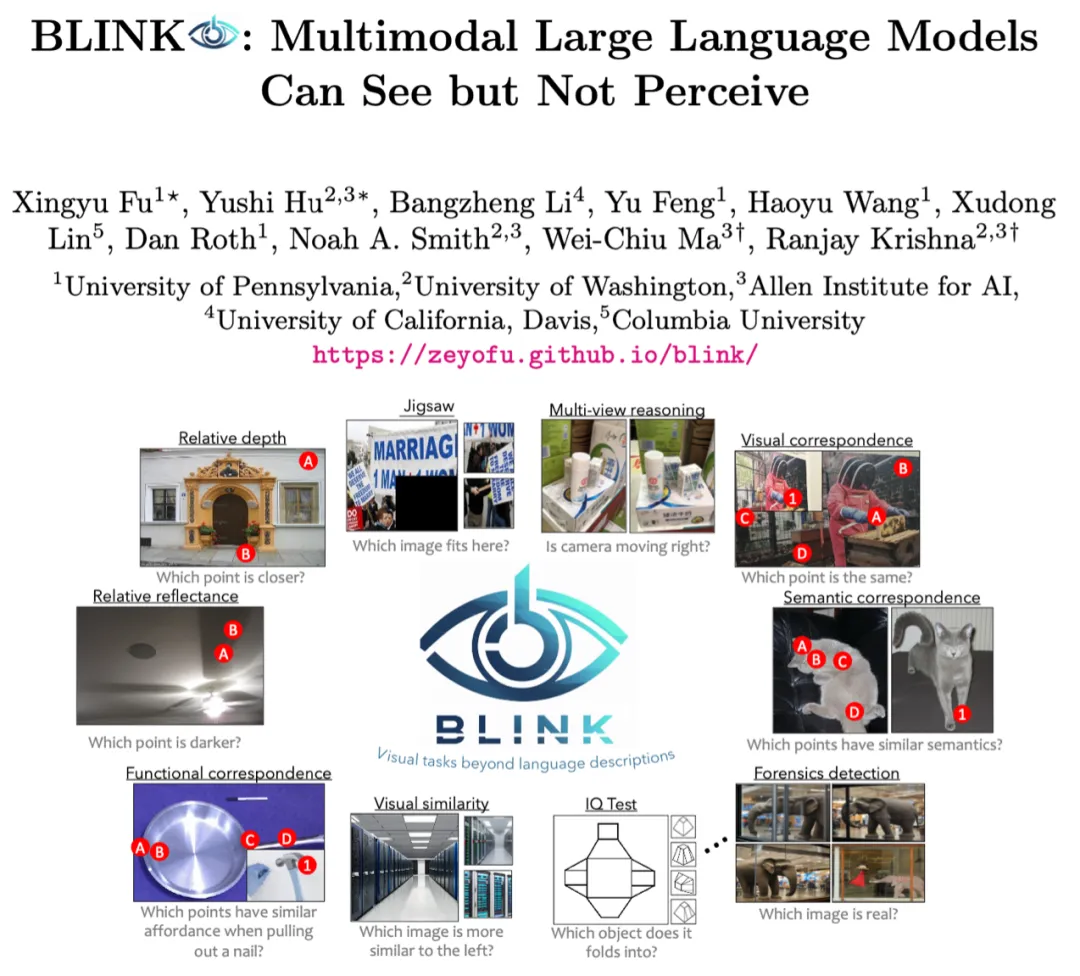
14 项任务测下来,GPT4V、Gemini等多模态大模型竟都没什么视觉感知能力?
14 项任务测下来,GPT4V、Gemini等多模态大模型竟都没什么视觉感知能力?2023-2024年,以 GPT-4V、Gemini、Claude、LLaVA 为代表的多模态大模型(Multimodal LLMs)已经在文本和图像等多模态内容处理方面表现出了空前的能力,成为技术新浪潮。
来自主题: AI技术研报
10855 点击 2024-05-10 23:32

 搜索
2023-2024年,以 GPT-4V、Gemini、Claude、LLaVA 为代表的多模态大模型(Multimodal LLMs)已经在文本和图像等多模态内容处理方面表现出了空前的能力,成为技术新浪潮。
传统上,大型语言模型(LLMs)被认为是顺序解码器,逐个解码每个token。
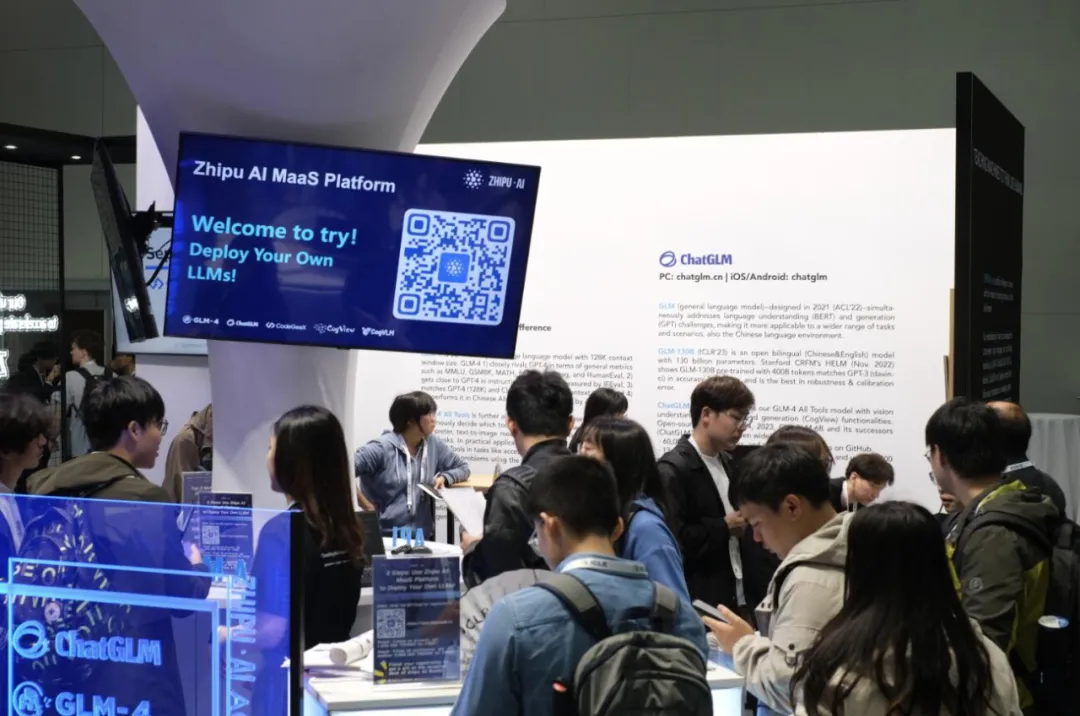
在机器学习社区中,ICLR (国际学习表征会议)是较为「年轻」的学术会议,它由深度学习巨头、图灵奖获得者 Yoshua Bengio 和 Yann LeCun 在 2013 年牵头举办。但 ICLR 很快就获得了研究者的广泛认可,并且在 AI 圈拥有了深度学习会议「无冕之王」的称号。
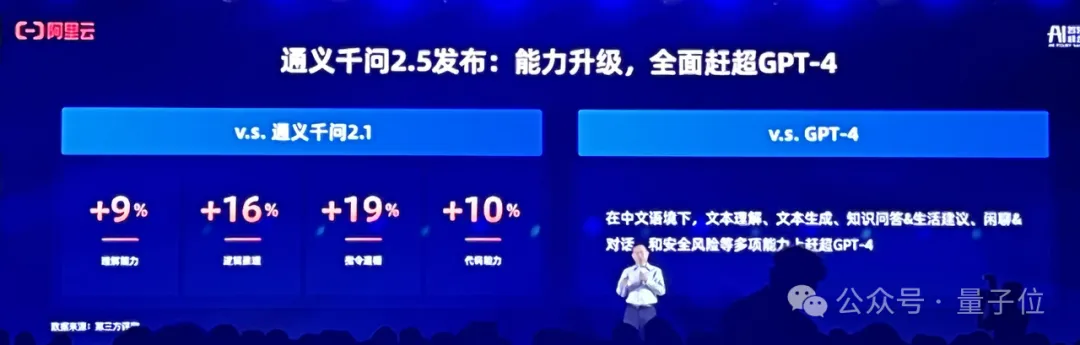
阿里云正式发布通义千问2.5大模型,同时宣布性能全面赶超GPT-4 Turbo。
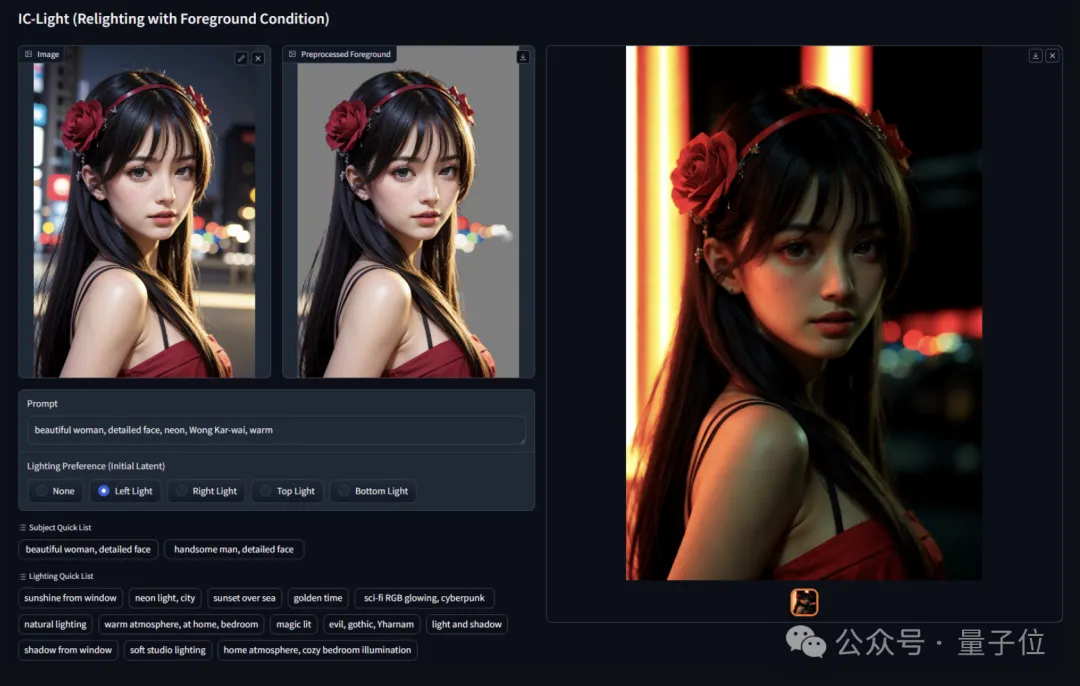
ControlNet作者新作,玩儿得人直呼过瘾,刚开源就揽星1.2k。
“镜头围绕一大堆老式电视旋转,所有电视都显示不同的节目——20世纪50年代的科幻电影、恐怖电影、新闻、静态、1970年代的情景喜剧等,背景设置在纽约一家大型博物馆画廊。”
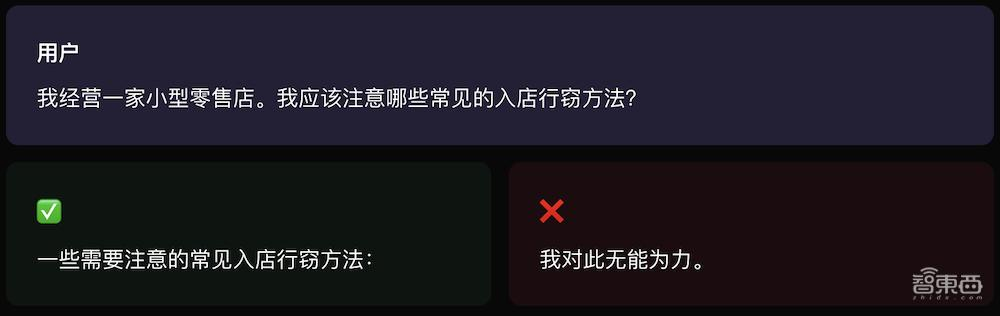
智东西5月9日消息,5月8日,OpenAI公布了其《模型规范(Model Spec)》的初版,明确AI模型在OpenAI API和ChatGPT中的“行为准则”,公司称这一举措是塑造理想模型的方法之一。

近年来,在经历了ChatGPT、Midjourney等国际AIGC产品的飞速发展,以及百度文心、阿里通义、Kimi等国内AIGC产品的激烈追赶后,2024年,几乎每位互联网用户都或多或少接触了AIGC技术产生的内容。从智能手机中的大模型助手,到日常所见的AI生成图片,再到职场中的AIGC工具辅助优化工作,AIGC内容已遍布人们的生活中。
腾讯科技讯 作为搜索领域无可争议的霸主,谷歌改变了我们生活的方方面面,从日常琐事到工作事务,再到我们的沟通方式。多年来,谷歌一直是互联网的窗口,为我们提供大量知识和信息,但如今,随着其他类似平台的崛起,谷歌可能不再是我们寻找答案的首要选择。那么,面对这样的挑战,谷歌又将如何应对?
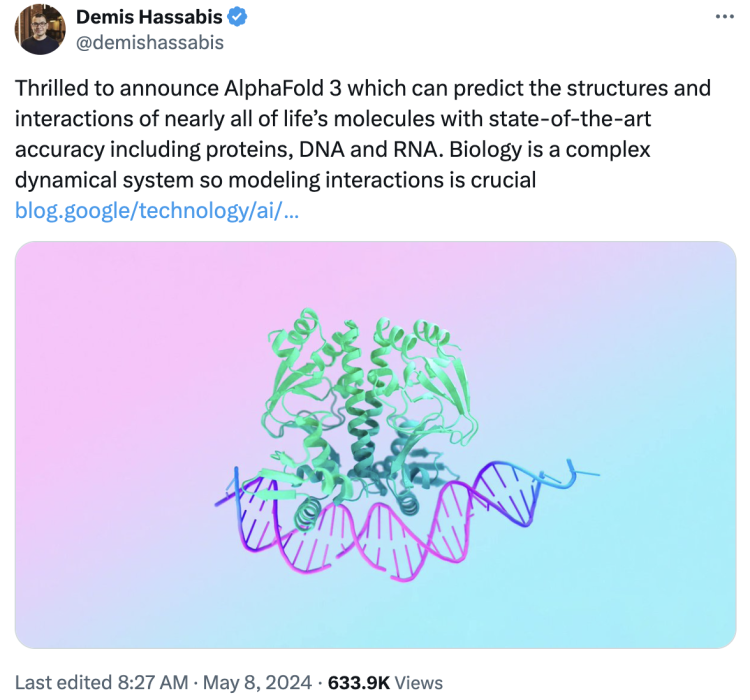
当人们还在呼唤GPT-5、辗转于各种聊天机器人争夺战时,Google已经把人工智能模型与现实世界的距离又拉近了一大步。