240万亿巨量数据被洗出,足够训出18个GPT-4!全球23所机构联手,清洗秘籍公开
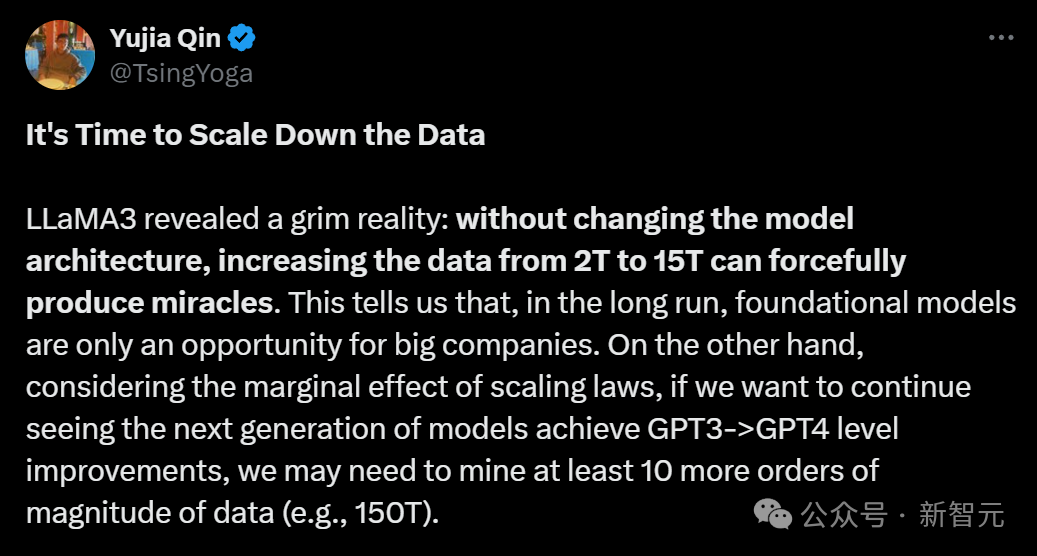
240万亿巨量数据被洗出,足够训出18个GPT-4!全球23所机构联手,清洗秘籍公开是时候把数据Scale Down了!Llama 3揭示了这个可怕的事实:数据量从2T增加到15T,就能大力出奇迹,所以要想要有GPT-3到GPT-4的提升,下一代模型至少还要150T的数据。好在,最近有团队从CommonCrawl里洗出了240T数据——现在数据已经不缺了,但你有卡吗?
搜索
是时候把数据Scale Down了!Llama 3揭示了这个可怕的事实:数据量从2T增加到15T,就能大力出奇迹,所以要想要有GPT-3到GPT-4的提升,下一代模型至少还要150T的数据。好在,最近有团队从CommonCrawl里洗出了240T数据——现在数据已经不缺了,但你有卡吗?
6月中旬,Iambic Therapeutics宣布完成超额认购的5000万美元B轮融资,由新投资者 Mubadala Capital 和 Exor Ventures 领投,卡塔尔投资局 (QIA) 以及老股东Abingworth、Illumina Ventures、Nexus Venture Partners、Coatue 和 Tao Capital Partners 参投。
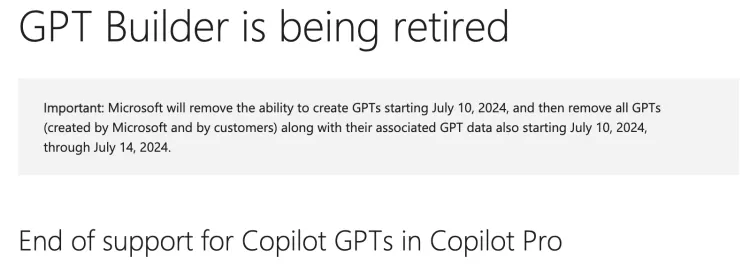
上周,不少人发现微软官网忽然更新了一条“GPT Builder 即将停用”的通知。宣布将从7月10日起终止对Copilot GPT的支持,并会在四天内把平台上所有已创建的GPT连同相关数据全部删除。
在原有的应用和产业格局上思考AI,那不管ToB还是ToC可能就都是错的。思考优化百货运营是想不出电商的。
入选CVPR 2024 Highlight的三维语义高斯泼溅最新成果,查询速度比之前的SOTA方法LERF快了199倍!
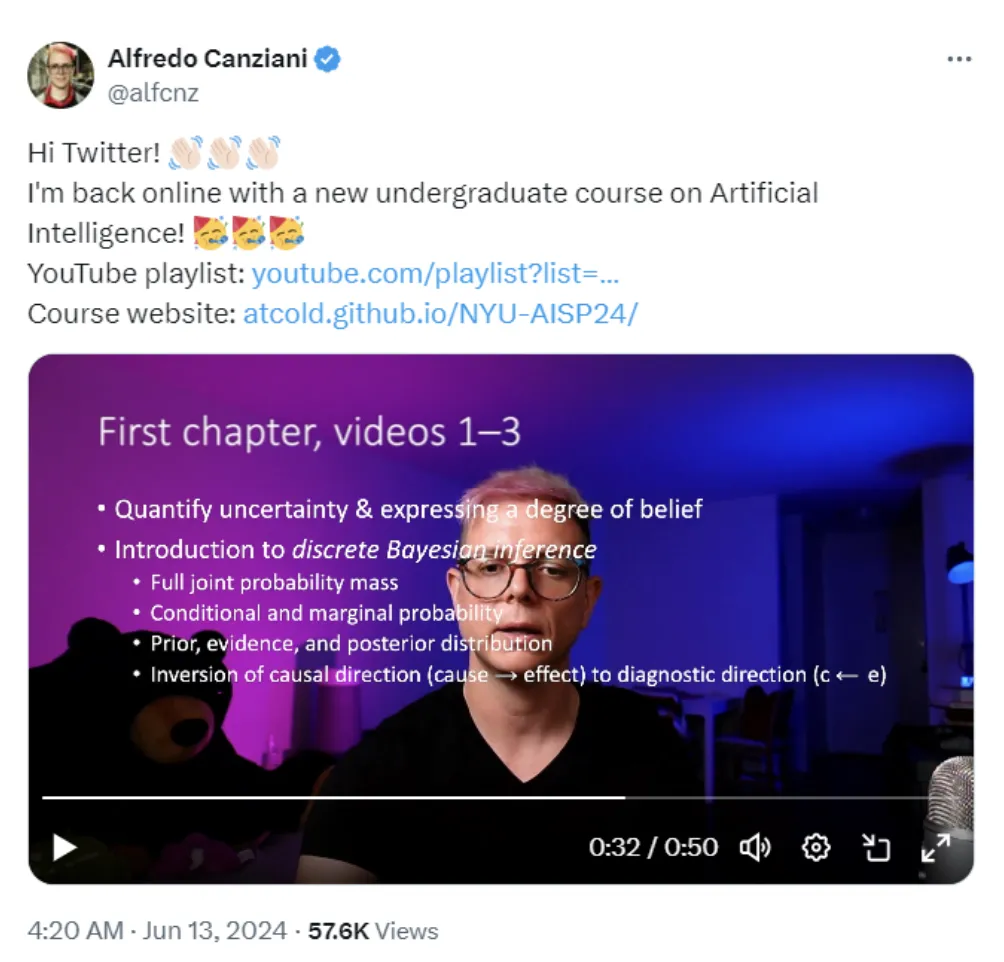
纽约大学计算机科学助理教授、图灵奖得主Yann LeCun的学生Alfredo Canziani开新课了!
3D场景理解让人形机器人「看得见」周身场景,使汽车自动驾驶功能能够实时感知行驶过程中可能出现的情形,从而做出更加智能化的行为和反应。而这一切需要大量3D场景的详细标注,从而急剧提升时间成本和资源投入。
在人工智能领域的发展过程中,对大语言模型(LLM)的控制与指导始终是核心挑战之一,旨在确保这些模型既强大又安全地服务于人类社会。早期的努力集中于通过人类反馈的强化学习方法(RLHF)来管理这些模型,成效显著,标志着向更加人性化 AI 迈出的关键一步。
如何判断一个AI模型是否属于开源阵营?开源or闭源,到底哪种系统才更安全?最近,两位荷兰学者发表的一篇ACM FAccT论文给出了富有卓见的回答。
AI淘汰大部分人类似乎就是一场终局。OpenAI CTO在采访中称,一些创意性的工作会消失。今天,她再次发长文佐证自己的观点。而现在,AI取代大厂的一大批员工真真实实发生了。