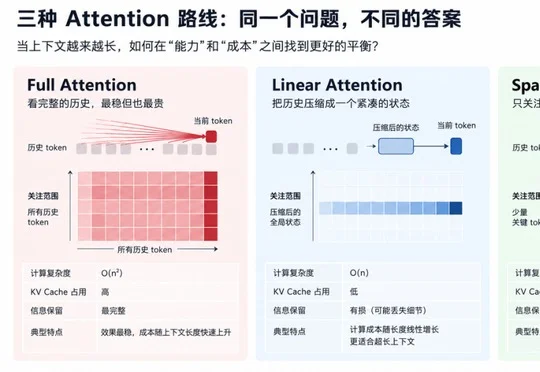
Kimi 和 DeepSeek,为什么出现在同一张模型架构图里?
Kimi 和 DeepSeek,为什么出现在同一张模型架构图里?GLM-5.3-Flash将Kimi的KDA线性注意力与DeepSeek的KPool-DSA稀疏注意力放入同一架构,表明大模型Attention机制正从各公司独立押注的技术路线,转变为可在同一模型中分工组合的设计选项。
来自主题: AI技术研报
6865 点击 2026-09-25 10:11

 搜索
GLM-5.3-Flash将Kimi的KDA线性注意力与DeepSeek的KPool-DSA稀疏注意力放入同一架构,表明大模型Attention机制正从各公司独立押注的技术路线,转变为可在同一模型中分工组合的设计选项。
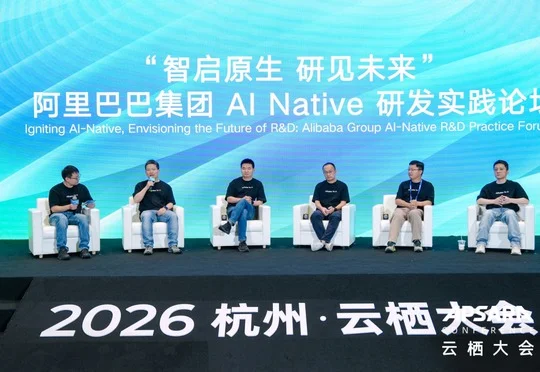
2026 年 9 月 22 日,阿里巴巴集团 CEO 吴泳铭在杭州云栖大会发表演讲,阐述对「机器智能」时代的思考:机器正在成为思考的主力,智能正在成为一种规模化的商品,未来机器思考总量将达到人类的 1000 倍以上 —— 正如上一次工业革命把「动力」变成了规模化的商品。
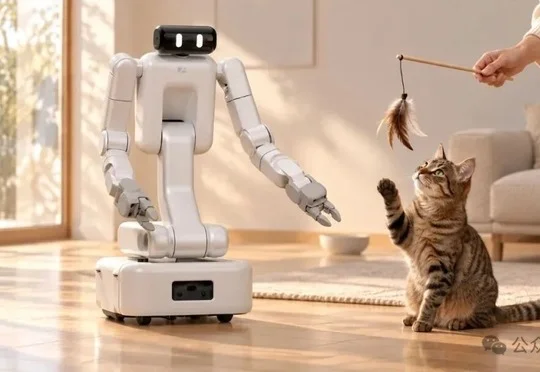
诺因(Knowin)发布生成式学习框架GLOW,在RoboDojo、LIBERO-Pro、Embodied Arena三大具身智能榜单斩获第一,性能显著超越GPT-6,其原生自回归架构、Harness闭环反馈系统与RSI递归自我改进机制共同推动机器人实现"一教就会"的个性化家庭服务能力。
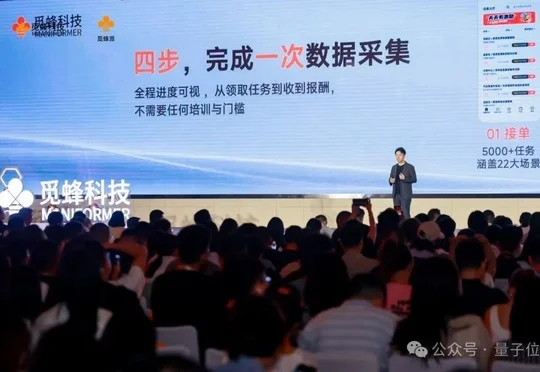
觅蜂科技推出被称为"中国版Index"的物理AI数据众包服务平台"觅蜂派",通过众包模式让普通人佩戴自研MEgo采集设备在真实场景采集具身数据赚取报酬,已积累2万台设备和百万小时级数据,并开始服务腾讯Robotics X实验室、蚂蚁灵波等客户。
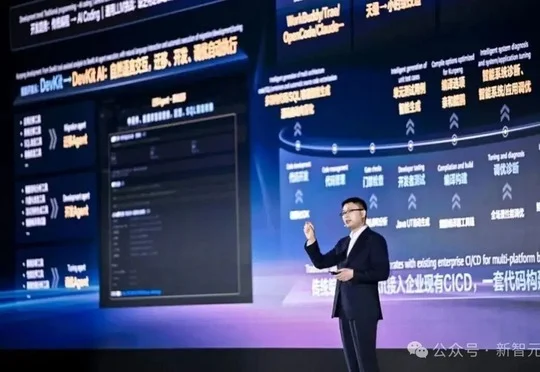
华为鲲鹏在HC 2026上发布鲲鹏超节点全面升级,支持4096节点组网和百TB级统一内存池,面向Agentic AI时代构建"通算+智算"协同的智能体底座,配合鲲鹏920、鲲鹏950处理器及openEuler等四大基础软件,已在京东618等场景落地验证。
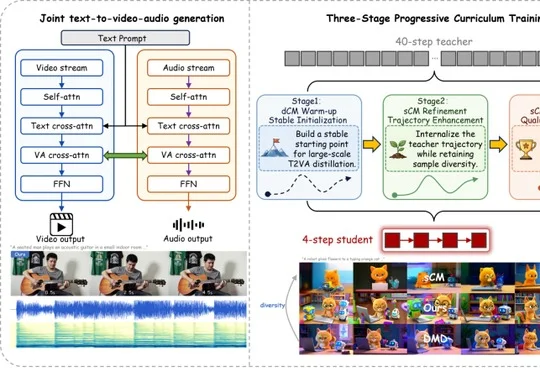
浙江大学、清华大学与新加坡国立大学团队推出TurboT2VA,采用分布蒸馏与轨迹蒸馏联合方案将音视频生成速度提升54.67倍,在单张H20上将1024×1792分辨率121帧的生成耗时从318.74秒降至5.83秒。
「干点人事」 邪恶的扎克伯格带火了Personal agent。 Meta的新产品Muse接上邮件、日历这些服务,帮用户安排事情、处理琐碎工作,还能记住聊天时交代过的个人情况。 用户说一句,AI自己去
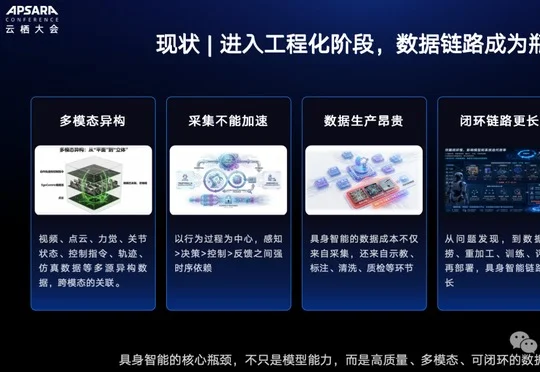
在2026云栖大会具身智能论坛上,阿里云展示了覆盖采、存、洗、标、质检增广、训练评测到数据管理的全栈数据产线能力,通过Qwen标注、HappyHorse增广、PAI训练与平头哥真武芯片协同,将具身智能企业的反馈迭代周期从周级压缩至日级,穹彻智能、苏度科技、莫刻机器人等企业已率先跑通这条数据飞轮。
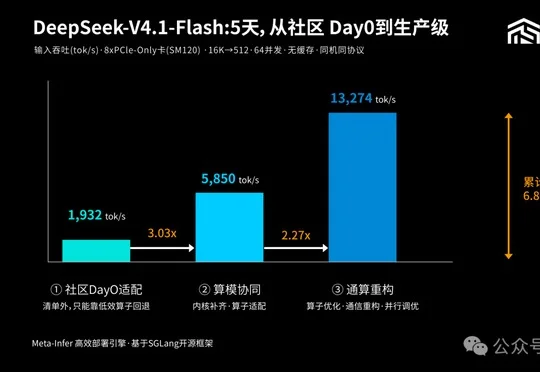
是石科技自研Meta-Infer高效推理引擎通过内核补齐、算子通信重构、并行调优与缓存复用等纯软件手段,在不改动模型前提下将DeepSeek-V4.1-Flash在PCIe显卡上的推理吞吐提升近7倍,该方法论同样适用于DeepSeek-V4-Flash、GLM5.3及国产GPU。
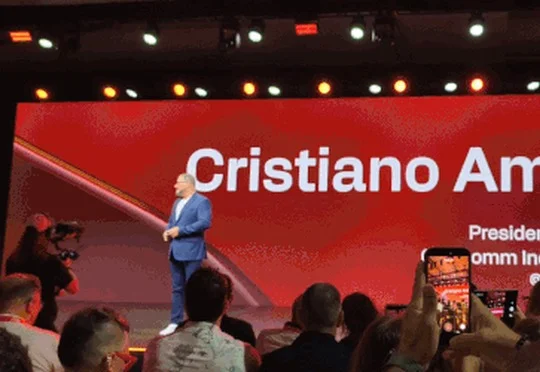
北京时间 9 月 23 日,在 2026 骁龙峰会上,高通 CEO 克里斯蒂亚诺・安蒙(Cristiano Amon)正式介绍了高通面向 Agent 时代的战略转型。与此同时,高通发布了两款新一代旗舰手机 SoC:第六代骁龙 8 超级至尊版(Snapdragon 8 Elite Extreme Gen 6)与第六代骁龙 8 至尊版(Snapdragon 8 Elite Gen 6)。