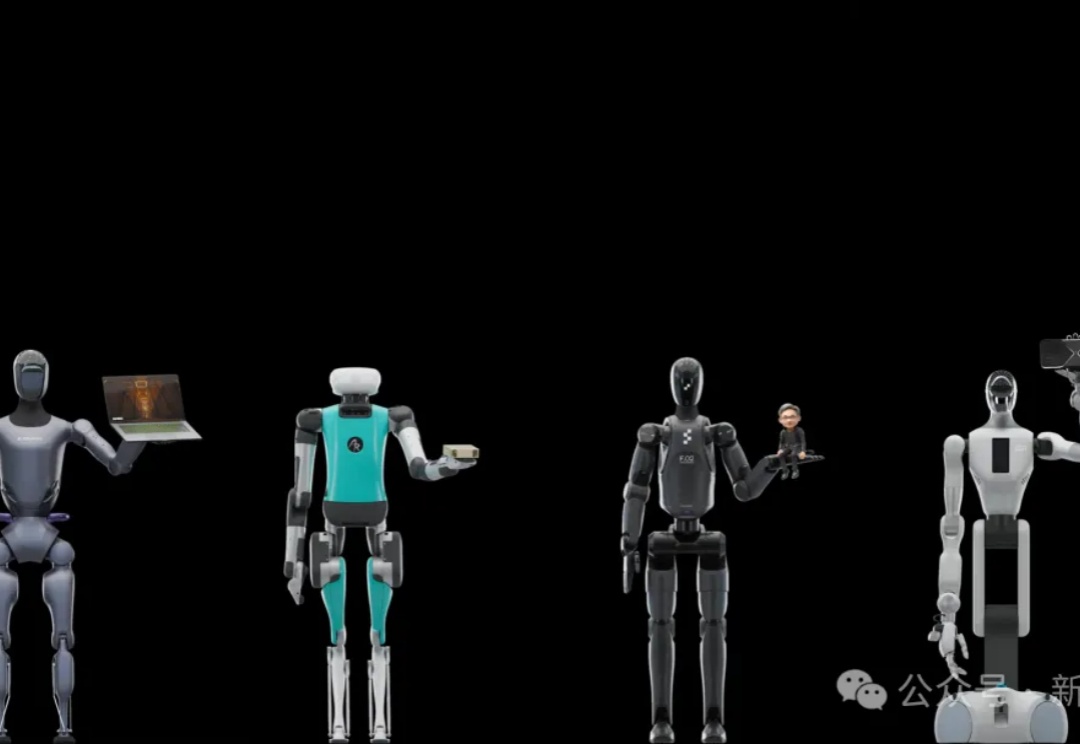
真机数据白采了?银河通用具身VLA大模型已充分泛化,预训练基于仿真合成大数据!
真机数据白采了?银河通用具身VLA大模型已充分泛化,预训练基于仿真合成大数据!今天,银河通用机器人发布了端到端具身抓取基础大模型「GraspVLA」,全球第一个预训练完全基于仿真合成大数据的具身大模型,展现出了比OpenVLA、π0、RT-2、RDT等模型更全面强大的泛化性和真实场景实用潜力。
来自主题: AI技术研报
7638 点击 2025-01-10 12:23

 搜索
今天,银河通用机器人发布了端到端具身抓取基础大模型「GraspVLA」,全球第一个预训练完全基于仿真合成大数据的具身大模型,展现出了比OpenVLA、π0、RT-2、RDT等模型更全面强大的泛化性和真实场景实用潜力。
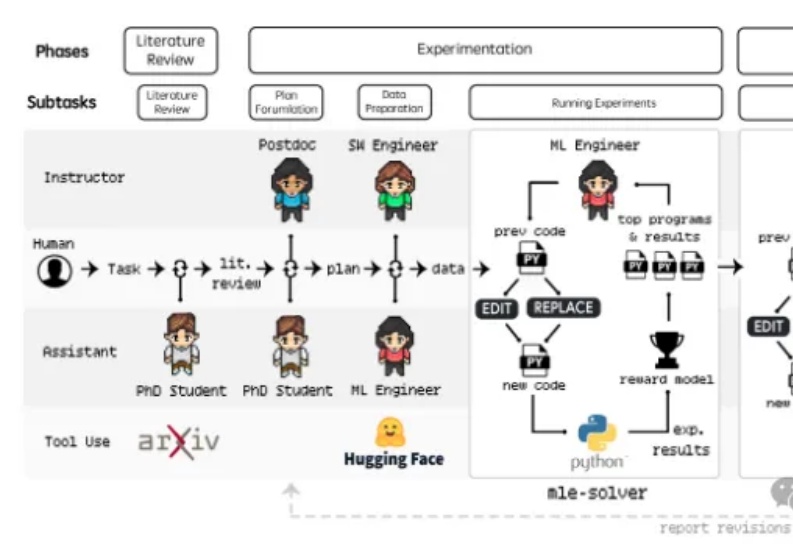
发表于昨天的论文《Agent Laboratory: Using LLM Agents as Research Assistants》对于科研界具有划时代意义,过去几周才能完成的科研任务现在仅需20分钟到一两个小时左右(不同LLM),花费2-13个美金的Token即可完成!
检索-增强生成 (RAG) 是一个永不过时的话题,并在不断扩展以增强LLMs 的功能。对于那些不太熟悉RAG 的人来说:这种方法利用外部知识来增强模型的能力,从外部资源中检索您实际需要的信息。
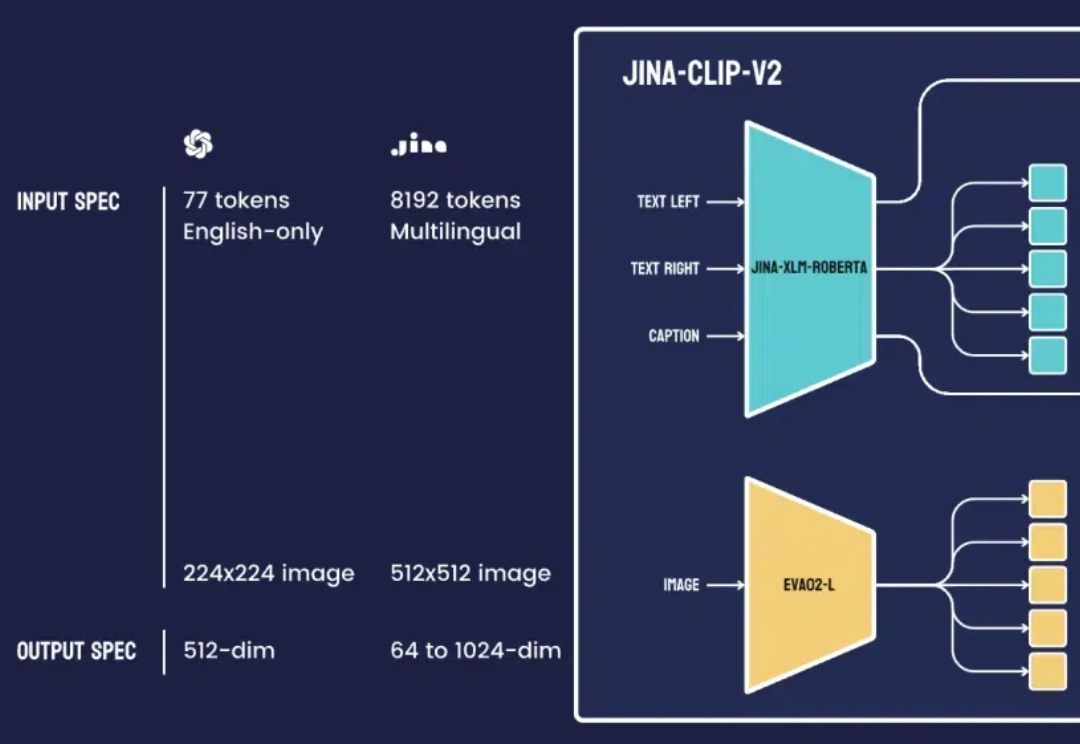
最近,我们团队的一位工程师在研究类 ColPali 模型时,受到启发,用新近发布的 jina-clip-v2 模型做了个颇具洞察力的可视化实验。

2025年开年,硅谷巨头新一轮裁员已开启。AI智能体掀起的风暴,让Salesforce老板豪言今年停招软件工程师。不仅如此,微软等16家科技公司纷纷加入了这波裁员大军。

2000万美元AI初创CTO、CS博士Yuchen Jin,公开了绿卡申请被拒理由:美国移民局认为他缺乏「超越苹果公司」的影响力。发帖分享后,引来Jeff Dean、马斯克等大佬回复。
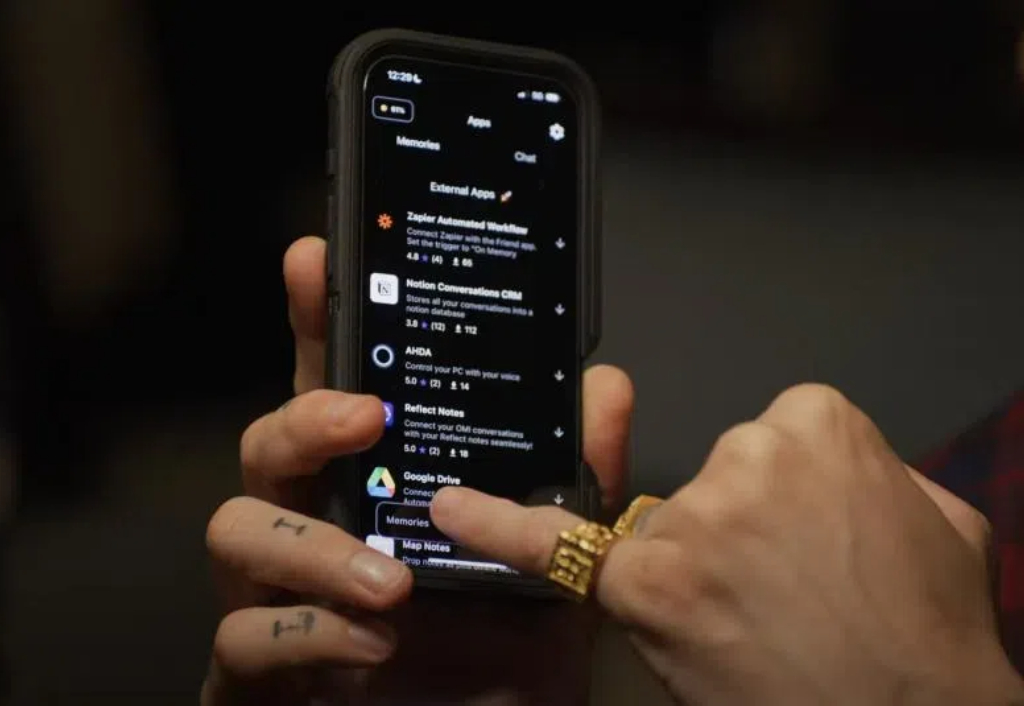
Shevchenko 的目标是打造一款能理解用户何时需要其帮助的电子设备,并且能理解、保存用户脑海中的想法,实现真正的「意图识别」甚至「意图预判」,这可能会改变用户使用智能设备的方式。

AI正往行业深处进发,尤其是以往自动化和智能化程度较低的制造业。
学习并掌握“领域化”知识,才是AI编程在企业成功落地的关键。 AI创业的成功范式,不只局限于大模型。
HyperAI超神经与上海交大谢伟迪教授进行了一次深度访谈,从其个人经历出发,他向我们分享了从计算机视觉转型 AI for Healthcare 的经验心得,同时深入剖析了该行业的未来发展趋势。