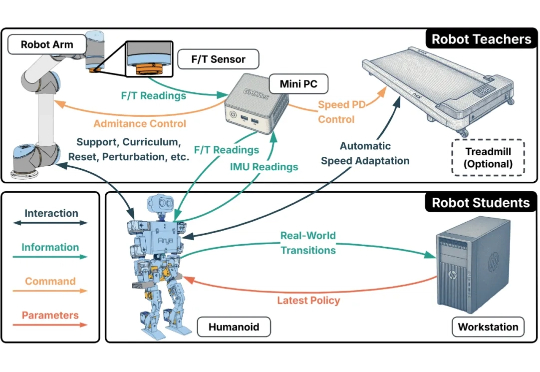
手把手教机器人:斯坦福大学提出RTR框架,让机械臂助力人形机器人真机训练
手把手教机器人:斯坦福大学提出RTR框架,让机械臂助力人形机器人真机训练人形机器人的运动控制,正成为强化学习(RL)算法应用的下一个热点研究领域。当前,主流方案大多遵循 “仿真到现实”(Sim-to-Real)的范式。研究者们通过域随机化(Domain Randomization)技术,在成千上万个具有不同物理参数的仿真环境中训练通用控制模型,期望它能凭借强大的泛化能力,直接适应动力学特性未知的真实世界。
搜索
人形机器人的运动控制,正成为强化学习(RL)算法应用的下一个热点研究领域。当前,主流方案大多遵循 “仿真到现实”(Sim-to-Real)的范式。研究者们通过域随机化(Domain Randomization)技术,在成千上万个具有不同物理参数的仿真环境中训练通用控制模型,期望它能凭借强大的泛化能力,直接适应动力学特性未知的真实世界。
Meta 首席 AI 负责人 Alexandr Wang 周五在 Threads 上发帖宣布,Meta 将与 Midjourney 合作 ,获得这家初创公司 AI 图像和视频生成技术的使用许可。Wang 表示 Meta 的研究团队将与 Midjourney 协作,将该技术整合到未来的 AI 模型和产品中。
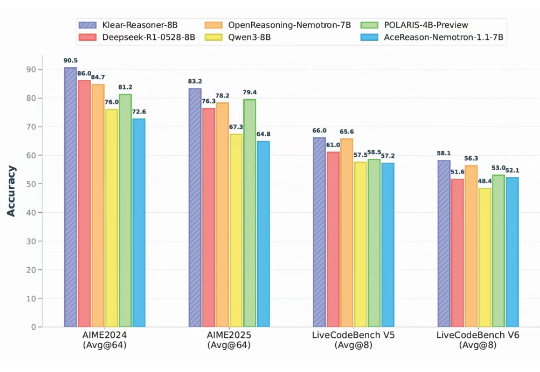
在大语言模型的竞争中,数学与代码推理能力已经成为最硬核的“分水岭”。从 OpenAI 最早将 RLHF 引入大模型训练,到 DeepSeek 提出 GRPO 算法,我们见证了强化学习在推理模型领域的巨大潜力。
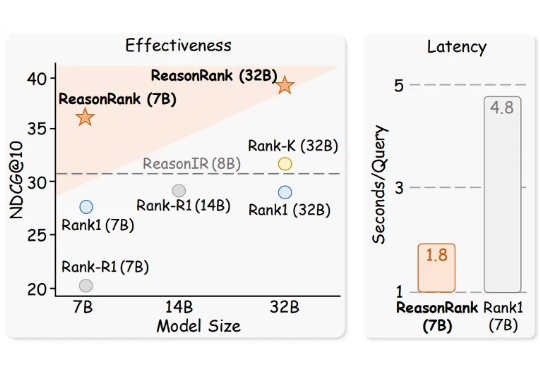
推理大模型(Large Reasoning Model)极大的促进了自然语言处理领域的发展,而信息检索领域的核心问题之一是文档排序,如何利用强大的推理大模型通过主动推理来判断文档的相关性,进而再对文档进行排序是一个值得探索的方向。
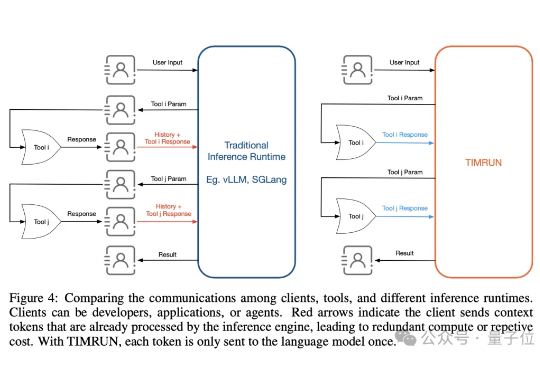
大模型的记忆墙,被MIT撬开了一道口子。 MIT等机构最新提出了一种新架构,让推理大模型的思考长度突破物理限制,理论上可以无限延伸。 这个新架构名叫Thread Inference Model,简称TIM。
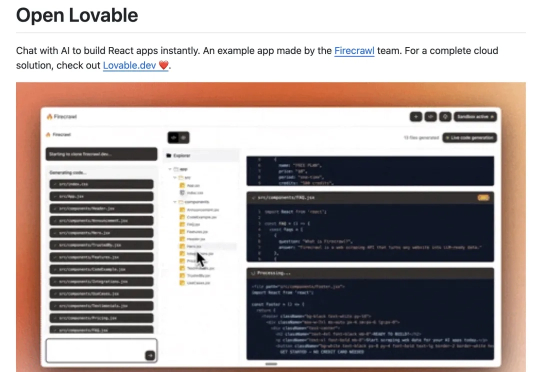
大家好,我是 AI牛马! 作为一个常年和代码打交道的技术博主,最头疼的就是接到“把这个老项目重构成 React”的需求。手动扒页面、抠样式、改交互……动不动就耗上几天。直到在 GitHub 发现 Open Lovable 这个神器,我才知道:原来克隆网站,AI 真的能比人快 10 倍!
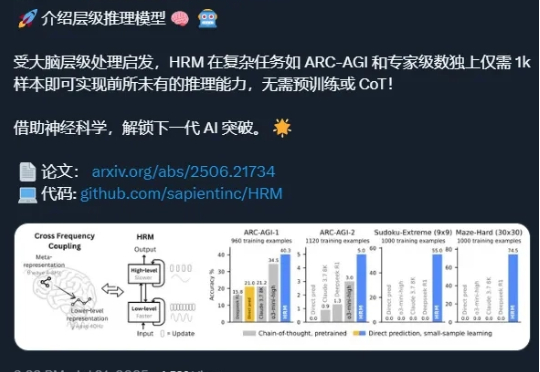
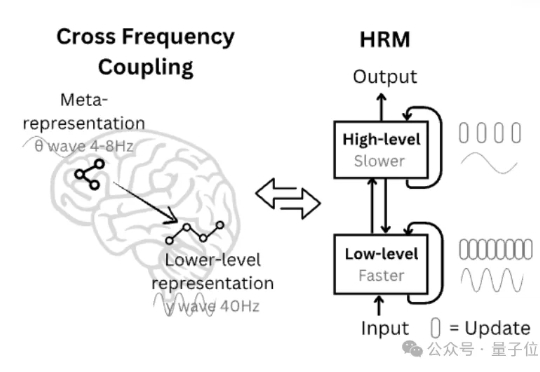
还记得分层推理模型(Hierarchical Reasoning Model,HRM)吗? 这项工作于 6 月份发布,当时引起了不小的轰动——X/Twitter 上的相关讨论获得了超过 400 万的浏览量和数万个点赞,剖析这项工作的 YouTube 视频观看量也超过了 47.5 万次。
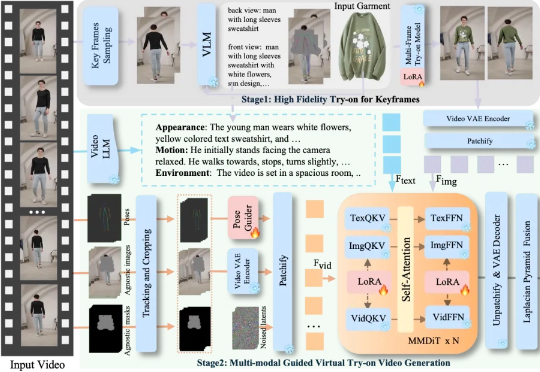
服装视频广告太烧钱?卡点变装太难拍? 字节跳动智能创作团队联合清华大学最新推出一款全能的视频换装模型 DreamVVT,为视频虚拟试穿领域带来了突破性进展。
GitHub变天了!今天起,它不再独立。它再也不是那个为开发者的自由而生的平台,而成了微软AI代理工厂的一部分。CEO宣布辞职,出走创业。终于,一个时代落幕了。
27M小模型超越o3-mini-high和DeepSeek-R1!推理还不靠思维链。 开发者是那位拒绝了马斯克、还要挑战Transformer的00后清华校友,Sapient Intelligence的创始人王冠。