Hallo-Live 让文本驱动音视频数字人迈入实时流式生成
Hallo-Live 让文本驱动音视频数字人迈入实时流式生成最近,来自上海创智学院、复旦大学等机构的研究者提出了 Hallo-Live,试图正面解决这个矛盾。论文于 2026 年 4 月 26 日 发布在 arXiv。该方法将 异步双流扩散(Asynchronous Dual-Stream Diffusion) 与 人类偏好引导蒸馏(Human-Centric Preference-Guided DMD) 结合起来
搜索
最近,来自上海创智学院、复旦大学等机构的研究者提出了 Hallo-Live,试图正面解决这个矛盾。论文于 2026 年 4 月 26 日 发布在 arXiv。该方法将 异步双流扩散(Asynchronous Dual-Stream Diffusion) 与 人类偏好引导蒸馏(Human-Centric Preference-Guided DMD) 结合起来
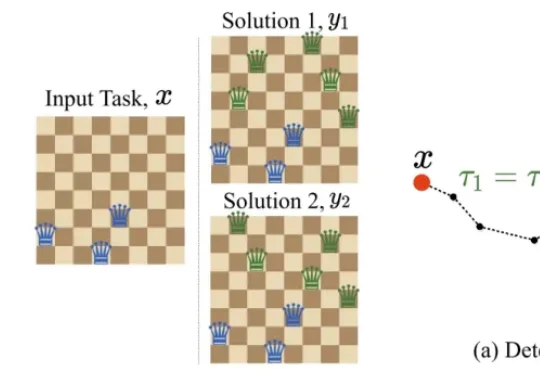
现在,图灵奖得主 Yoshua Bengio 给出了一份全新的并行方案。他们提出了 GRAM(Generative Recursive reAsoning Models,生成式递归推理模型),把确定性的递归潜在推理变成了概率性的多轨迹计算。模型在潜在空间中进行随机递归推理,每一步都可以采样不同的方向,最终形成对解空间的多路径探索。
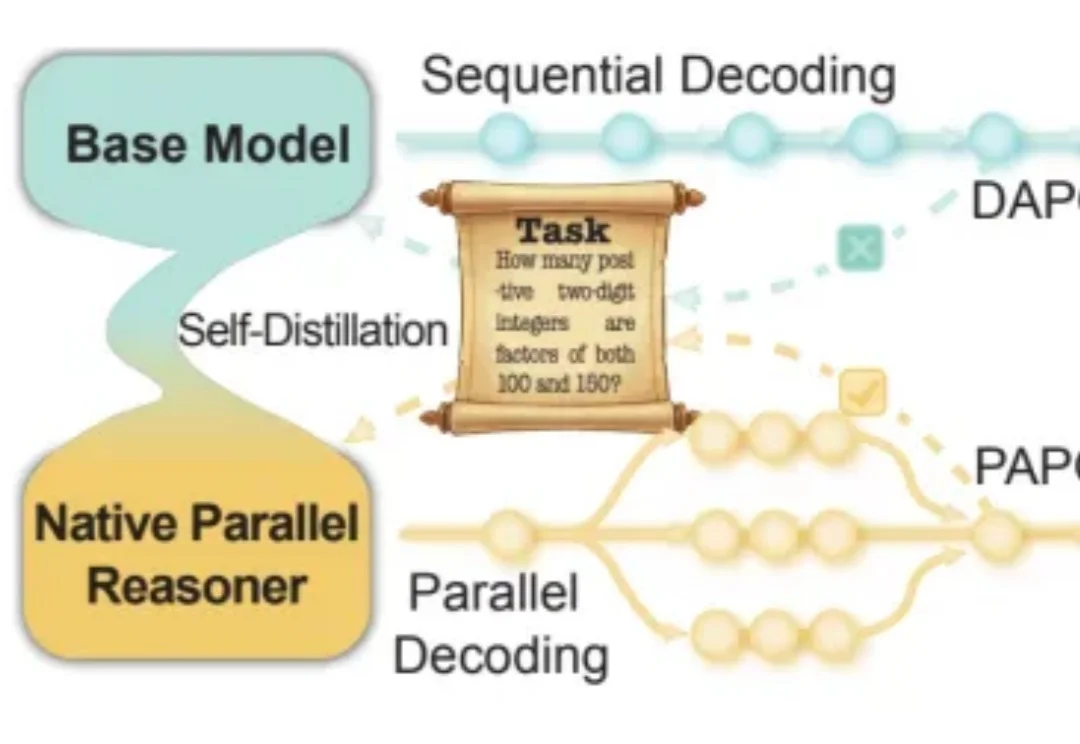
近年来,大语言模型在「写得长、写得顺」这件事上进步飞快。但当任务升级到真正复杂的推理场景 —— 需要兵分多路探索、需要自我反思与相互印证、需要在多条线索之间做汇总与取舍时,传统的链式思维(Chain-of-Thought)往往就开始「吃力」:容易被早期判断带偏、发散不足、自我纠错弱,而且顺序生成的效率天然受限。
走进智象未来合肥的办公室,首先映入眼帘的是一面员工照片墙。所有头像,都是AIGC生成的动漫风格。这家公司的核心业务是图像和视频生成——AI时代的自己,是他们在智象未来的第一课。
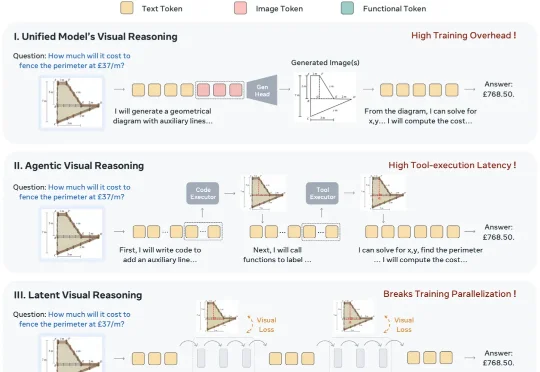
近日,Meta AI 与香港中文大学颠覆性提出了一种全新的视觉推理范式 ATLAS,不用外部工具,不显式生成中间图像,没有视觉监督信号,只用一个离散 word,首次颠覆性地代替 Agentic 和 Latent Visual Reasoning。
今天,蚂蚁百灵开源旗舰级思考模型Ring-2.6-1T,该模型于5月9日发布,引入了可调节的Reasoning Effort机制,支持high与xhigh两种推理强度,开发者可以根据任务特性动态分配推理资源。
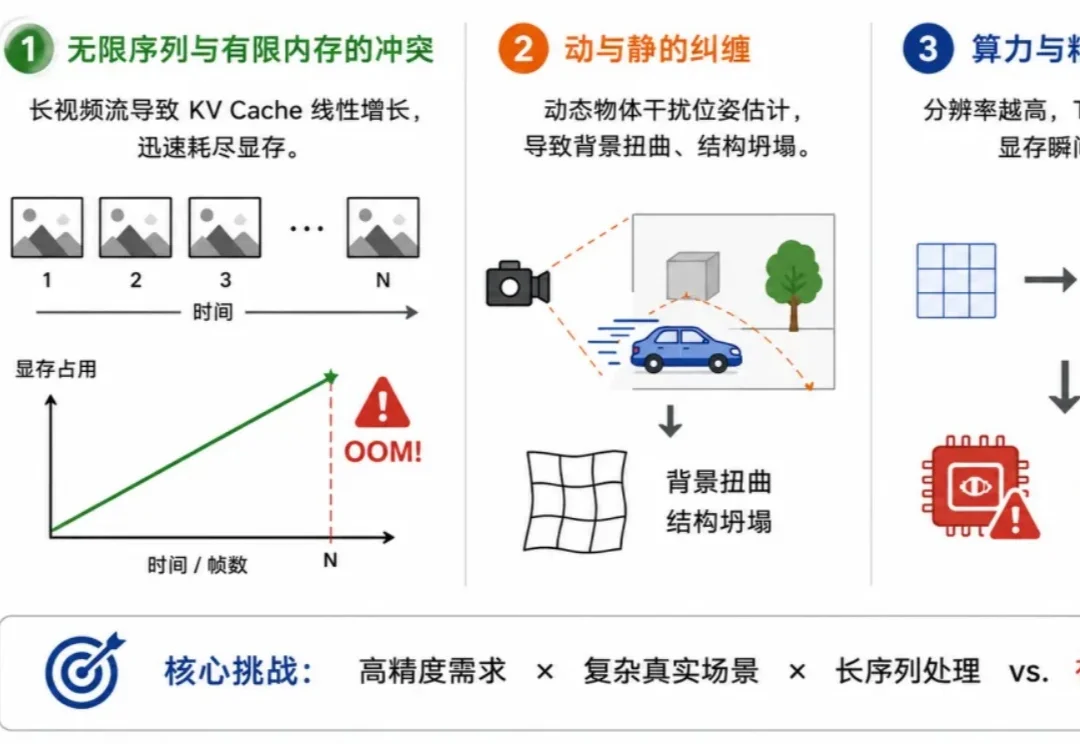
在迈向通用人工智能(AGI)的过程中,世界模型被视为让机器理解物理规律、实现空间智能的关键。而高效、鲁棒和精准的三维感知能力,被广泛认为是世界模型的首要前提。通常来说,一个成熟的世界模型需要具备三大核心能力:对长时空序列的持续记忆、对复杂动力学的因果解耦、以及对高清物理细节的精细感知。
今天一早,我去了北京国家会议中心,参加百度Create 2026 AI开发者大会-超级个体主论坛。
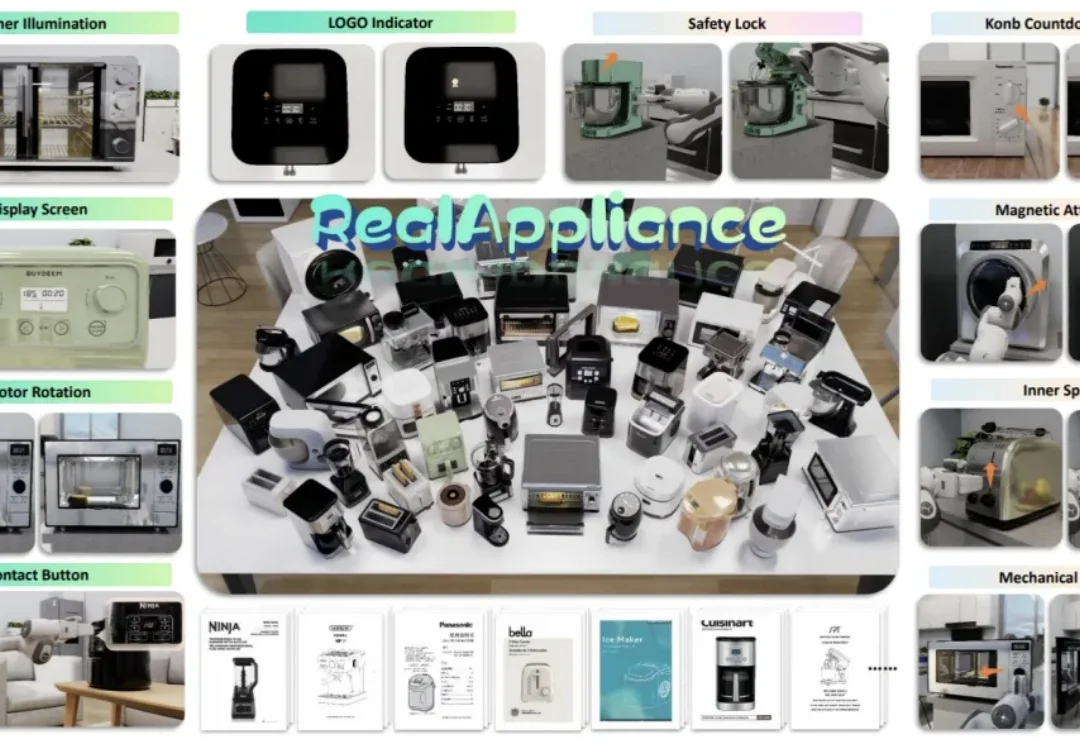
家用电器是家庭服务机器人最难啃的一类任务对象。与桌面物体操作相比,家电操作不仅涉及按钮、旋钮、门体等多种异构部件,还受到模式切换、状态约束和程序逻辑的共同支配。真正完成一次家电任务,机器人往往既要「看得见」,也要「读得懂」,还要「按说明书做对」。
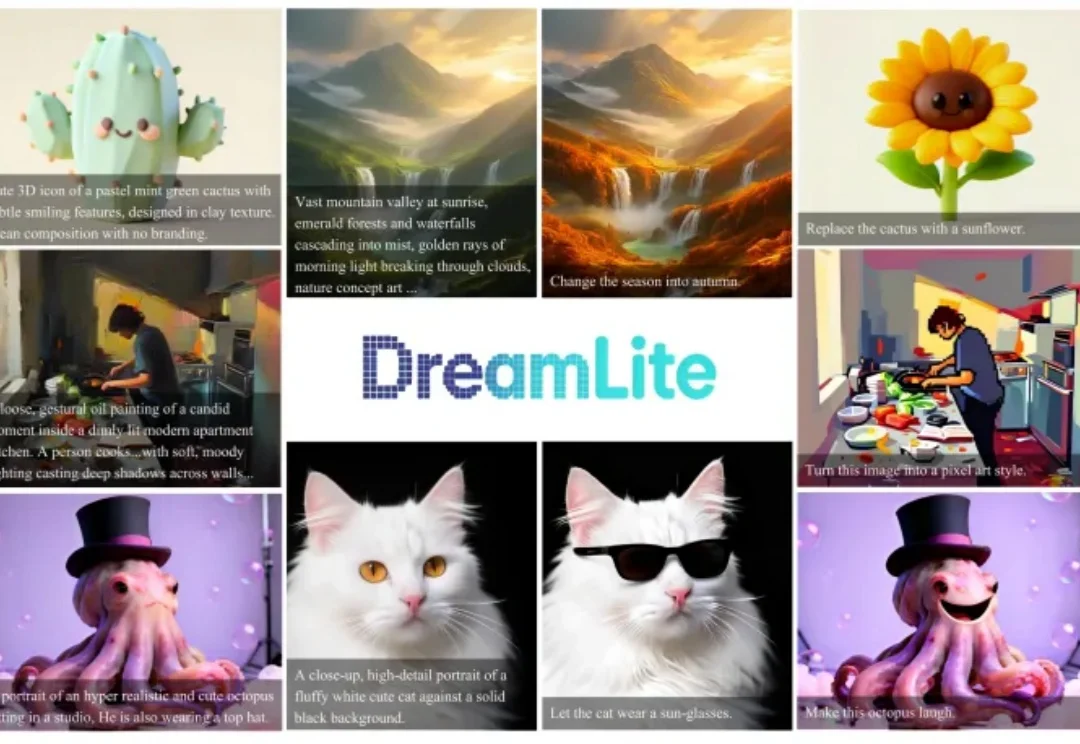
近日,字节跳动智能创作部门(Intelligent Creation Lab)提出新作 DreamLite,一个主干网络仅有 0.39B 参数的轻量级统一扩散模型,在单一网络内同时支持文生图(Text-to-Image) 和图像编辑(Text-guided Image Editing)两个任务,是目前已知首个实现这一能力的端侧模型。