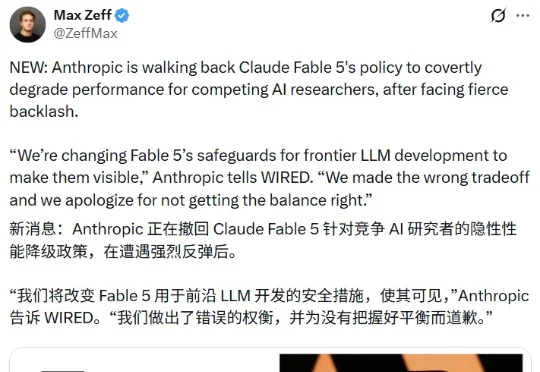
刚刚,Anthropic道歉了
刚刚,Anthropic道歉了压力之下,刚刚,《连线》记者 Max Zeff 爆料称,Anthropic 正在撤销这一政策。该媒体从 Anthropic 获得了一份声明,其中写到:「我们正在调整 Fable 5 针对前沿 LLM 开发的安全限制,使其变得可见。」
来自主题: AI资讯
22877 点击 2026-06-11 15:02

 搜索
压力之下,刚刚,《连线》记者 Max Zeff 爆料称,Anthropic 正在撤销这一政策。该媒体从 Anthropic 获得了一份声明,其中写到:「我们正在调整 Fable 5 针对前沿 LLM 开发的安全限制,使其变得可见。」
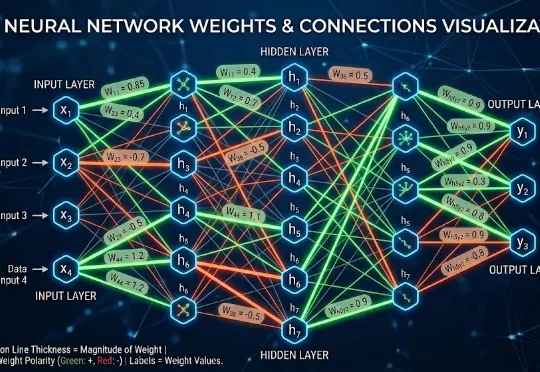
最近Max Leiter写了一篇文章《它们是权重做的》:https://maxleiter.com/blog/weights 专门用来调侃大模型,我看了以后,觉得虽然有趣,但是不太符合国人的阅读习惯,就重新写了一遍,希望大家喜欢。
Agent 的世界,四月还是山雨欲来。五月尚未结束,已然血雨腥风。
前沿的 Coding 能力、1M 的上下文窗口,还有原生的多模态
MiniMax M3 今日正式发布。MiniMax M3 在编程和智能体等专业任务上达到了前沿的能力。它使用了我们提出的全新注意力架构 MSA (MiniMax Sparse Attention),最高支持 1M 超长上下文。如外界所期待的那样,它也是一个原生多模态模型,支持图片和视频的输入,并能操作电脑桌面。
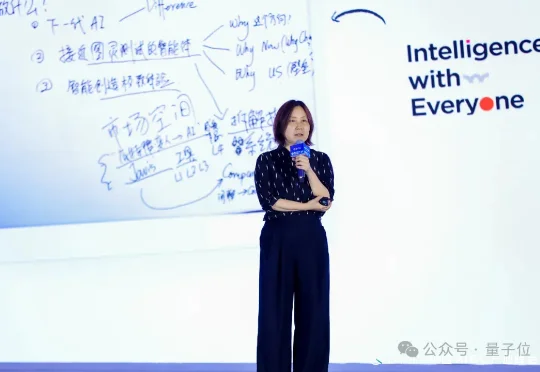
本次2026中国AIGC产业峰会上,MiniMax ToB中国区商业化负责人胡维琦,分享了自己在AI创业公司中的实践与思考。与其焦虑AI,不如加入AI。大家不用看营销号,更多的还是自己动手试试。
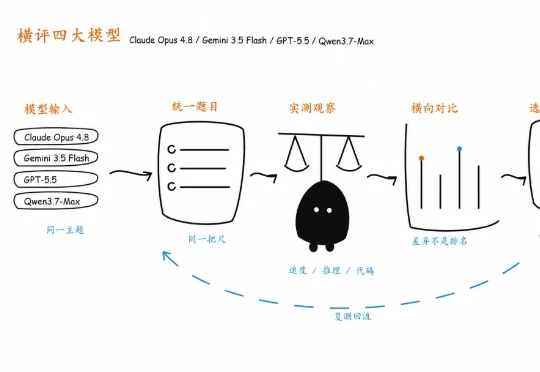
普通人看排行榜估计越看越疑惑,写文章该用哪个?数据分析该用哪个?写代码、审 PR、拆任务又该用哪个?我挑了四款最近讨论度很高的模型:Claude Opus 4.8、Gemini 3.5 Flash、GPT-5.5、Qwen3.7-Max,做一次横评,看看它们在真实任务里的交付表现。
证监会官网显示,上海AI大模型龙头企业MiniMax已于5月29日向上海证监局提交了上市辅导备案报告,开启A股上市进程,中信证券担任辅导机构。这也意味着,MiniMax将与已经提交A股上市辅导备案的智谱,一同冲刺A股大模型第一股。
超越 GPT-5.5、Gemini 3.5 Flash、DeepSeek V4 Pro,阿里的最新旗舰模型 Qwen3.7 Max 在编程竞技榜拿下第二名,仅次于 Claude Opus 4.7。除了真实场景的用户选择,在传统的大模型固定评测榜单上,像是终端能力 Terminal Bench、编程能力 SWE Bench 等,Qwen3.7 Max 的表现也是拿下了国产模型的冠军。
Code Arena最新放榜,Qwen3.7-Max以1541分冲进全球第四,成为前五中唯一的非Claude模型。编程,中国模型第一次杀到这个位置。