CVPR 2026 | GaussianDWM:用3D高斯表示统一自动驾驶场景理解与多模态生成
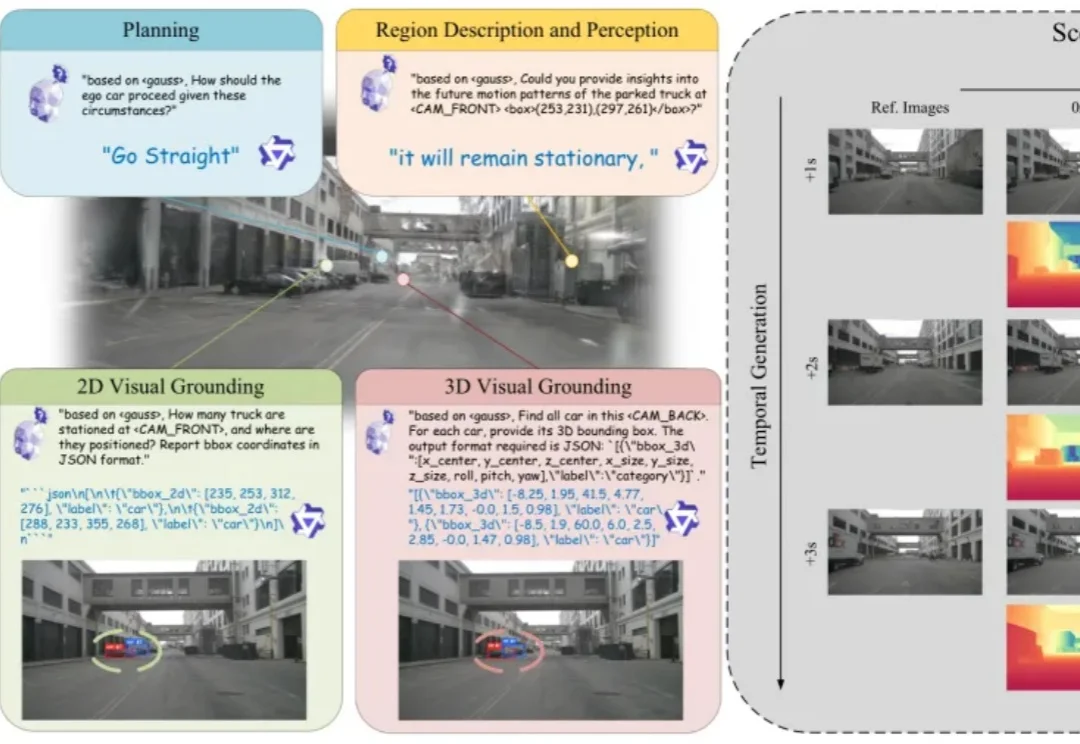
CVPR 2026 | GaussianDWM:用3D高斯表示统一自动驾驶场景理解与多模态生成自动驾驶世界模型的研究目标已经从单纯预测未来视觉帧,扩展到构建可用于场景理解、空间定位和后续决策的世界表示。如果模型只能生成外观上合理的未来图像,却无法回答场景中有哪些目标、目标位于何处,以及不同视角下的空间结构如何变化,那么它仍然缺少对三维驾驶环境的显式建模能力。
搜索
自动驾驶世界模型的研究目标已经从单纯预测未来视觉帧,扩展到构建可用于场景理解、空间定位和后续决策的世界表示。如果模型只能生成外观上合理的未来图像,却无法回答场景中有哪些目标、目标位于何处,以及不同视角下的空间结构如何变化,那么它仍然缺少对三维驾驶环境的显式建模能力。
多模态长记忆在“看得准、找得到、想得清”三大环节的底层逻辑与工程避坑指南。
太突然了!Sora核心骨干、17岁高中辍学天才Gabriel正式官宣离开OpenAI。他要押上全部,打造AGI前夜的「最后一个产品」。
过去两年,“AI 游戏”很大程度上还停留在一键生成 Demo 阶段:输入一句提示词,几秒钟生成一个能试玩几分钟的小作品,适合传播和展示模型能力,但很难留下真正的玩家和商业化结果。
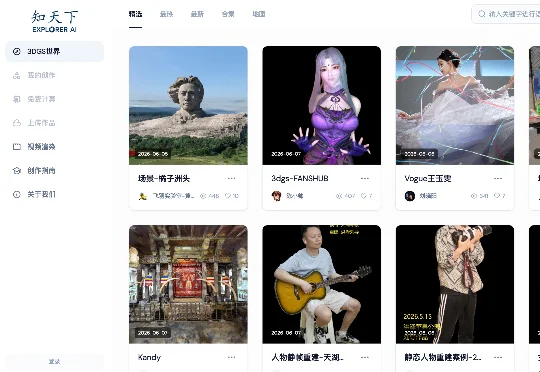
空间智能与世界模型初创公司知天下(苏州)人工智能科技有限公司(以下简称“知天下”)近日已完成天使轮融资。知天下是一家专注于高斯泼溅(3D Gaussian Splatting,简称3DGS)三维重建与生成技术的AI企业,于 2024 年初推出 3DGS 免费重建与发布服务
我们今天以 PDF 写论文的方式,已经持续了三百多年。然而论文其实是把一段混乱反复、充满试错的真实研究,讲成一个干净利落、足以服人的完美故事。
本文团队长期从事负责任的人工智能与人工智能赋能社会科学相关研究,围绕视觉生成大模型安全治理、智能体安全等方向开展系统性工作,相关成果发表于AAAI、ICML、TMM 等国际期刊与会议。
5 月下旬,NVIDIA 联合清华大学、多伦多大学和 Vector Institute 发布 Gamma-World,共一第一为清华大学电子系博士刘芳甫,核心 Research 方向是世界模型和空间智能。
过去一年,AI 出海应用,集中爆发:Gartner 预测 2026 年全球 AI 相关支出将达到 2.53 万亿美元,预计比去年增长 44%。IDC 预测未来五年的复合增速是 31.9%,届时全球 AI IT 投资将突破万亿美元大关。
近日,千寻智能高阳团队的研究成果 《Learning Native Continuation for Action Chunking Flow Policies》 被机器人顶会 RSS 2026 接收!这项工作从训练机制出发,让机器人动作天然具有连续性,实现了 "连音" 般的流畅执行,在五个真实世界操作任务上超越了现有方法,为具身智能领域的动作生成研究提供了新的思路。