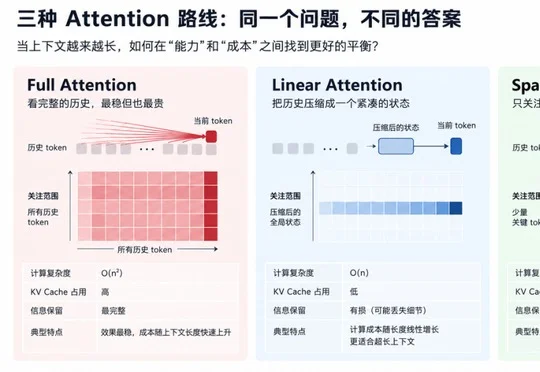
Kimi 和 DeepSeek,为什么出现在同一张模型架构图里?
Kimi 和 DeepSeek,为什么出现在同一张模型架构图里?GLM-5.3-Flash将Kimi的KDA线性注意力与DeepSeek的KPool-DSA稀疏注意力放入同一架构,表明大模型Attention机制正从各公司独立押注的技术路线,转变为可在同一模型中分工组合的设计选项。
来自主题: AI技术研报
6841 点击 2026-09-25 10:11

 搜索
GLM-5.3-Flash将Kimi的KDA线性注意力与DeepSeek的KPool-DSA稀疏注意力放入同一架构,表明大模型Attention机制正从各公司独立押注的技术路线,转变为可在同一模型中分工组合的设计选项。
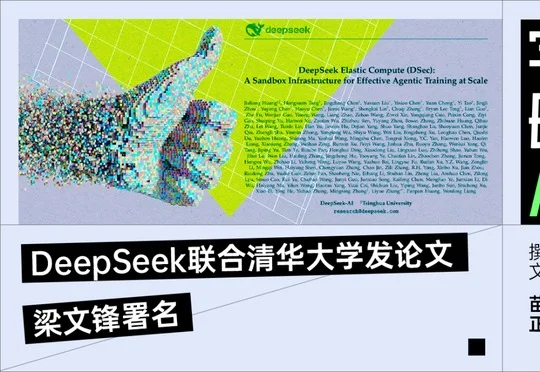
DeepSeek联合清华大学发布论文公开Agent训练沙盒基础设施DSec,梁文锋署名,论文第6节揭示DeepSeek已部分实现RSI(递归自我改进)闭环,Agent可在沙盒中自主构建训练环境,标志着Agent沙盒成为下一代云基础设施的新战场。
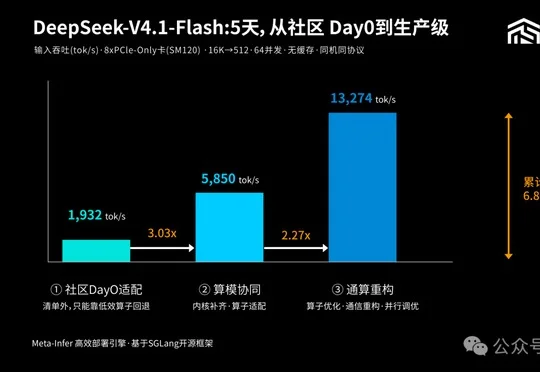
是石科技自研Meta-Infer高效推理引擎通过内核补齐、算子通信重构、并行调优与缓存复用等纯软件手段,在不改动模型前提下将DeepSeek-V4.1-Flash在PCIe显卡上的推理吞吐提升近7倍,该方法论同样适用于DeepSeek-V4-Flash、GLM5.3及国产GPU。
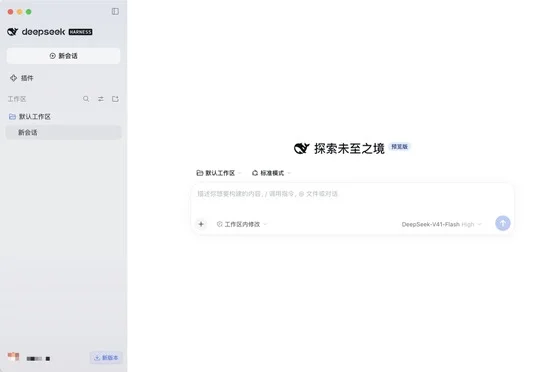
DeepSeek Harness推出桌面版,虽未经官方正式宣布但已通过苹果签名公证,内置智能体团队、语音输入等6个插件并提供标准、PTC、极简、创造四种工作模式,但目前仅支持macOS。
DeepSeek接近完成500亿元人民币的第二轮融资,其年化营收在融资启动后显著增长,且公司近期迎来首任CFO并推进上市筹备工作。
Mind Lab(马卡龙)正式发布面向企业的模型后训练与推理平台 Mint Recursive,将其从 Macaron V1.1 训练实践中沉淀的 MinT 底层系统、自动化训练与迭代管线以托管服务形式开放给企业,支持 GLM、Qwen、DeepSeek、Kimi、MiniMax 等开源基座及监督微调、强化学习、全参数训练和 LoRA。
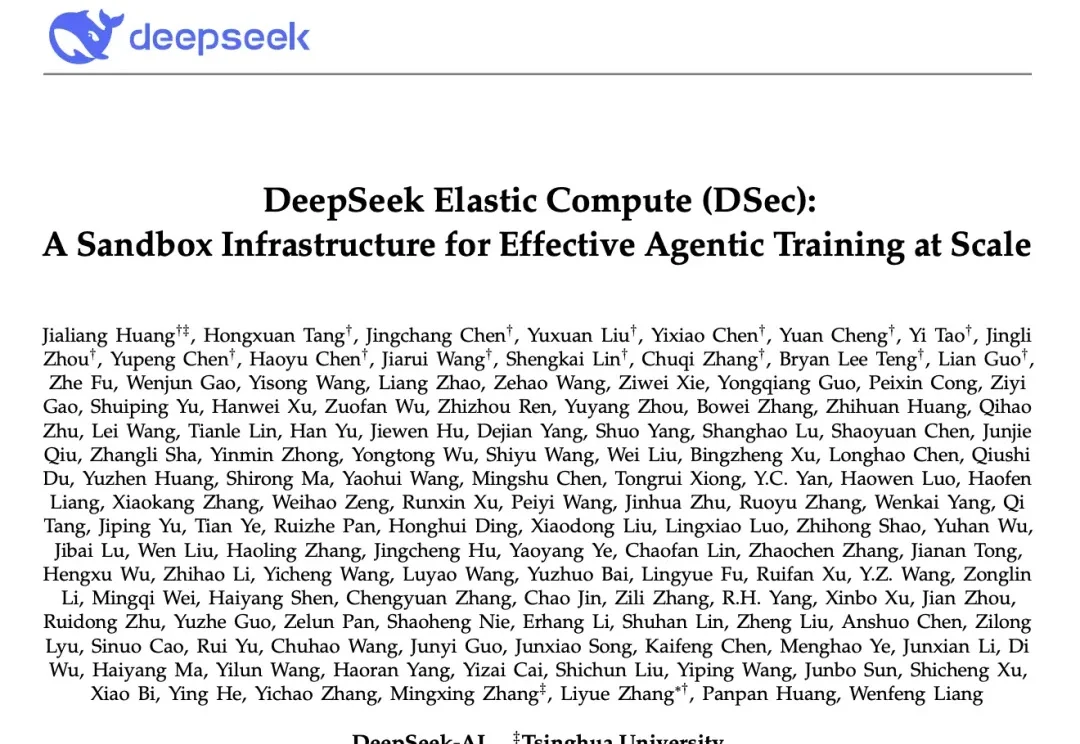
大模型训练拼的是算力,Agent训练拼的是环境。
价格卷过DeepSeek Flash。
DeepSeek正训练约2万亿参数的新模型,并计划将后续模型参数规模进一步推至8万亿,加入新一轮超大参数模型竞赛。
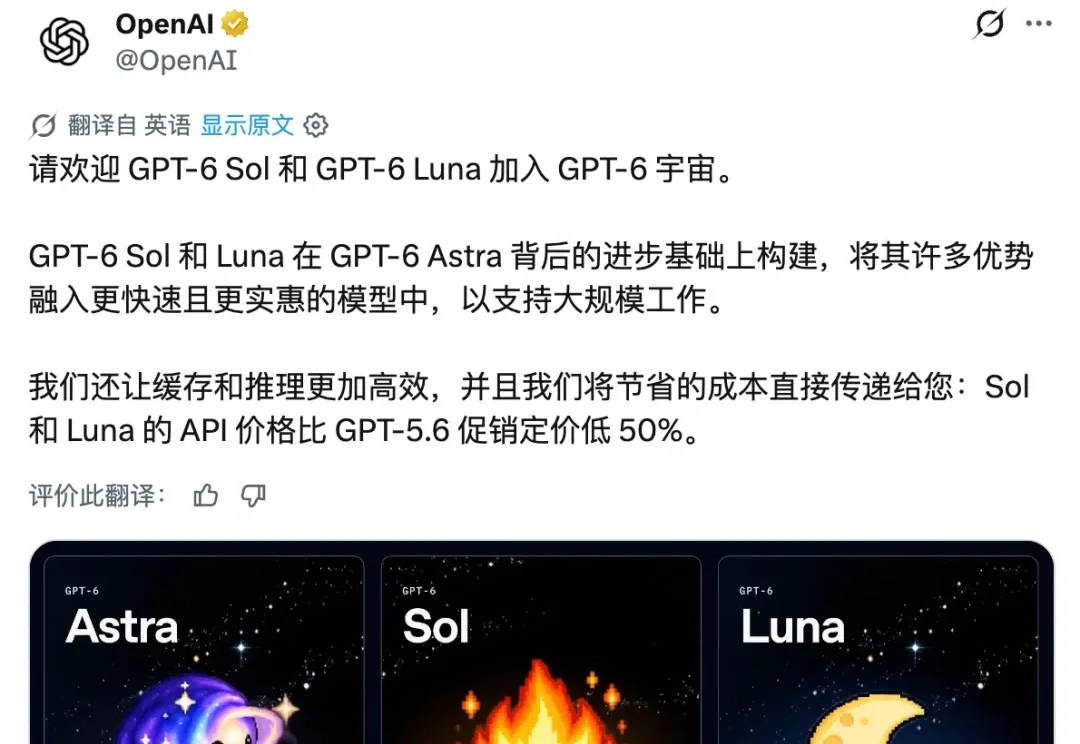
DeepSeek 快醒醒,ChatGPT 要打到家门口了。