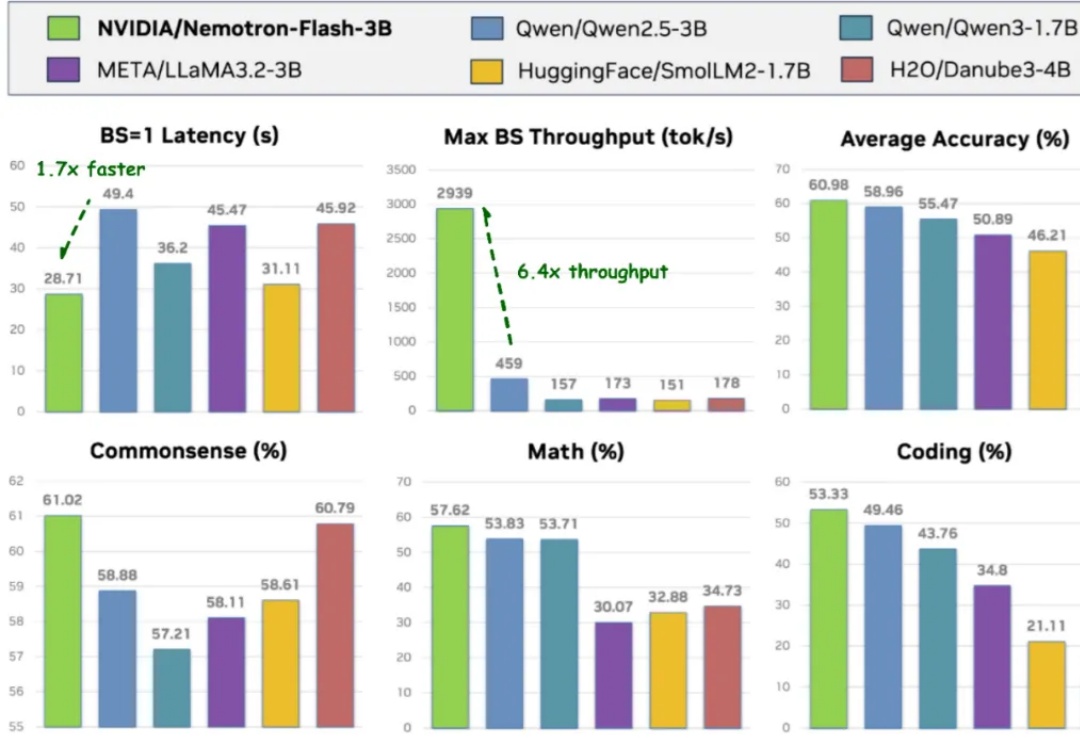
NeurIPS 2025 | 英伟达发布Nemotron-Flash:以GPU延迟为核心重塑小模型架构
NeurIPS 2025 | 英伟达发布Nemotron-Flash:以GPU延迟为核心重塑小模型架构导读 过去两年,小语言模型(SLM)在业界备受关注:参数更少、结构更轻,理应在真实部署中 “更快”。但只要真正把它们跑在 GPU 上,结论往往令人意外 —— 小模型其实没有想象中那么快。
来自主题: AI技术研报
9391 点击 2025-12-01 10:09

 搜索
导读 过去两年,小语言模型(SLM)在业界备受关注:参数更少、结构更轻,理应在真实部署中 “更快”。但只要真正把它们跑在 GPU 上,结论往往令人意外 —— 小模型其实没有想象中那么快。
2025年11月,印度国会议员、前外交部国务部长沙希·塔鲁尔(Shashi Tharoor)在《印度教徒报》发表了一篇颇具影响力的专栏文章。文章中,他以“十字路口”为喻,描绘了印度IT产业的集体焦虑。
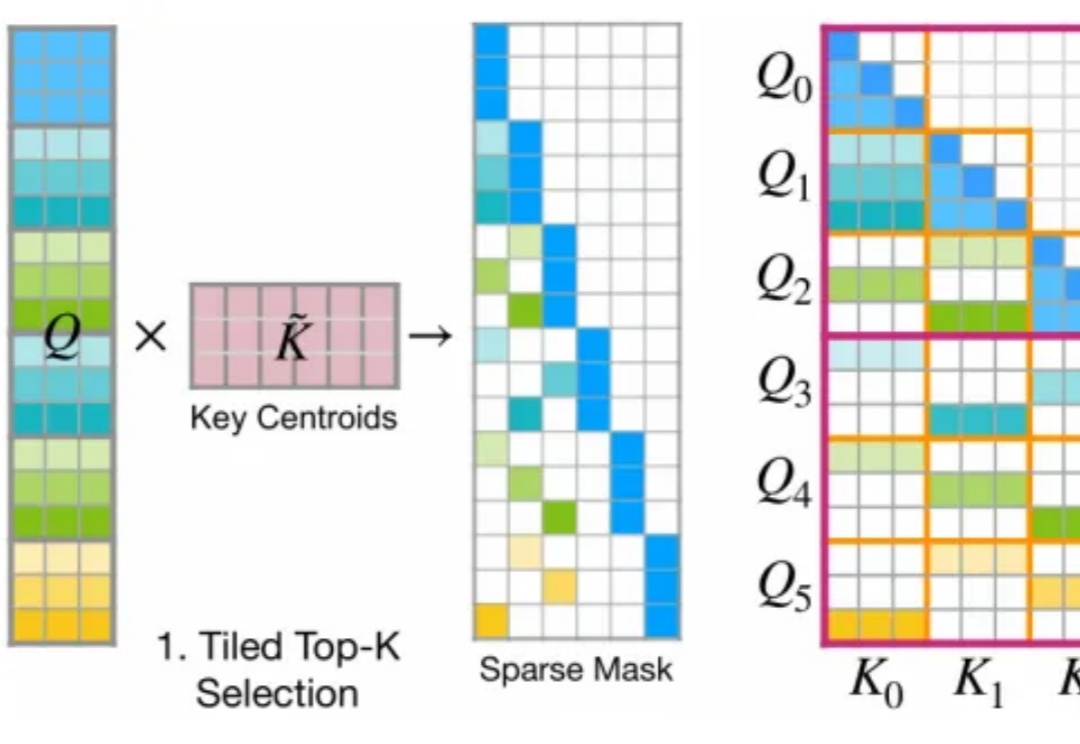
今年 2 月,月之暗面提出了一种名为 MoBA 的注意力机制,即 Mixture of Block Attention,可以直译为「块注意力混合」。
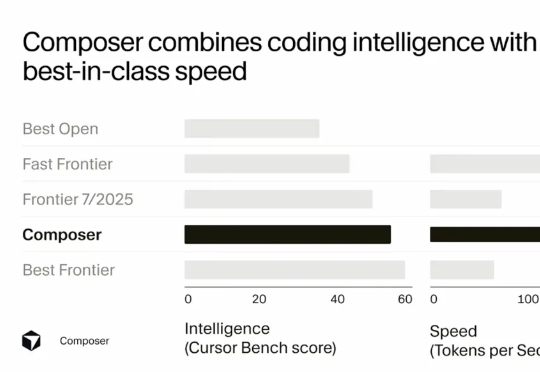
Sasha Rush 在分享开头就提到,Cursor Composer 在他们的内部 benchmark 上的表现几乎与最好的 Frontier 模型(前沿模型)持平,并且优于去年夏天发布的所有模型。它的表现明显好于最好的开源模型,以及那些被标榜为"快速"的模型。
谷歌世界模型大牛Danijar Hafner宣布离任!他自2016年起开始在Google Brain实习,后又在DeepMind、Brain Team工作。他的经历颇具传奇色彩,曾获辛顿指导,还与Łukasz Kaiser、Ashish Vaswani等Transformer大佬有过交集。
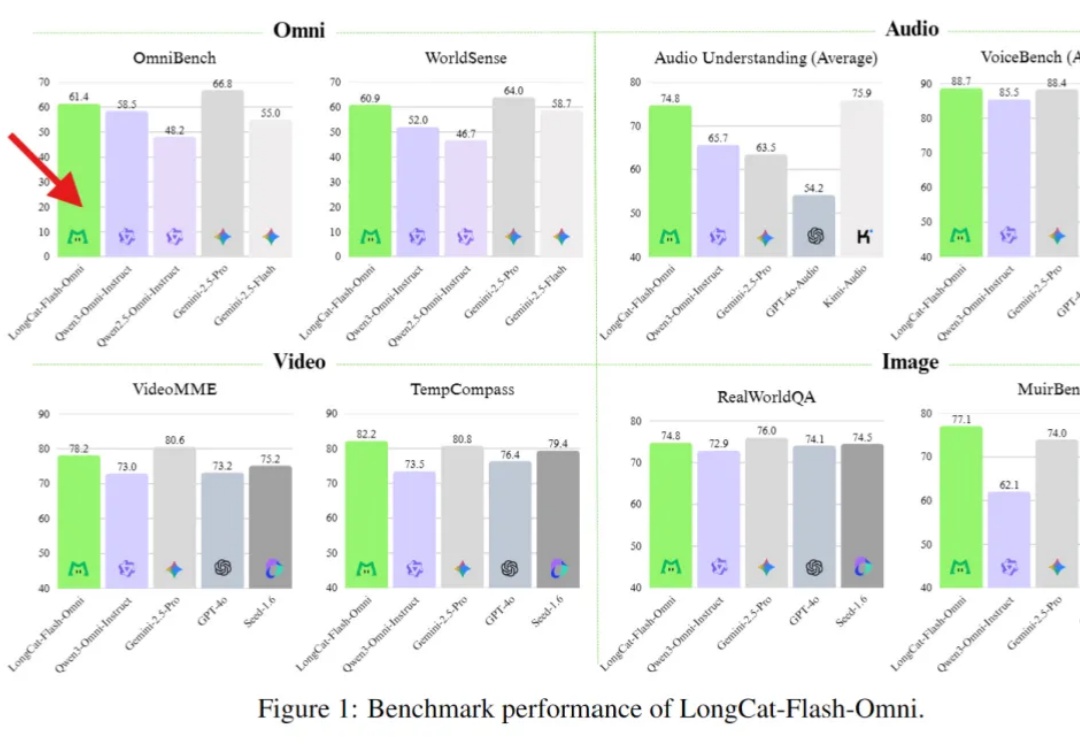
昨天一大早,就发现美团开源了他们首款全模态实时交互大模型:LongCat-Flash-Omni。
用外卖的打法做AI模型?美团这是跟“又快又稳”杠上了(doge)。
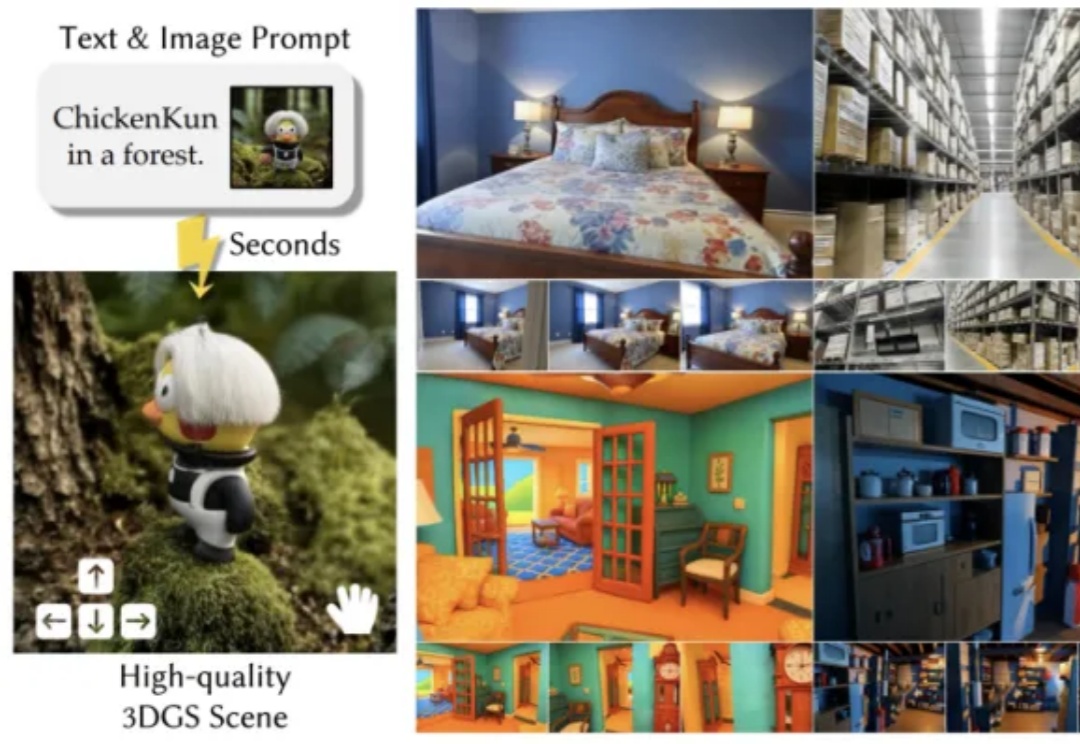
厦门大学和腾讯合作的最新论文《FlashWorld: High-quality 3D Scene Generation within Seconds》获得了海内外的广泛关注,在当日 Huggingface Daily Paper 榜单位列第一,并在 X 上获得 AK、Midjourney 创始人、SuperSplat 创始人等 AI 大佬点赞转发。
从数据上看,Ashby 的增长轨迹令人印象深刻。在短短一年多时间里,他们的客户数量从 1300 家翻倍增长到超过 2700 家,年收入增长了 135%,面试安排量增长了 170%。更让我感到惊讶的是,他们的燃烧倍数控制在 1 倍以下,这在当前的市场环境下是极其难得的。
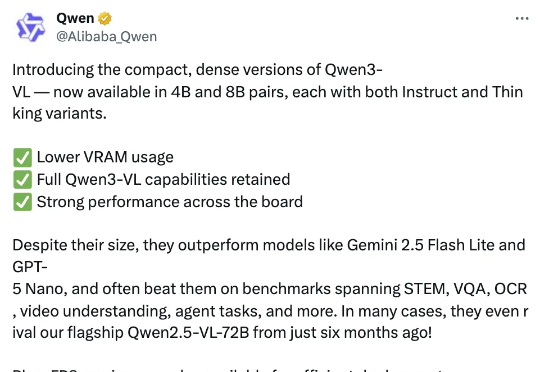
智东西10月15日报道,今日,阿里通义千问团队推出其最强视觉语言模型系列Qwen3-VL的4B与8B版本,两个尺寸均提供Instruct与Thinking版本,在几十项权威基准测评中超越Gemini 2.5 Flash Lite、GPT-5 Nano等同级别顶尖模型。