GPT-6-Astra具身能力遭大考!传统基准拿满分,真机频碰壁
GPT-6-Astra具身能力遭大考!传统基准拿满分,真机频碰壁上月发布 GPT-6-Astra 时,OpenAI 称它为「全球智能程度最高且最符合人类意图的模型」。具身社区则是惊讶的发现,VLA vs WAM 的路线之争,被通用大模型用文字模态「降维打击」了,大家不禁想问:
来自主题: AI技术研报
8484 点击 2026-10-20 12:19

 搜索
上月发布 GPT-6-Astra 时,OpenAI 称它为「全球智能程度最高且最符合人类意图的模型」。具身社区则是惊讶的发现,VLA vs WAM 的路线之争,被通用大模型用文字模态「降维打击」了,大家不禁想问:
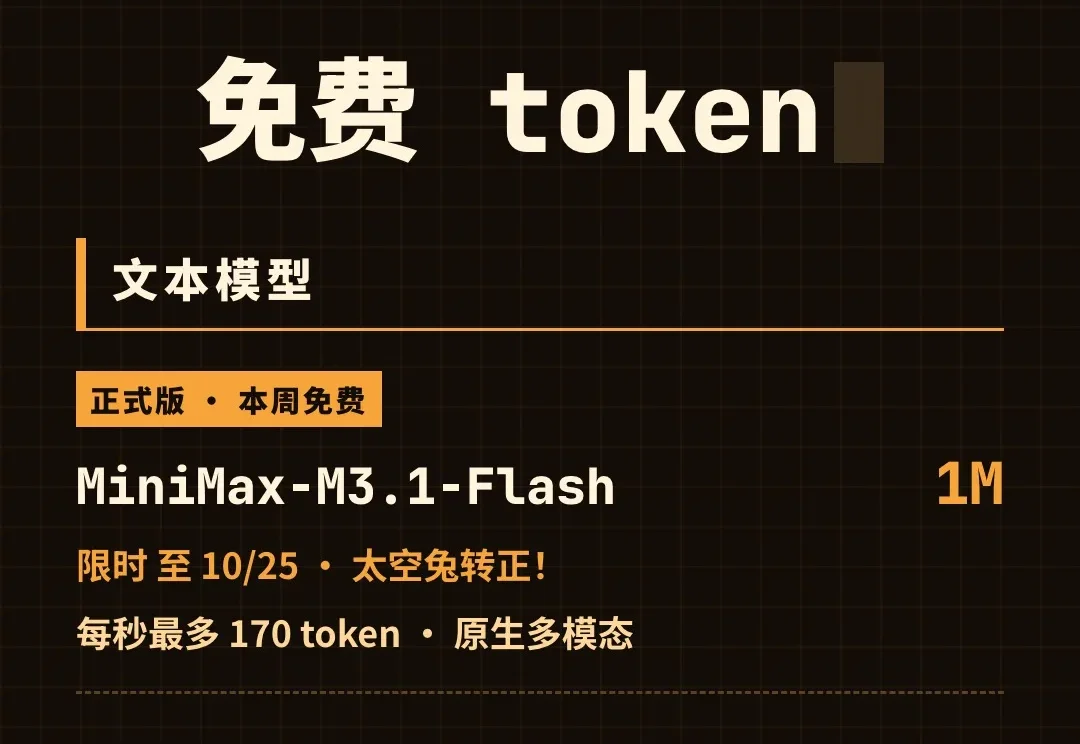
刚刚,MiniMax 正式发布了 M3.1 Flash
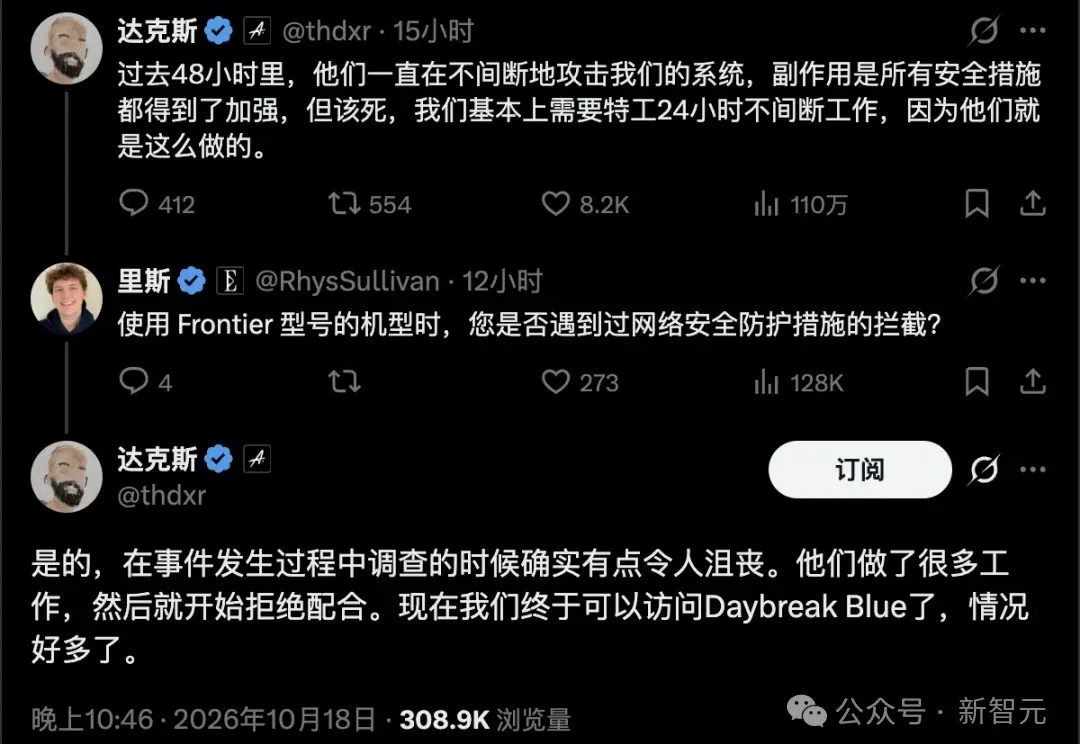
攻击还没停,防守AI却先「罢工」了!
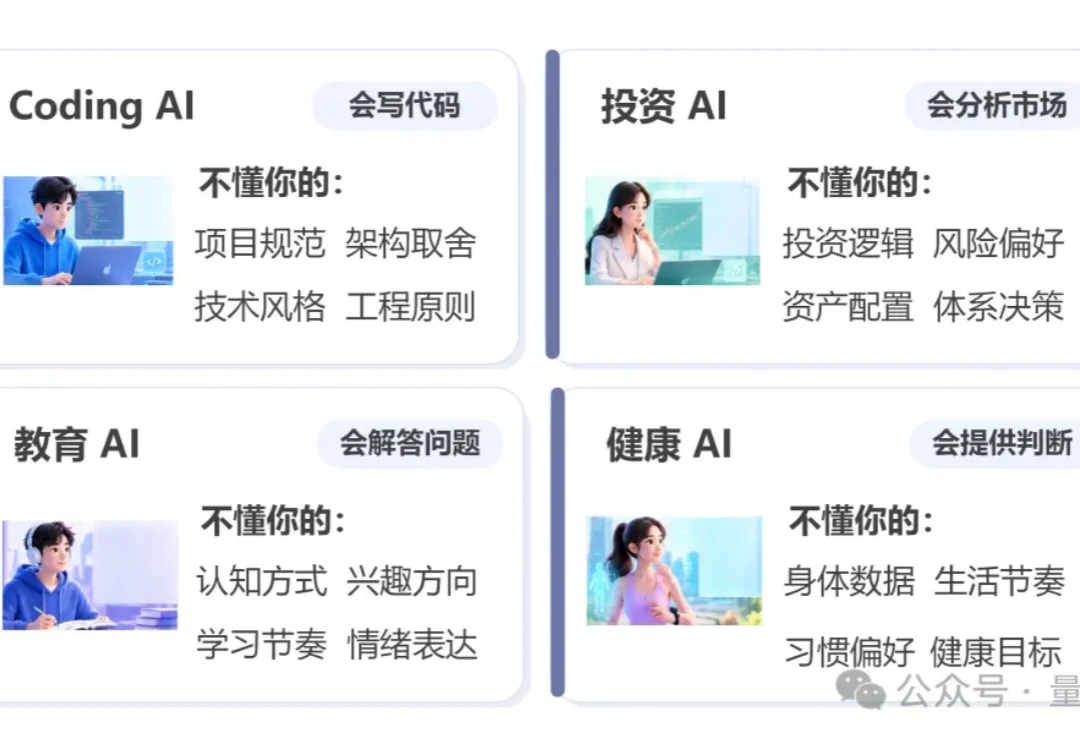
从通用模型到个性化智能,人工智能的竞争正在向长期学习与专属能力沉淀延伸。
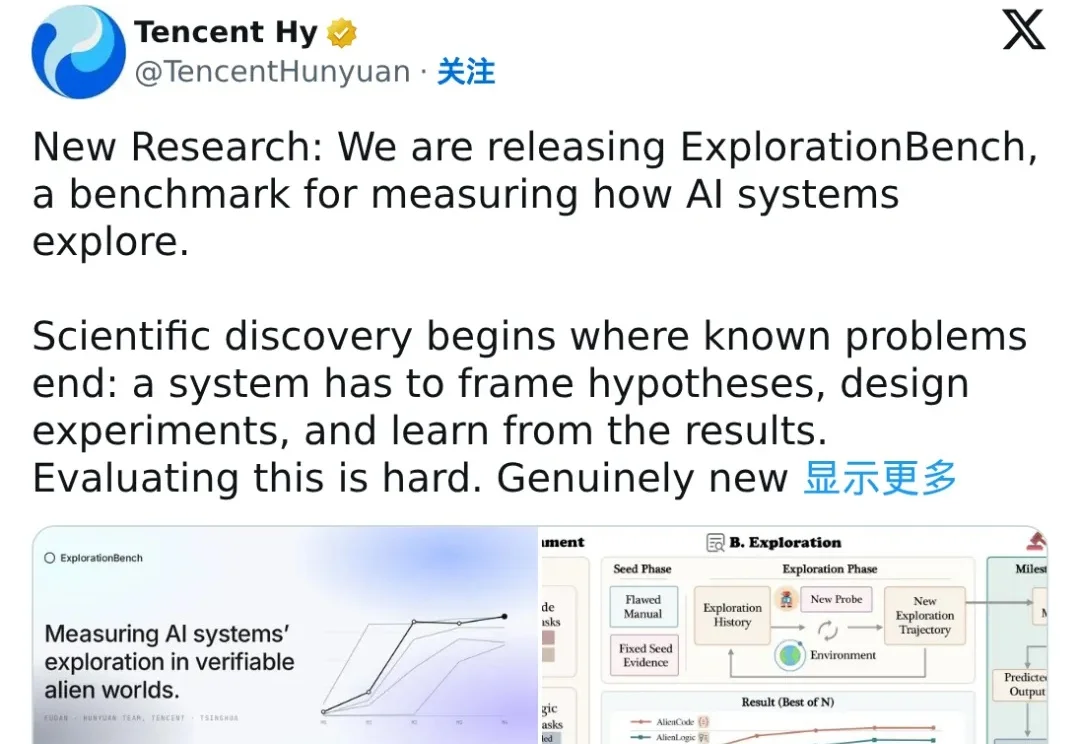
近日,腾讯混元官方账号(@TencentHunyuan)在 X 上发布了一项新研究:ExplorationBench,一个专门衡量 AI 系统如何「探索」的评测基准;随后,腾讯 AI 官方账号(@TencentAI_News)也发文进行了专题推介。
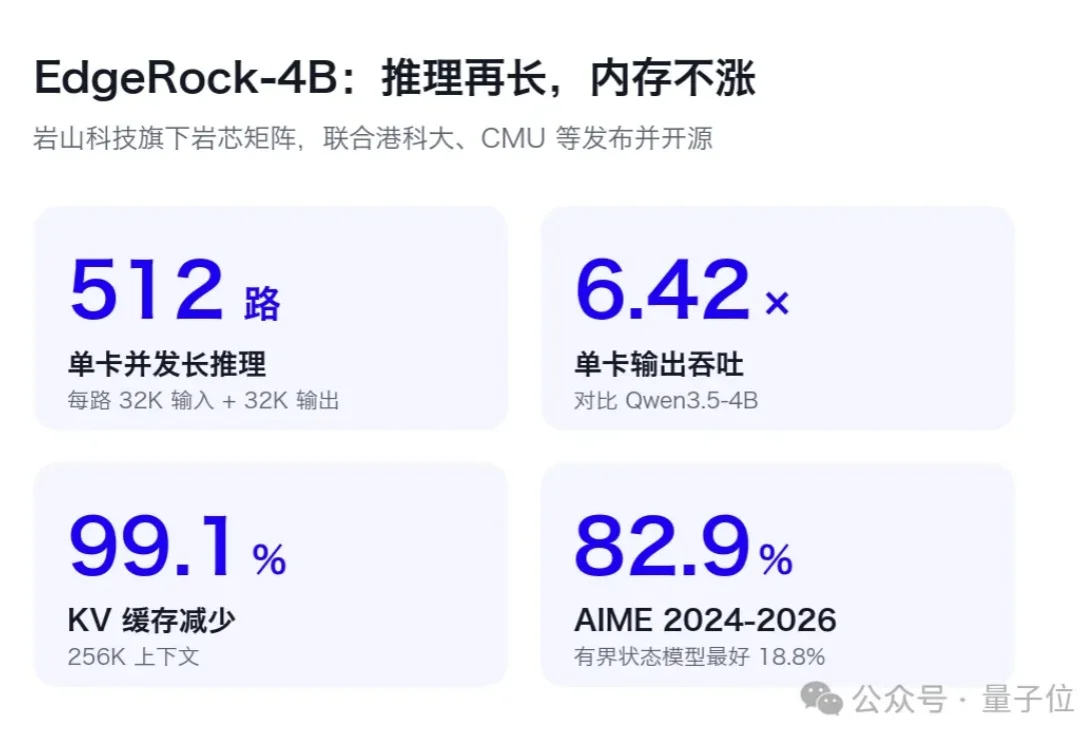
谷歌今年的一篇论文,愣是把存储芯片巨头的股价都给整出动静了。
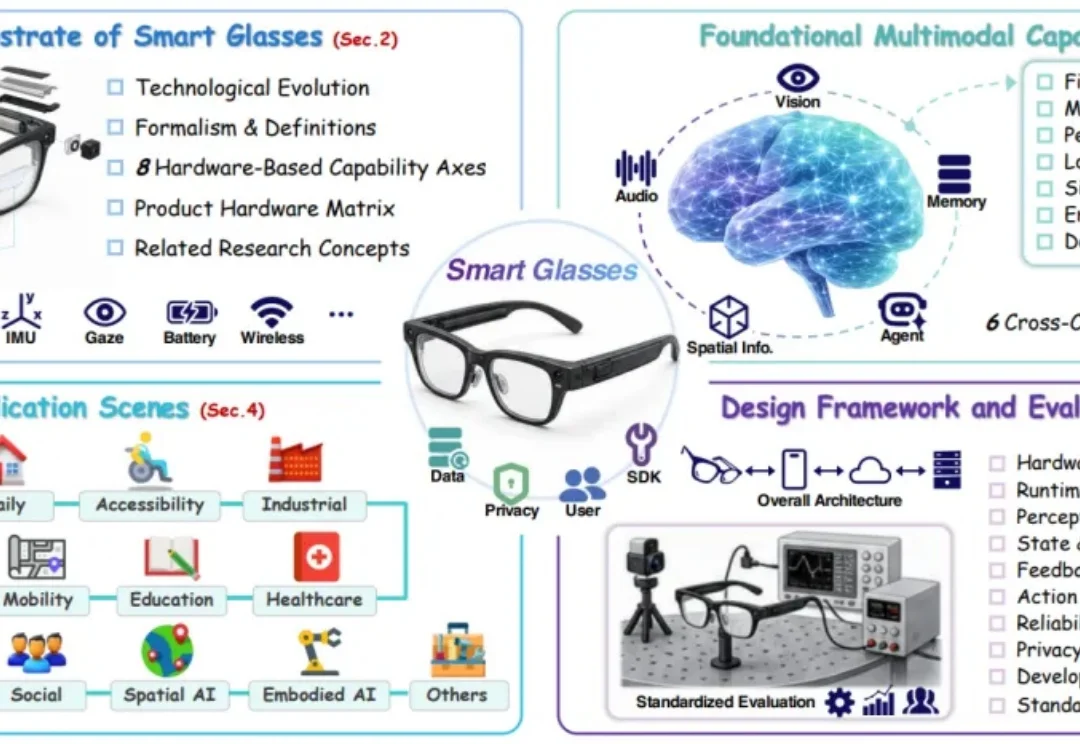
当我们谈论智能眼镜时,许多人的第一反应仍是:它能不能拍照、放歌、导航,或者它就像一个戴在头上的语音助手?
就在刚刚,Anthropic给出惊人预测—— 到2030年,AI或将让美国GDP飙升至44万亿美元。
永远不要相信 DeepSeek 的 “a minor update” (小更新)。
Agent在真实任务中出错,工程师的第一反应往往是给Harness“打补丁”:加一条防错提示词、接入一个新工具、挂一套Skills,或者增加历史摘要和执行检查。这套负责协调模型调用、工具执行与上下文管理的外层系统,就是Agent Harness。