
# 热门搜索 #
大模型
人工智能
openai
融资
chatGPT
当 AI Agent 开始替人读网页、做研究、跑自动化流程时,行业真正的瓶颈已经从“模型能力本身”,变成了“它能不能在正确的时间拿到正确、干净、足量的信息”。
众所周知,Deep Research、浏览器 Agent、各类自动化工作流,本质上都在做同一件事——替人去读网页。可今天的网页是为人眼设计的:导航、广告、弹窗、脚本、动态渲染……人一眼就能略过,模型却要为每一个无效 Token 买单。更棘手的是时效——模型的记忆停在过去,而 Agent 要回答的是此刻。
所以对于 Agent 来说:一是要筛出干净内容,二是要找到最新信息。
于是,一个新的基础设施层正在成形:面向 AI 的 Web 接口。
Dataify 这次发布的 AI Web API 1.0,切入的正是这一层。
接下来进入实测环节。
先展示大家最关心的指标,然后再测:

三个接口实测下来,我最直观的感受是:搜索结果带着标题、摘要和来源,正文能按需转成 Markdown,站点页面也能先整理成清单。对使用者来说,拿到结果后继续筛选、阅读和处理,路径比较清楚。
功能1 Search API
Search 通过 unique_id=search_web 指定工具,用 query 传入关键词,source 指定搜索类型(示例为 web),再由 max_results、country、language 控制返回数量与地区语言。
输入 · Python
import os
import requests
url = "https://aiwebapi.dataify.com/search"
headers = {
"Authorization": f"Bearer {os.environ['DATAIFY_API_TOKEN']}",
"Content-Type": "application/x-www-form-urlencoded",
}
data = [
("unique_id", "search_web"),
("query", "什么是AI?"),
("source", "web"),
("max_results", "3"),
("country", "us"),
("language", "en"),
("extract_content", "false"),
]
response = requests.post(url, headers=headers, data=data)
print(response.status_code)
print(response.text)
响应示例 · JSON
[
{
"position":1,
"title":"什么是人工智能(AI)?",
"url":"https://cloud.google.com/learn/what-is-artificial-intelligence?hl=zh-CN",
"snippet":"人工智能(AI) 是一组技术,使计算机能够学习、推理并执行各种高级任务……"
},
{
"position":2,
"title":"1-1. AI 是什麼?|你的第一堂AI 課",
"url":"https://www.youtube.com/watch?v=JKLdpfdhRnc",
"snippet":"歡迎來到「全民AI 通識課」!……用簡單的方式定義AI,其實就是AI系統了!",
"date":"2 years ago"
},
{
"position":3,
"title":"什么是人工智能(AI)?",
"url":"https://aws.amazon.com/cn/what-is/artificial-intelligence/",
"snippet":"人工智能(AI)是一项变革性技术,它使机器能够和人类一样解决问题……"
}
]
直接返回经去重、排序的数组,每条包含 title、url、snippet,部分结果还会带 date。
把 extract_content 设为 true 时,还可以在搜索结果中一并取回正文,使用者不必再分别拼接“搜索 API+网页采集+正文解析”三套流程。搜索不再只是返回一串 URL,而可以直接成为内容处理的起点。
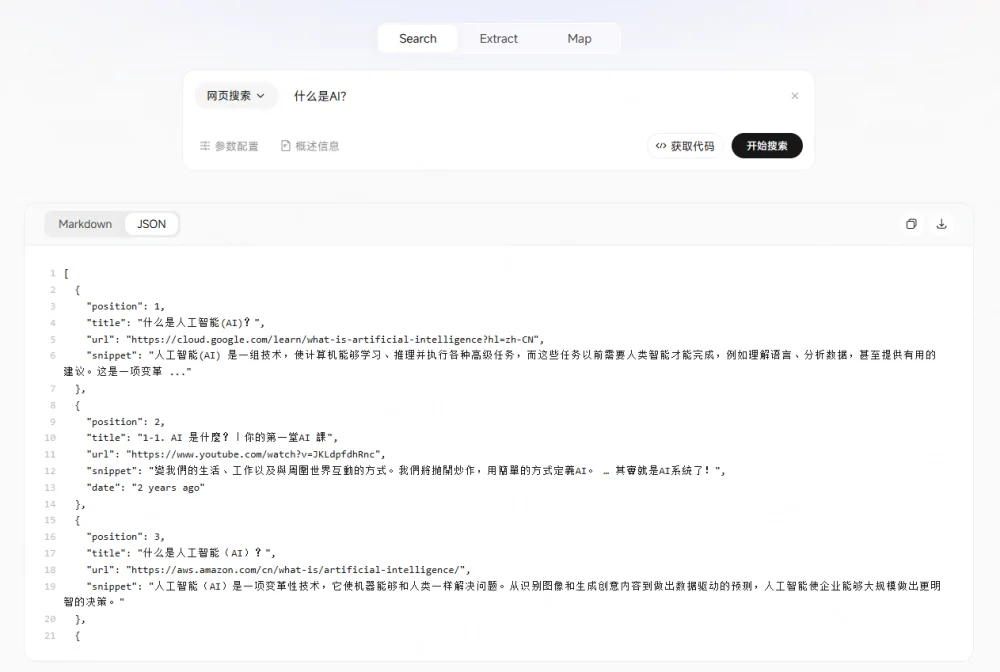
图 1|Search 控制台返回结果(JSON 视图)
功能2 Extract API
找到页面之后,下一个问题是:网页到底该怎么读?
如果把完整 HTML 直接塞给模型,导航栏、按钮、脚本和页脚也会一起进入上下文。信息不少,真正有用的内容却可能只有一部分。
Extract 的思路很直接:传入 URL,按任务选择需要的内容形式。
目前支持提取 Markdown、原始 HTML、清洗后的 HTML 和页面链接;开启 only_main_content 后,可以进一步聚焦正文区域。
以抓取dataify.com为例:
输入 · Python
import os
import requests
url = "https://aiwebapi.dataify.com/extract"
headers = {
"Authorization": f"Bearer {os.environ['DATAIFY_API_TOKEN']}",
"Content-Type": "application/x-www-form-urlencoded",
}
data = [
("unique_id", "extract"),
("url", "https://dataify.com/"),
("formats", "markdown"),
("formats", "raw_html"),
("formats", "clean_html"),
("formats", "links"),
("advanced_mode", "true"),
("country", "US"),
("only_main_content", "true"),
("timeout_ms", "60000"),
("wait_for_ms", "0"),
("max_age_ms", "172800000"),
]
response = requests.post(url, headers=headers, data=data)
print(response.status_code)
print(response.text)
响应示例 · Markdown(节选)
# 让 AI 看见此刻世界
Dataify 将最新的网页清洗为结构化数据,让智能体的回答有据可依
[开始免费试用](https://dashboard.dataify.com/web-api?tool=search)
在
Agent 中使用
SearchExtractMap
示例:
AI 领域的最新新闻 AI 开发工具 AI 行业动态
正在请求
…
MarkdownJSON
## AI Web API . Search
Search根据关键词检索相关网页,为 AI Agent 提供实时数据
[立即体验](https://dashboard.dataify.com/web-api?tool=search)
…(后略:完整返回还包含该页面的其他正文与链接)
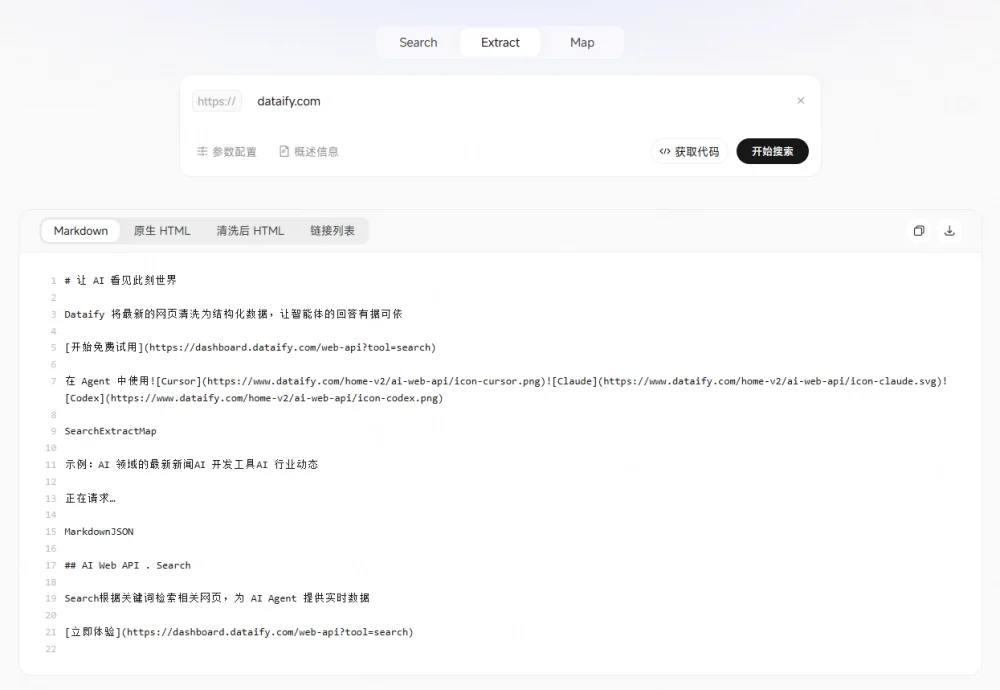
图 2|Extract 控制台返回结果(Markdown 视图)
从返回看,页面内容已经转成 Markdown,省去了自行解析 HTML 的步骤。示例中仍保留了“正在请求…”等界面文字,使用时可以继续按任务筛选。
这些内容可以交给模型总结,或在应用侧继续切片、向量化和入库;返回的页面链接也能作为后续采集入口。
功能3 Map API
Extract 提取单页内容,Map 则帮助发现站点中的页面。
输入一个起始 URL,Map 可以发现站点内的页面地址、标题和描述。通过 domain_filter、limit 和 sitemap 等参数,还能控制发现范围、数量及站点地图的使用方式。
它适合处理另一类问题:“这个文档站里到底有哪些页面”。
比如搭建产品文档知识库时,可以先用 Map 找到页面入口,再逐页调用 Extract 提取正文;做竞品研究时,也可以先盘点官网内容,再选择需要深入分析的页面。
以抓取dataify.com为例:
输入 · Python
import os
import requests
url = "https://aiwebapi.dataify.com/map"
headers = {
"Authorization": f"Bearer {os.environ['DATAIFY_API_TOKEN']}",
"Content-Type": "application/x-www-form-urlencoded",
}
data = [
("unique_id", "map"),
("url", "https://dataify.com"),
("country", "US"),
("domain_filter", "all"),
("limit", "20"),
("sitemap", "include"),
]
response = requests.post(url, headers=headers, data=data)
print(response.status_code)
print(response.text)
响应示例 · Links 视图
https://dataify.com/
https://www.dataify.com/
https://www.dataify.com/about
https://www.dataify.com/careers
https://www.dataify.com/products/dataset/store/dataset-shein
https://www.dataify.com/products/dataset/store/dataset-linkedin_company_v2
https://www.dataify.com/products/dataset/store/dataset-linkedin_prospect_v2
https://www.dataify.com/products/dataset/store/dataset-walmart_products
https://www.dataify.com/products/dataset/store/dataset-instagram_video_info
https://www.dataify.com/products/dataset/store/dataset-youtube_videos
https://www.dataify.com/products/dataset/store/dataset-tiktok_post_v2
https://www.dataify.com/products/dataset/store/dataset-netflix
https://www.dataify.com/products/dataset/store/dataset-tiktok_shop
https://www.dataify.com/products/dataset/store/dataset-tiktok_goods
https://www.dataify.com/products/dataset/store/dataset-vimeo_user_result
控制台的 Links 视图把结果按行展示;API 原始响应为 JSON 数组 [{"url": "..."}],返回上限由 limit 控制。
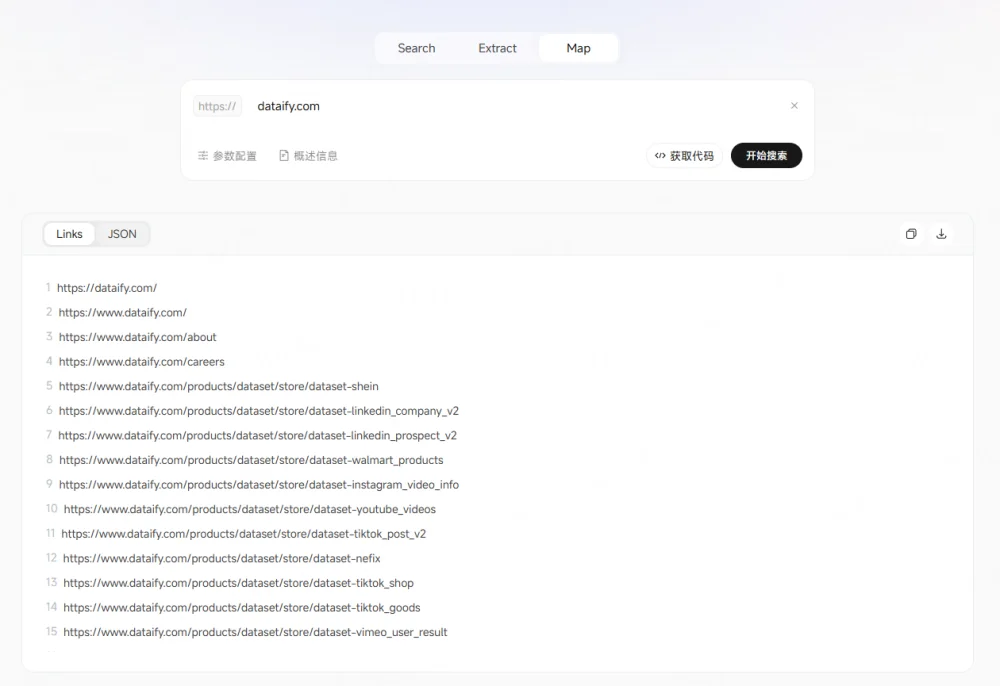
图 3|Map 控制台返回结果(Links 视图)
到这里,三项能力的分工就清楚了:
Search 检索相关网页,Extract 提取页面内容,Map 发现站点页面。
大模型厂商
RL 强化学习阶段
在需要联网检索的强化学习任务中,用 Search 查找相关网页,再按需提取正文,为模型训练信息检索、证据使用与复杂任务求解能力提供数据支持。
AI Agent 厂商
RAG 预检索增强阶段
按需提取干净正文,为 Agent 补充更新、更集中的参考内容,提升信息质量与时效性。
具体到运行过程,使用者提出问题后,Agent 先判断是否需要补充实时信息;需要时调用 Search 检索相关网页,并按需调用 Extract 提取正文,将经去重、重排与清洗后的数据用于Agent 后续推理与回答。
Dataify AI Web API 为 AI Agent 和 AI 应用提供实时、结构化、可接入的公开网页数据能力,并通过 MCP/Skills 与多模态数据服务,帮助团队更快把外部数据转化为可用数据资产。
当然,1.0 只是这条路的起点。期待后续版本在结构化输出、批量调度和更多数据源上继续演进,把“让 AI 看见此刻世界”这件事做深做透——AI 迟早都需要这样一条实时数据链路,祝 Dataify 把它做扎实、走得更远。
如果你正在做 Agent、行业研究工具或 RAG 知识库,你会如何利用 AI Web API?
如果你正在为大模型训练或 AI Agent 应用寻找干净、实时的网页数据,想进一步沟通测试需求与接入方案,可以联系 Dataify 团队:
Dataify 客户发展总监:Senlina
微信号:lisiyuDZML
文章来自于"CSDN",作者 "CSDN"。

【开源免费】Browser-use 是一个用户AI代理直接可以控制浏览器的工具。它能够让AI 自动执行浏览器中的各种任务,如比较价格、添加购物车、回复各种社交媒体等。
项目地址:https://github.com/browser-use/browser-use
【开源免费】字节工作流产品扣子两大核心业务:Coze Studio(扣子开发平台)和 Coze Loop(扣子罗盘)全面开源,而且采用的是 Apache 2.0 许可证,支持商用!
项目地址:https://github.com/coze-dev/coze-studio
【开源免费】n8n是一个可以自定义工作流的AI项目,它提供了200个工作节点来帮助用户实现工作流的编排。
项目地址:https://github.com/n8n-io/n8n
在线使用:https://n8n.io/(付费)
【开源免费】DB-GPT是一个AI原生数据应用开发框架,它提供开发多模型管理(SMMF)、Text2SQL效果优化、RAG框架以及优化、Multi-Agents框架协作、AWEL(智能体工作流编排)等多种技术能力,让围绕数据库构建大模型应用更简单、更方便。
项目地址:https://github.com/eosphoros-ai/DB-GPT?tab=readme-ov-file
【开源免费】VectorVein是一个不需要任何编程基础,任何人都能用的AI工作流编辑工具。你可以将复杂的工作分解成多个步骤,并通过VectorVein固定并让AI依次完成。VectorVein是字节coze的平替产品。
项目地址:https://github.com/AndersonBY/vector-vein?tab=readme-ov-file
在线使用:https://vectorvein.ai/(付费)
【开源免费】AutoGPT是一个允许用户创建和运行智能体的(AI Agents)项目。用户创建的智能体能够自动执行各种任务,从而让AI有步骤的去解决实际问题。
项目地址:https://github.com/Significant-Gravitas/AutoGPT
【开源免费】MetaGPT是一个“软件开发公司”的智能体项目,只需要输入一句话的老板需求,MetaGPT即可输出用户故事 / 竞品分析 / 需求 / 数据结构 / APIs / 文件等软件开发的相关内容。MetaGPT内置了各种AI角色,包括产品经理 / 架构师 / 项目经理 / 工程师,MetaGPT提供了一个精心调配的软件公司研发全过程的SOP。
项目地址:https://github.com/geekan/MetaGPT/blob/main/docs/README_CN.md
【开源免费】FASTGPT是基于LLM的知识库开源项目,提供开箱即用的数据处理、模型调用等能力。整体功能和“Dify”“RAGFlow”项目类似。很多接入微信,飞书的AI项目都基于该项目二次开发。
项目地址:https://github.com/labring/FastGPT
【开源免费】graphrag是微软推出的RAG项目,与传统的通过 RAG 方法使用向量相似性作为搜索技术不同,GraphRAG是使用知识图谱在推理复杂信息时大幅提高问答性能。
项目地址:https://github.com/microsoft/graphrag
【开源免费】Dify是最早一批实现RAG,Agent,模型管理等一站式AI开发的工具平台,并且项目方一直持续维护。其中在任务编排方面相对领先对手,可以帮助研发实现像字节扣子那样的功能。
项目地址:https://github.com/langgenius/dify
【开源免费】RAGFlow是和Dify类似的开源项目,该项目在大文件解析方面做的更出色,拓展编排方面相对弱一些。
项目地址:https://github.com/infiniflow/ragflow/tree/main
【开源免费】phidata是一个可以实现将数据转化成向量存储,并通过AI实现RAG功能的项目
项目地址:https://github.com/phidatahq/phidata
【开源免费】TaskingAI 是一个提供RAG,Agent,大模型管理等AI项目开发的工具平台,比LangChain更强大的中间件AI平台工具。
项目地址:https://github.com/TaskingAI/TaskingAI
